手机微信扫一扫联系客服
联系电话:18046269997


 APP安装免填邀请码
 社交分享效果统计
 广告投放数据统计
 CPA/CPS推广效果统计
 App地推统计
 App拉起
 网页/应用内直接安装
 Android多渠道打包
 App安装后自动绑定
 App分享效果统计
 Deeplink深度链接
手机微信扫一扫联系客服
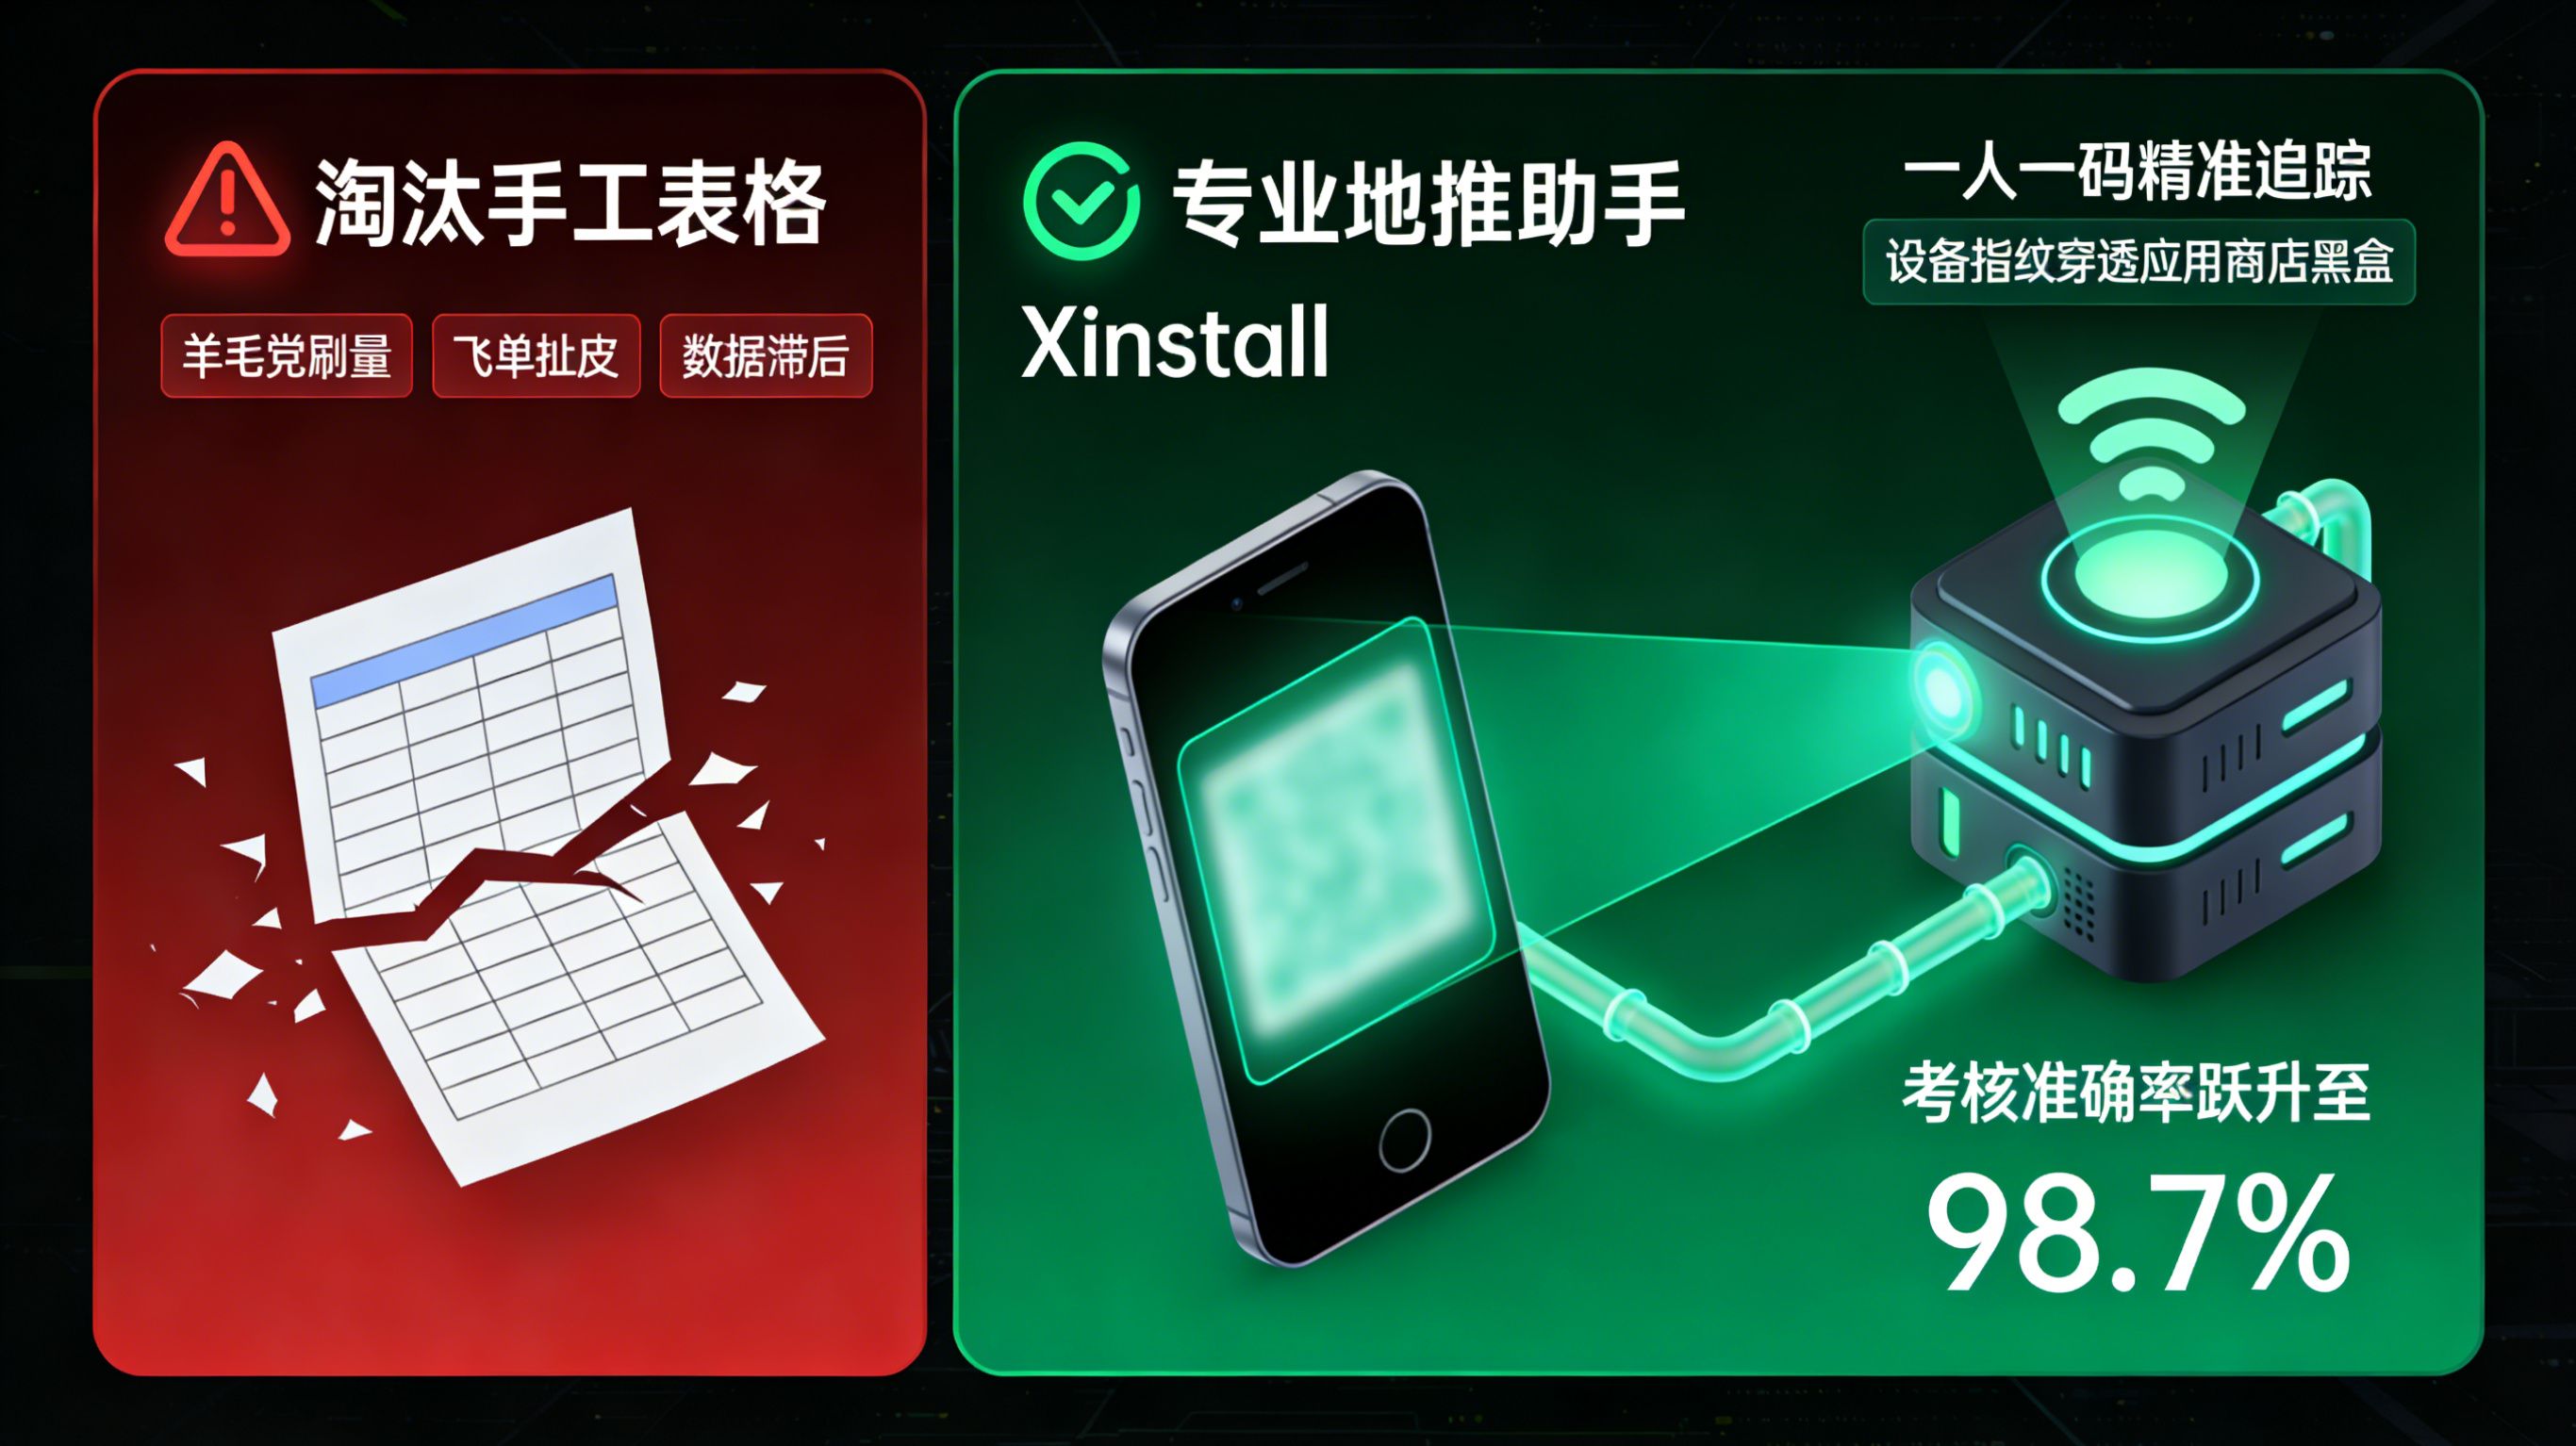
线下推广数据统计工具推荐?随着线上流量成本的见顶,越来越多的 App 和品牌重新组建地推铁军走向线下,但随之而来的业绩核算与刷量防范成了管理者的噩梦。传统的线下推广高度依赖手工报表与人工盯防,极易导致数据滞后、飞单与羊毛党刷量。优秀的线下推广数据统计工具不应该只是登记信息的静态表单,而必须是基于设备指纹与“一人一码”技术的专业地推助手。它能穿透应用商店的黑盒,实现从用户扫码到 App 激活、乃至后端付费的全自动追踪。本文将深入对比传统表单工具与专业地推助手在多门店场景下的优劣差异,拆解高精度统计背后的防作弊机制,并结合实体连锁门店案例,展示如何用 Xinstall 等专业工具将地推考核准确率提升至 98.7%。线下团队为何急需淘汰“手工表格”?在线下拓客场景中,很多初创团队为了省事,依然沿用让客户填表、或者扫码后手工输入地推专员“邀请码”的原始方式。这种看似零成本的管理模式,实际上正在给企业带来高昂的隐性亏损。关于手工管理模式对 O2O 数字化进程的阻碍,您可以参考 O2O 门店数字化与地推精细化管理报告 中的行业调研,了解数字化升级对降低隐性成本的重要性。虚假业绩与羊毛党的双重重击传统的手工填码方式给了地推人员极大的操作空间。在“按激活量结算提成”的诱惑下,部分缺乏职业操守的推广员会将自己的邀请码发到网上的兼职群、羊毛群,甚至使用群控设备和模拟器刷出海量的虚假激活。企业花了大价钱发底薪和提成,换来的却是一堆次日留存率为零的“死粉”,营销预算直接打了水漂。业绩归属扯皮:飞单与抢单在商场、步行街等高密度人群场景下,多个地推员往往会接触到同一个潜在客户。由于手工登记存在时间差,或者客户嫌麻烦直接跳过了填码步骤,导致“谁开发、谁获益”的规则失效。一旦出现无主订单或归属争议,团队内部极易引发飞单、抢单等恶性竞争,严重消耗团队士气。数据滞后带来的管理盲区依靠 Excel 汇报业绩,主管通常只能在第二天晚上甚至每周的例会上看到汇总数据。这种严重滞后的信息流,让管理者根本无法根据各个点位的实时获客转化率,去动态调整人员站位和宣传话术。一线的战斗变成了毫无战术章法的“盲打”。线下推广工具选型对决:传统表单 vs 专业地推助手要彻底解决上述痛点,企业在选型时必须明确传统 CRM/问卷表单与专业地推 SDK 工具的本质区别。前者只是“记录工具”,而后者是“追踪与风控引擎”。核心指标与适用场景对比对比维度传统登记系统(如问卷星/基础CRM)专业地推助手(如Xinstall)数据采集方式依赖客户手动填写手机号或业务员工号用户扫专属二维码,后台静默自动绑定归因准确率低(漏填、错填率极高,容易断链)极高(跨越应用商店,自动化指纹匹配)防作弊风控能力几乎为零(无法识别设备真伪)强(CTIT分析、设备指纹洗白拦截、IP预警)多级团队权限管理弱(全靠人工拉透视表拆分团队)强(总代、督导、地推员多级看板,实时查阅)适用推广场景简单的线索收集、静态名单登记App 推广下载、O2O门店引流、复杂链路转化为什么专业地推工具更适合 App 推广?如果你的推广目标是让用户下载 App 并完成注册,传统工具会显得非常无力。因为用户的下载行为必须经过苹果 App Store 或安卓应用商店,在这个“黑盒”里,传统表单的追踪参数会被完全清洗。只有专业的移动端统计工具,才能通过端云协同的底层技术,跨过应用商店的物理阻隔,打通从“线下扫码”到“线上打开 App”的数据闭环。优秀地推统计工具的核心能力拆解真正能称之为“地推神器”的统计工具,必然在渠道架构、特征匹配和风控引擎这三大核心能力上有着深厚的技术积淀。想深入理解底层架构是如何运作的,可以阅读 地推二维码统计怎么精准?一人一码追踪,掌握如何通过系统化配置消灭人工扯皮。无限生成“一人一码”的渠道架构告别手工填码的关键,在于“一人一码”机制。专业工具支持企业在后台为城市经理、督导、直至每一位一线地推员和导购,批量且无限次地生成带有动态参数的专属二维码。客户只需扫码一次,系统便会在云端把该客户与对应地推员死死绑定。地推员只需专注于引导扫码,再也不用追在客户屁股后面求着填工号。穿透应用商店的设备指纹匹配专业地推工具在客户扫码的瞬间,会在合规前提下采集其网络环境、屏幕分辨率、系统版本等非敏感特征,生成一个临时的“设备指纹”并暂存云端。当客户历经波折下载并打开 App 时,内置的 SDK 会再次生成指纹向云端发起比对。一旦特征高度吻合,系统就能瞬间识别出“这个新用户就是十分钟前扫了导购小王二维码的那个人”,从而实现高精度归因。精准拦截刷量的风控引擎针对地推场景特有的作弊手段,工具内置的风控引擎会实时扫描异常特征。例如,通过 CTIT(扫码到安装的时间差)分析,如果大量激活发生在扫码后的 1-2 秒内,系统会判定为机器刷量;如果识别到同一个底层硬件特征(哪怕重置了系统 ID)在短时间内反复触发首次激活,系统会自动拦截这种“洗白重装”行为,确保发出去的每一分佣金都对应真实的肉身用户。选型实战案例:某连锁门店的地推提效之战为了更直观地展示工具升级带来的业务价值,我们来看一家拥有 50 家实体门店的连锁健身品牌是如何打赢地推翻身仗的。类似连锁业态的落地实操与全生命周期追踪方案,可以在 门店效果统计该如何执行 中找到更加详细的配置指南。业务背景:盲目发传单导致获客成本失控该健身品牌推行全员营销策略,给所有门店的教练和会籍顾问发放了印有统一短链接的传单,并承诺“带来一个 App 激活奖励 20 元”。月底财务结账时发现,后台足足新增了数万个激活记录,但实际到店体验并核销卡券的用户转化率不足 3%。财务根本无法算清哪些激活是真实的、哪些是教练为了赚底薪自己去网上买的假量,获客成本处于严重失控边缘。方案落地:部署专业地推助手重构考核运营总监紧急叫停了原有模式,全面部署了类似 Xinstall 的专业地推助手。第一,废除统一传单,实行“一教练一码”,每个人的业绩独立挂钩;第二,后台开启高强度防作弊监控,开启 IP 聚集预警;第三,将结算指标从浅层的“激活”后置到“注册并完成实名认证”,必须有真实业务行为才算有效。显著成果:作弊清退与核算准确率提升新系统上线当月,风控引擎直接在后台亮起红灯:成功拦截了超 30% 集中在深夜特定 IP 段的机刷假量,公司以此为据清退了数名违规薅羊毛的员工。同时,每位教练都能通过手机实时查看到自己的真实拉新进度。经过两个月的运行,地推业绩考核的准确率跃升至 98.7%,以往月底财务团队熬夜对账的人工核算时间与管理成本大幅降低了约 42.6%,整个线下团队的战斗力和风气焕然一新。常见问题(FAQ)线下发出去的二维码传单,客户回家才扫还能统计到吗?可以统计到。专业工具生成的动态专属二维码是长期有效的。无论客户是在街上扫码,还是把传单塞进包里带回家再扫,只要他完成了扫码动作,系统就会记录当时的指纹和时间戳。即便扫码后隔了几个小时才去下载 App,只要在系统设置的合理归因窗口期内(通常为 1-24 小时),依然能精确匹配并把业绩算给发传单的业务员。如何防止地推人员拿自己的多部手机反复刷量?仅仅依靠限制 IP 和手机号是防不住职业黑产的。专业地推助手内置了设备防作弊 SDK,能够读取极其底层的硬件特征组合。即使地推人员通过断网切换 IP、使用改机软件重置系统标识(如 Android ID 或 IDFA),只要被风控引擎识别出是同一套物理硬件在进行高频操作,系统就会自动将其判定为作弊并剥夺业绩。门店导购离职,他的历史推广数据和专属二维码怎么交接?这是连锁门店管理的高频痛点。优秀的系统后台支持灵活的渠道迁移机制。管理员可以一键冻结离职员工的专属二维码,防止其在外继续散发造成客诉;更重要的是,能够将该二维码带来的后续长尾流量,以及历史的客户绑定关系,“整体平移”到新接手的员工或门店主管名下,确保业绩归属不断档、不流失。参考资料与选型说明本文详细拆解了线下推广数据统计工具的选型逻辑,深入对比了传统手工表单与专业地推助手在数据采集、归因精度及防作弊风控等维度的本质差异。对于依赖线下铁军获客的 O2O、本地生活及金融零售类企业,强烈建议在业务起步阶段就引入支持“一人一码”和设备指纹校验的专业移动统计工具。这不仅能斩断内部的刷量黑手,更能通过实时透明的业绩反馈,彻底激活一线团队的推广潜能。
 774
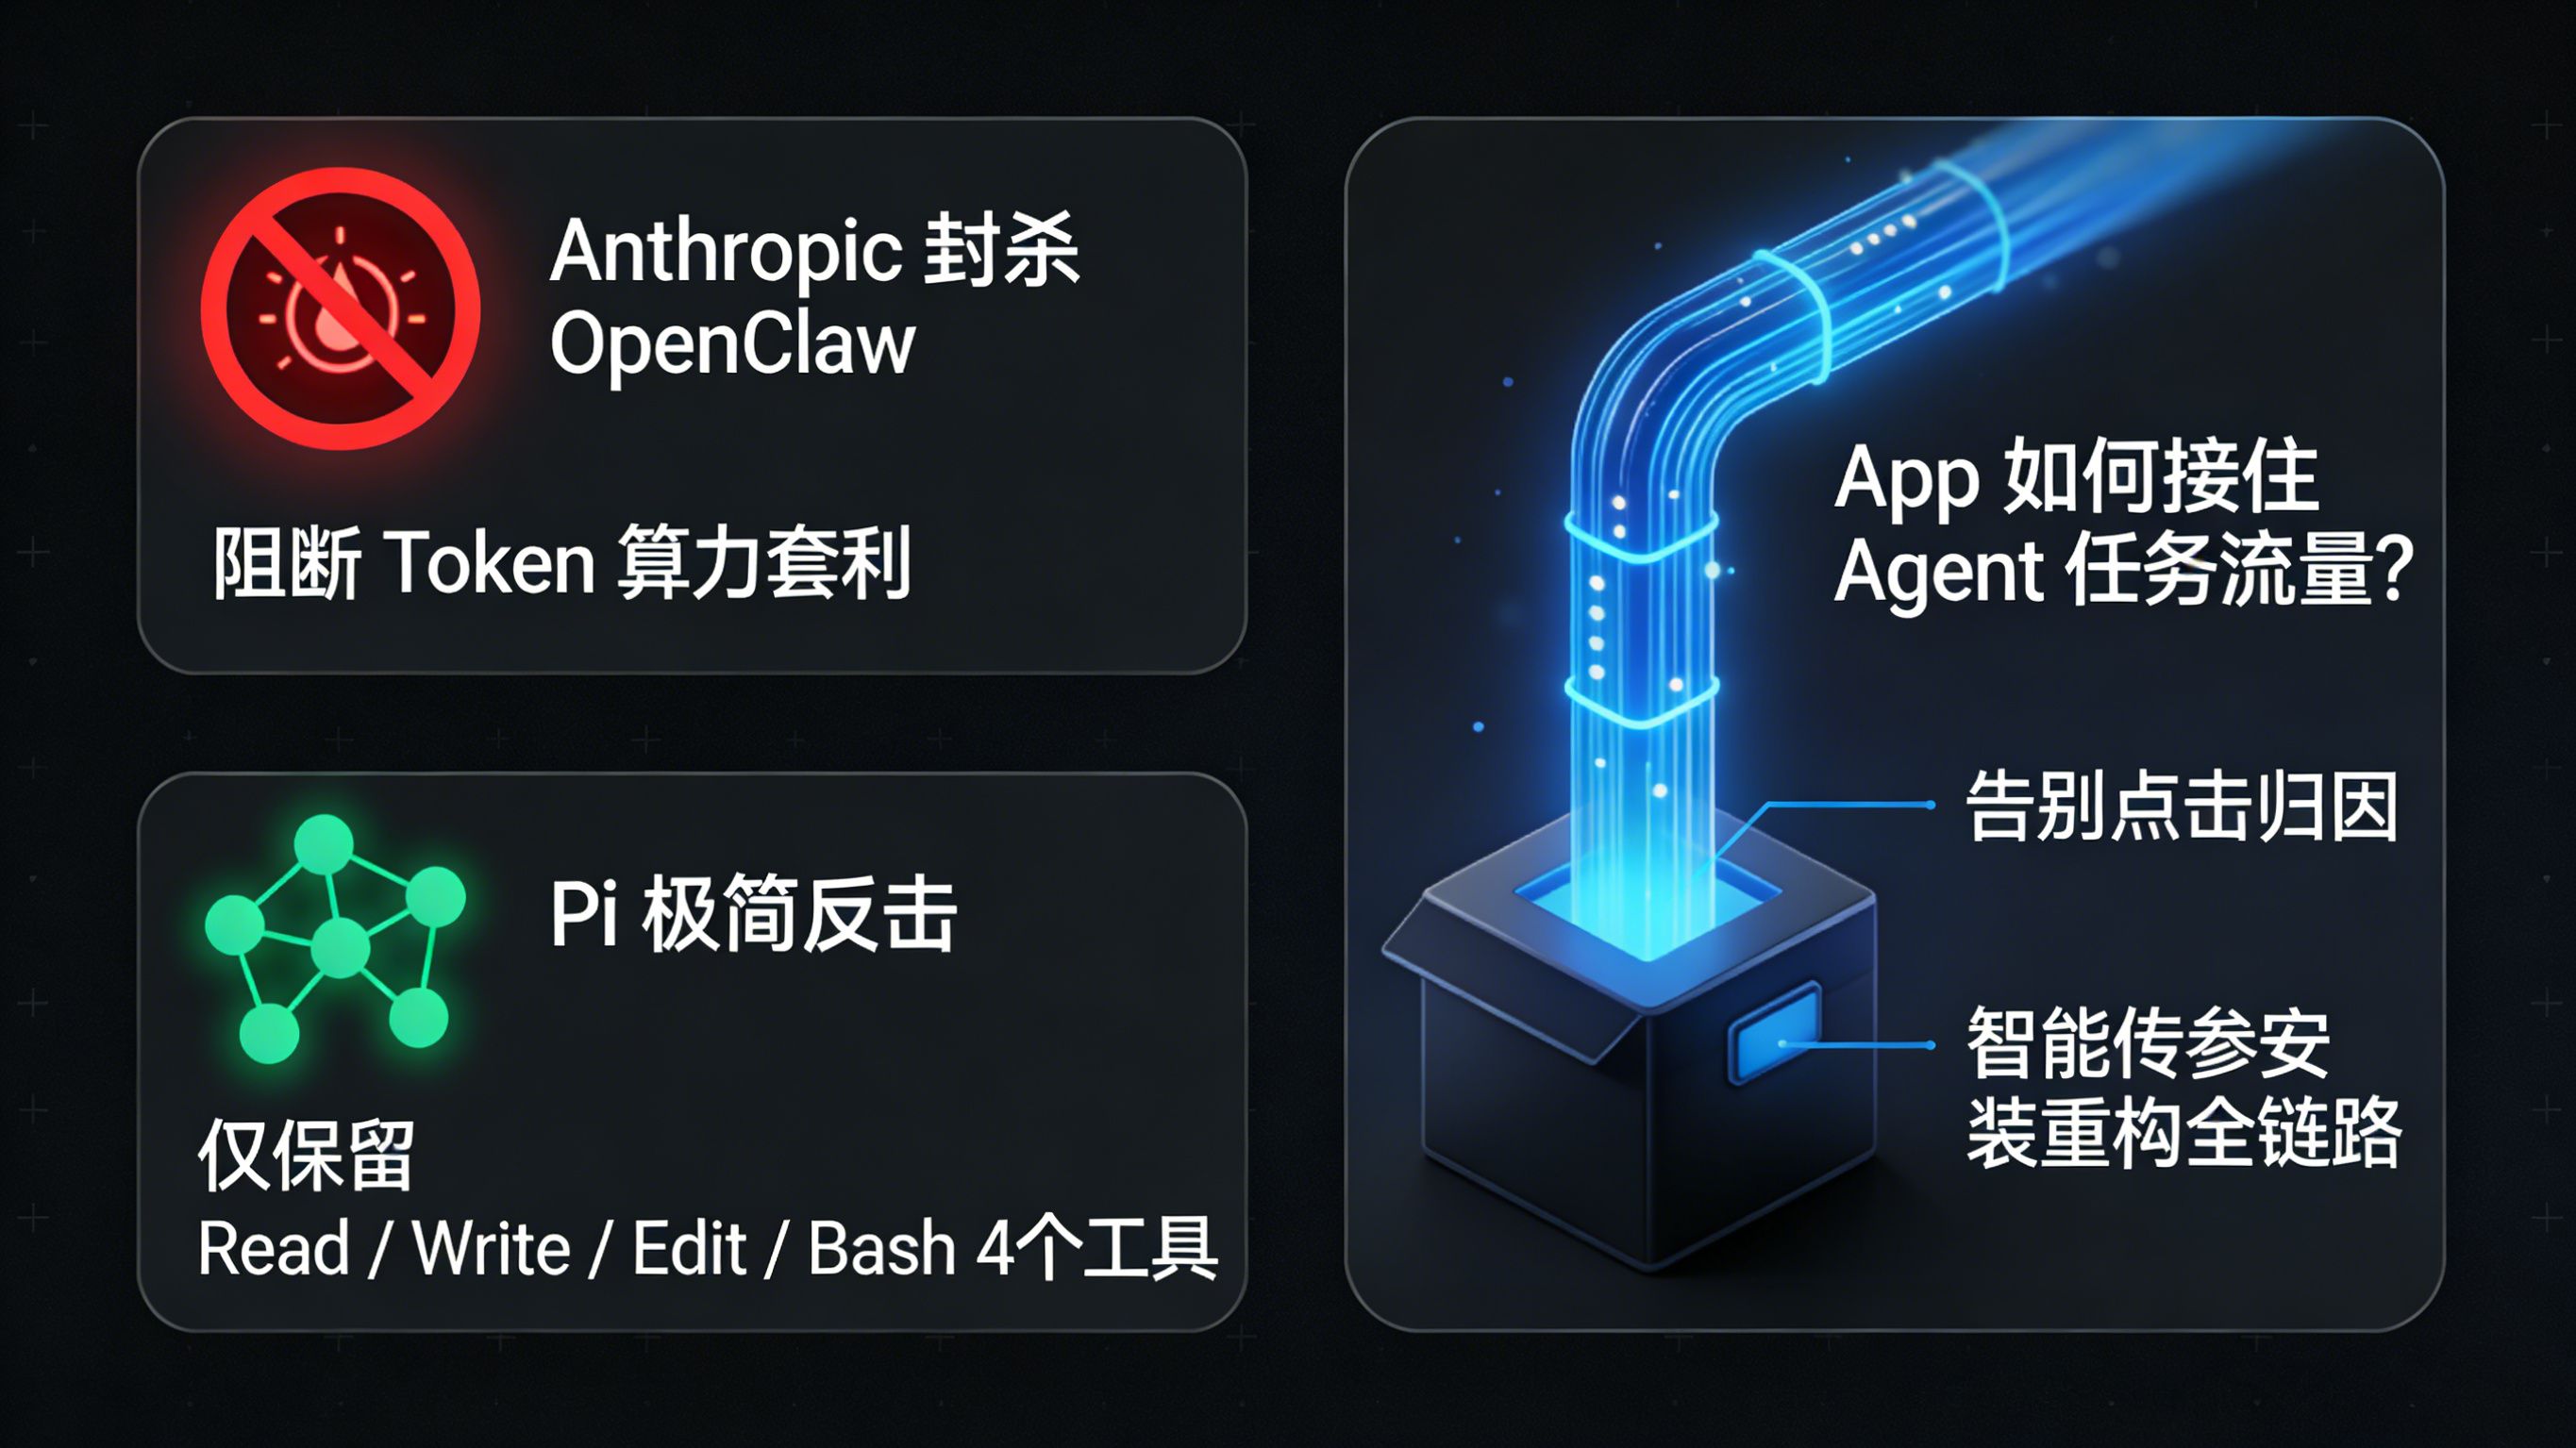
当硅谷明星 AI 巨头 Anthropic 突然宣布封杀大热的开源工具 OpenClaw 时,整个开发者社区的焦点不仅停留在“算力套利”的商业博弈上,更引出了一场关于 AI Agent 底层架构的深刻反思。一边是代码量庞大、被指“过度设计”甚至存在安全黑箱的 Claude Code,另一边则是 OpenClaw 背后只保留了 4 个底层工具的极简引擎 Pi。这场关于 Agent 形态路线的争论,正在潜移默化地重塑整个终端分发生态。对于 App 开发者与增长操盘手而言,当用户入口从点击屏幕彻底转向由 Agent 自动执行的脚本流时,如何在新一代分发网络中稳住阵脚,已成为决定生死的关键考题。新闻与环境拆解:极简引擎与商业巨头的路线之争在这个风起云涌的 AI 春天,开发者们正在经历一场前所未有的范式震荡。Anthropic 的封杀令与极简框架 Pi 的火爆,共同撕开了当前智能体繁荣背后的复杂真相。极简的胜利:Pi 框架为何只留 4 个工具作为支撑 OpenClaw 运行的核心引擎,Pi 的设计理念堪称对当下主流 Agent 框架的“反叛”。其作者、拥有 30 年编程经验的 libGDX 创建者 Mario Zechner,在被日趋臃肿的 Claude Code 折腾后,选择了一条极简之路。Pi 的核心本质只是一个 while 循环,外加 Read、Write、Edit 和 Bash 这 4 个基础工具,以及不到 1000 tokens 的 System Prompt。在 Pi 的逻辑中,大语言模型(LLM)最核心的能力就是读写文件与执行 Bash 命令。相较于业界热衷的复杂记忆层(如专门维护一个 soul.md 来定义智能体性格),Pi 认为这完全是徒增复杂度。真实的生产环境需要的不是一个能“共情”的聊天机器人,而是一台高效的执行机器。这种“刻意不做什么”的克制,反而让系统变得透明、可控且支持无限扩展。安全黑箱与过度设计:Claude Code 的隐患与 Pi 的极简形成鲜明对比的,是 Anthropic 官方推出的 Claude Code 等高度集成的生产级系统。在极客圈看来,这类系统正暴露出严重的安全与过度设计隐患。最大的威胁来自于 Prompt Injection(提示词注入攻击)。在真实应用中,如果赋予一个 Agent 网页读取与本地文件访问权限,当它读取到一个包含恶意隐蔽指令的网页时,极有可能被劫持,进而将用户本地的敏感数据发送至第三方服务器。由于普通用户根本无法理解 Agent 的运行边界,这种“安全假象”让高度集成的 Agent 变成了极度危险的黑箱。正如业内资深开发者所言,我们严重高估了普通人驾驭复杂 Agent 的能力,过度堆叠抽象层只会让系统失控。算力套利与商业封杀:Anthropic 为何下狠手技术路线的争论之外,是残酷的商业绞杀。近期,Anthropic 正式宣布 Claude 订阅套餐不再覆盖 OpenClaw 等第三方工具的额度。表面理由是“容量压力”,实质则是为了阻断 OpenClaw 的“Token 套利”——用户利用 20 美元的月费,通过 OpenClaw 极其优化的架构消耗了价值高达 5000 美元的算力。更深层的危机在于,OpenClaw 这种标准化网关将大模型降级成了随时可替换的“执行零件”。用户只需自带 API 密钥,就能在 Claude、GPT、DeepSeek 之间无缝切换。这直接刺穿了 Anthropic 试图构建的商业护城河。《极客邦科技InfoQ》相关报道指出,这迫使 Anthropic 不得不亲自下场,强推自家生态工具,AI 行业正从“开放协作”迅速滑向“巨头割据”。从新闻到用户路径的归因问题:App 的断流焦虑无论是极简的 Pi,还是被封杀的 OpenClaw,它们都在加速一个不可逆的趋势:终端控制权正在向 Agent 转移。这在普通人眼中是解放双手的科技狂欢,但在 App 开发者与数据增长团队看来,却是一场令人窒息的“断流危机”。过去,用户的转化路径是清晰的“人物流量(Human Traffic)”:用户在信息流看到广告 -> 点击链接 -> 跳转应用商店 -> 下载打开 App,每一步都能通过追踪链接和埋点精准捕捉。如今,流量正在被“任务流量(Task Traffic)”取代。用户可能在终端输入一句“帮我把最近一周的财务报表整理好并导入某财务 App”,底层的 Pi 或 OpenClaw 会自动调用 Bash 脚本、拉取数据,甚至在后台静默调用该 App 的接口或引导完成必要组件的安装。在这个多 Agent 协同的黑箱里,App 的数据看板上只会突兀地出现一个“未知来源激活”。你不知道是哪个工作流(Workflow)发起了任务,不知道用户的原始意图,更无法将后续的活跃数据归因到特定的 Agent 推广渠道上。当流量来源成了无头账,App 的增长策略将彻底瘫痪。工程实践:重构安装归因与全链路归因要在智能体分发的洪流中接住“任务流量”,App 团队必须抛弃传统的点击归因思维,利用底层追踪技术将黑箱变为白盒。渠道编号 ChannelCode:多 Agent 平台的流量收束问题:当流量入口从单一的媒体平台变成了散落在 GitHub、Discord 以及各大开源 Agent 社区里的自动化脚本与工具插件,App 根本无法分辨哪些 Agent 才是高净值来源。做法:为市面上不同的 Agent 客户端(如基于 Pi 的自定义工具、各类 OpenClaw 变体)分配专属的渠道编号 ChannelCode。当开发者在开源社区分发其集成了你 App 服务的 Agent 脚本时,在调用接口或引导下载的底层参数中强绑定该 ChannelCode。好处:将极度碎片化的智能体流量统一收束。通过全渠道统计看板,清晰对比不同大模型或不同框架带来的用户 ROI,将营销资源精准投放到转化率最高的开发者生态中。智能传参安装:穿透工作流的场景还原问题:Agent 在执行任务时往往带有极其明确的上下文(例如:正在处理一份特定的 PDF 合同并需要使用你的 App 进行电子签名)。但在引导用户安装或首次冷启动 App 的过程中,应用商店的壁垒会把这些宝贵的任务意图彻底洗掉。做法:利用智能传参安装技术,在 Agent 抛出操作指引时,将 agent_platform、workflow_id 及具体的 task_scene 封装进动态参数中。当用户完成安装并首次打开 App 的毫秒级瞬间,SDK 自动拉取这些被暂存的参数。好处:App 首启时可直接绕过繁琐的新手指引,瞬间将用户带入那份“待签名的合同”页面。这种极致的意图承接,正是 《OpenClaw 引爆智能体分发:AI 个人助理重构 App 参数传参安装范式》中强调的核心增长逻辑。注:本文探讨的跨 Agent 多端任务流转及深层跨设备局域网通信归因等场景,属于对未来智能体分发趋势的前瞻性技术延展与思考。例如跨平台终端底层无缝一键唤起等前沿应用方向,可能受到各大操作系统严格的隐私沙盒限制。目前此类高度定制化的高阶链路尚未作为标准功能全量无条件实现,如 App 开发者有类似超前业务需求,欢迎联系 xinstall 客服团队进行技术探讨或共同定向研发拓展。这件事和开发 / 增长团队的关系面对 Agent 架构的快速迭代与巨头的封杀变局,App 团队的应对不仅关乎体验,更关乎未来两年的生存权。面向开发 / 架构团队:建立任务级可观测性多维度 ID 策略:在 App 的数据上报与启动解析机制中,必须增设专门针对任务流量的字段。包括 agent_id(识别是 Pi 还是 Claude)、workflow_id(任务批次)以及具体的 command_context。接口灵活开放:配合智能体“爱用 Bash”的特性,将 App 的部分核心功能以 CLI 工具或轻量级 API 的形式向开发者生态开放,并严格做好对应的权限鉴权与入口埋点。面向产品 / 增长团队:抢占开源生态的话语权改变投放策略:买量红利已尽,增长团队应当主动打入 OpenClaw、Cursor 等极客与开发者社区。通过提供带专属 ChannelCode 的优质 Prompt 或整合脚本,吸引“发烧友”将其编入个人工作流,从而实现四两拨千斤的裂变拉新。重塑归因解释权:不要被动等待大厂开放数据面板,通过自己的全渠道归因体系,将 Agent 流量与实际业务转化强绑定,在内部拿回流量价值的解释权。常见问题(FAQ)什么是Agent开发中的 Prompt Injection(提示词注入)攻击?在 AI Agent 的语境中,Prompt Injection 指的是恶意第三方通过隐蔽手段(如在网页文本、PDF 文档中植入特殊指令),诱导大语言模型偏离原有系统设定,执行恶意操作的行为。例如,当 Agent 被授权访问本地文件并同时读取外部网页时,网页中的隐藏指令可能“欺骗”Agent 将用户本地的敏感隐私文件打包发送给黑客。这也是为何业内认为复杂的综合性 Agent 面向普通用户时存在巨大安全隐患的原因。极简Agent框架Pi与MCP(模型上下文协议)有什么本质区别?MCP(Model Context Protocol)侧重于将各种外部工具和服务作为“服务器”接入,通过规范化的协议将海量信息塞入大语言模型的上下文中,容易导致上下文溢出和极高的 Token 消耗,且热更新困难。而 Pi 框架则秉持极简理念,只提供最基础的底层操作(如读写和 Bash),它鼓励模型自己编写、执行并实时修改微型的“技能脚本(Skills)”。这种方式完全在 Agent 的自我控制下,占用上下文极小且支持热重载,具备极强的自我修复与扩展能力。为什么Anthropic要封杀第三方开源工具OpenClaw?一方面是算力层面的“Token 套利”,OpenClaw 极度优化的架构让用户以极低的月费消耗了极其高昂的服务器算力资源,给 Anthropic 造成了巨大的成本压力;另一方面则是商业护城河的危机,OpenClaw 作为标准化的本地网关,让用户可以随时切换不同厂商的大模型,将 Claude 等模型弱化为可替代的“底层零件”,严重威胁了 Anthropic 的生态控制权与商业化进程。行业动态观察从 Anthropic 的“闭关锁国”到 Pi 框架的“极简反击”,整个 AI 行业正在经历一次阵痛期的路线分化。巨头们希望建立全封闭的围墙花园,将用户牢牢锁定在自己的全家桶内;而广大的开发者则通过开源框架,试图将大模型彻底工具化、插件化,构建起一个去中心化的自动化世界。对于身处其中的 App 与 B 端服务商而言,现在正是重构数据与归因体系的黄金窗口期。当传统的信息流渠道陷入内卷,那些能够率先参透“任务流量”本质,利用底层传参技术将应用服务无缝嵌入各大 Agent 工作流的团队,必将在这场新旧交替的分发革命中,抢占属于自己的超级入口。
872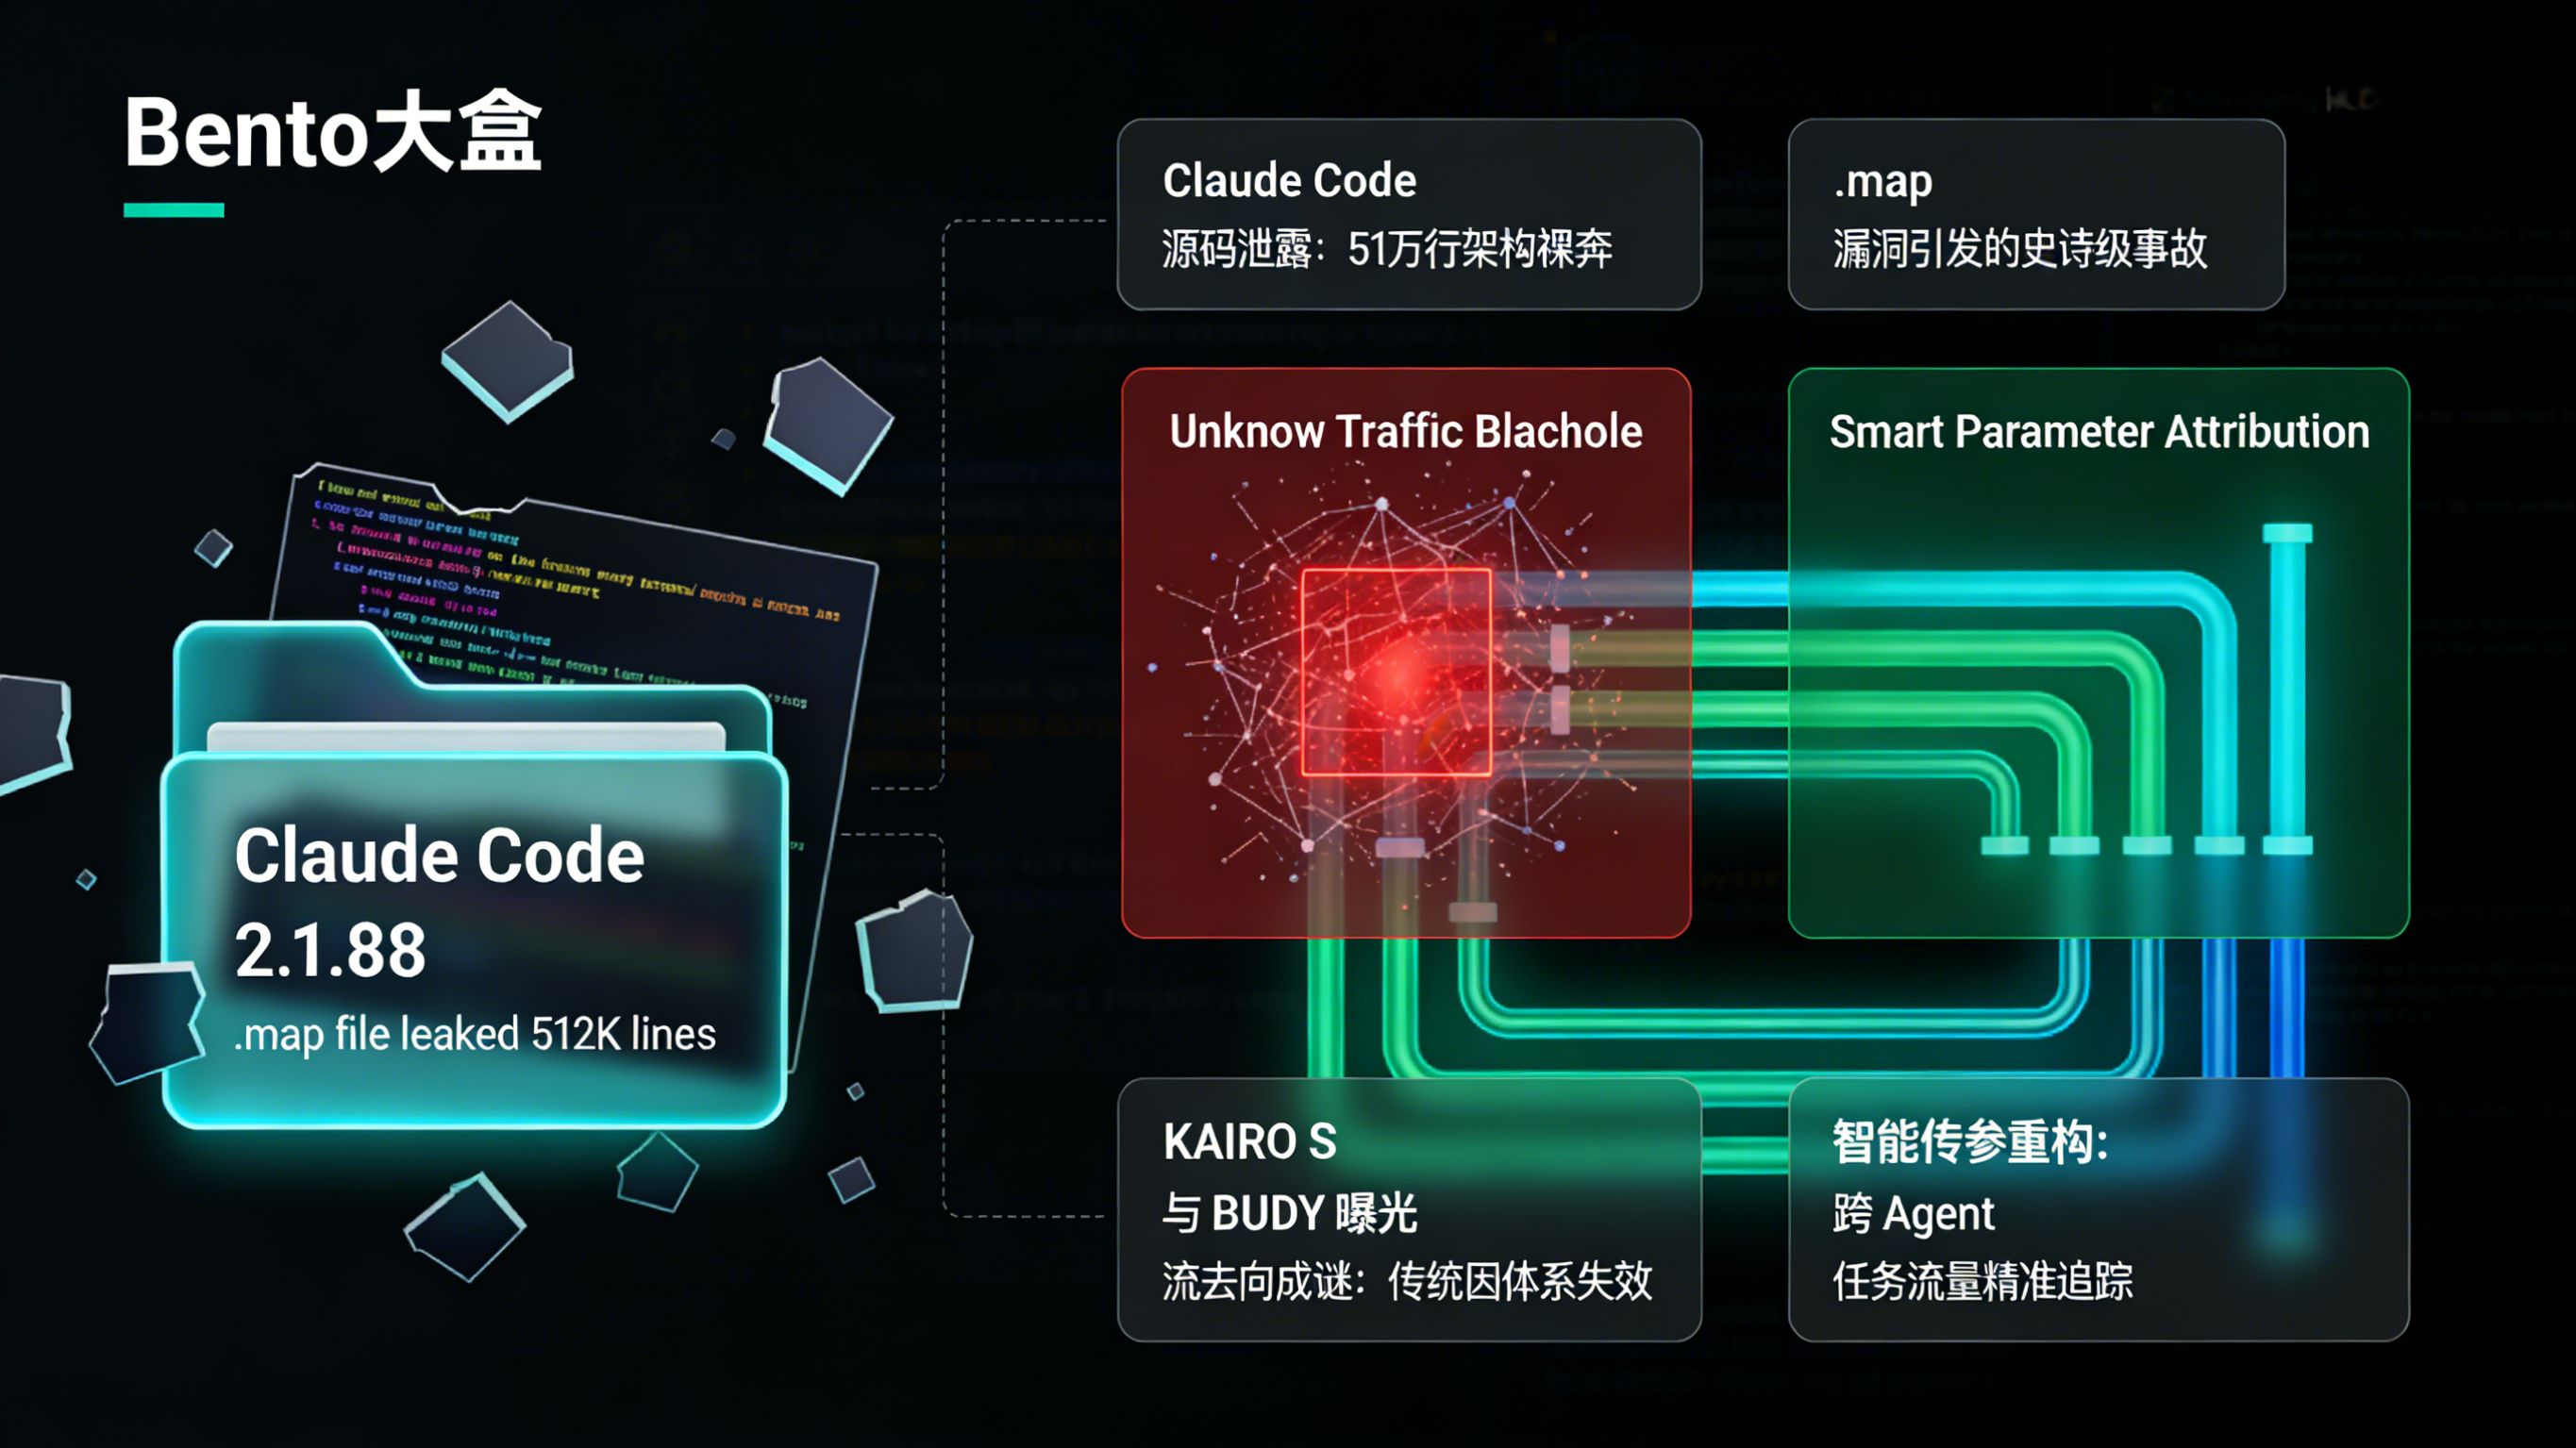
2026 年 3 月底,人工智能领域爆出了一场堪称“史诗级”的生产环境事故:估值超过 180 亿美元的 AI 巨头 Anthropic,因一个极其低级的打包失误,将其主打的 AI 编程工具 Claude Code 的 51.2 万行核心源代码意外“开源”。从极具野心的常驻智能体(KAIROS)到充满趣味的电子宠物系统(BUDDY),这套原本被严格保密的顶级 Agent 工程架构,瞬间向全球开发者“裸奔”。这场泄露不仅让整个科技圈为之震动,更在无形中按下了智能体生态爆发的加速键。当 AI Agent 的工程门槛被彻底踏平,开发者与增长操盘手们即将面对一个全新的挑战:在这个由机器代为执行指令的“任务流量”时代,App 该如何精准识别来源、承接意图,并完成跨端场景的无缝转化?新闻与环境拆解:顶级 Agent 架构的“裸奔”时刻在这个信息爆炸的周末,Claude Code 的源码泄露事件以惊人的速度在 GitHub 和各大开发者社区发酵。这不仅是一次严重的安全事故,更是一场关于 AI 终端形态与软件供应链安全的深刻教学。一个 .map 文件引发的 51 万行代码“血案”事件的起因令人咋舌:Web3 安全公司 Fuzzland 的研究员 Chaofan Shou 在检查 Anthropic 官方发布的 npm 软件包 @anthropic-ai/claude-code(版本 2.1.88)时,意外发现了一个约 60MB 的 cli.js.map 文件。在前端和 Node.js 开发中,Source Map 文件主要用于在报错时将压缩后的代码映射回原始代码,通常绝对禁止发布到生产环境。然而,就是这个被遗漏的 .map 文件,包含了完整的 sourcesContent 字段。这意味着任何人只需极低的门槛,就能下载并还原出全部的原始代码。据数据分析,该文件共包含 4756 个源文件内容,其中 1906 个为 Claude Code 自身的 TypeScript/TSX 源文件,其余为 node_modules 依赖,整体代码量超过 51.2 万行证券时报。事件曝光后短短数小时,GitHub 上的镜像仓库星标数便突破了 5000 大关。生产级架构全景:超越“编程助手”的操作系统还原后的源代码,为外界提供了迄今为止最完整的顶级 AI Agent 架构视图。代码显示,Claude Code 远非一个简单的 API 封装外壳,而是采用了 React 与 Ink 框架构建终端界面,运行于高性能的 Bun 运行时之上。其核心推理文件 QueryEngine.ts 的代码量高达 4.6 万行,独立承担了极为复杂的推理逻辑处理、Token 动态计数以及“思维链(Chain of Thought)”循环的全部工作。而在工具层面,系统内置了超过 40 个独立模块,涵盖底层文件读写、Bash 脚本执行、LSP 协议深度集成,甚至包含了 coordinator(多智能体协调器)模块与连接主流 IDE 的 bridge 模块。有资深程序员在分析源码后惊叹:Claude Code 展现出的调度与协同能力,让它看起来不像是一个辅助工具,而更像是一个接管型 AI 操作系统。KAIROS与BUDDY:提前曝光的“数字原生生命”泄露代码中最令业界震撼的,莫过于数项隐藏在编译标志背后的未发布实验性功能。这些功能揭示了 Anthropic 对未来人机交互形态的终极设想:其一是代号为 KAIROS 的持久化自主模式。不同于传统 AI“呼之即来,挥之即去”的被动响应,KAIROS 是一个具备持久生命周期的后台守护进程(Daemon)。它能在后台持续监控用户行为,配合名为 autoDream 的机制,在系统低活跃期自动整理短期对话,将其转化为长期的结构化记忆。这标志着 AI 正在向“常驻数字员工”加速进化。其二是名为 BUDDY 的终端电子宠物系统。这是一个致敬 90 年代“拓麻歌子”的 AI 伴侣系统,内置 18 个物种、稀有度等级及闪光变体。它结合用户 ID 动态生成不可篡改的唯一角色,并在工作流中提供情绪价值InfoQ。卧底模式与“数据投毒”:激进的商业防御策略除了前沿功能,源码中还暴露出 Anthropic 极具争议的商业防御手段。例如被称为 Undercover Mode(卧底模式) 的功能,当 Anthropic 员工在 GitHub 等公共仓库进行代码提交时,该模式会自动激活,抹除提交记录中一切关于 AI 辅助的痕迹。此外,其 API 中还嵌入了向潜在的抓取者注入虚假工具定义(fake_tools)的投毒机制,试图通过污染数据来干扰竞品的模型蒸馏。这些曝光引发了行业对于软件供应链安全以及 AI 巨头透明度的广泛讨论。从新闻到用户路径的归因问题:开发者面临的断流危机在这场代码泄露的狂欢中,广大中小开发者和安全研究员正夜以继日地“抄作业”,试图借此拉齐与顶级大厂在 Agent 工程化上的差距。然而,对于 App 开发者、产品经理和增长操盘手而言,当这一新闻的兴奋感褪去,随之而来的将是极其现实的“流量焦虑与饭碗问题”。试想一下:当获取 KAIROS 这种级别的常驻后台 Agent 变得轻而易举,当市面上涌现出成千上万个基于 Claude Code 架构改写的垂直智能体(如专属的代码评审 Agent、竞品监控 Agent、自动出差订票 Agent),用户的交互入口将发生彻底的转移。用户不再需要逐一打开各个 App 去寻找功能,而是直接在终端向 Agent 发出指令,由 Agent 负责调用对应的 App 或网页完成任务。这就是从“人物流量(Human Traffic,人类点击带来的流量)”向“任务流量(Task Traffic,机器代执行的流量)”的降维打击。在这个全新的场景下,传统基于 App Store 点击和人类行为埋点的归因体系将瞬间失效。如果一个用户是通过某个在后台默默运行的 Agent 推荐,从而下载并激活了你的 App,你的后台看到的可能只是一个“自然新增(Organic)”或“未知来源”。盲区开始蔓延:多终端多 Agent 黑盒:流量可能来自 VS Code 插件里的一个 Agent,也可能来自 Mac 终端里的 Claude Code 变体,传统链接跳转追踪根本无法覆盖。意图丢失:即使用户听从了 Agent 的建议下载了 App,安装打开后,App 怎么知道用户刚才和 Agent 聊了什么?怎么知道直接跳转到哪个具体的功能页面完成余下任务?“懂技术的在看热闹,懂业务的已经感受到了断流危机。”如果没有重构适配智能体时代的归因与安装链路,你的 App 将在浩浩荡荡的 Agent 浪潮中变成一座无法被数据观测的孤岛。工程实践:重构安装归因与全链路归因面对“任务流量”的汹涌来袭,App 的增长与技术团队必须抛弃旧有的点击跳转思维,深入底层重构一套跨越系统黑盒的数据接收与归因体系。1. 渠道编号 ChannelCode:统合多 Agent 入口标识问题:当流量不仅来自信息流广告,还大量来自各类开源 Agent、IDE 插件或终端工具时,入口变得极度碎片化且难以区分。做法:为市面上的各大合作 Agent 或分享出去的 Prompt 工作流生成独一无二的 ChannelCode。当 Agent 引导用户去下载或唤起 App 时,强制要求在其调用的链接或参数中附带该标识。好处:通过全渠道归因数据看板,增长团队可以清晰地看到:是哪个垂直 Agent 带来了最高净值的用户?是哪个自动化工作流(Workflow)的转化率最高?这为 App 在 AI 时代的渠道投放指明了方向。2. 智能传参安装:让任务意图无损穿透应用商店问题:Agent 已经明确了用户的特定需求(例如:生成一份从上海到北京的高铁差旅报销单),但在引导用户下载 App 的过程中,应用商店(App Store / Google Play)的安装过程会像一堵墙一样,把这些上下文全部抹除。做法:引入智能传参安装机制。当 Agent 抛出操作链接时,利用延迟深度链接(Deferred Deep Linking)技术,将 agent_id、task_type(任务类型)和 scene(任务场景)等参数短暂挂起。当用户完成下载并首次启动 App 的毫秒间,SDK 迅速拉取这些被暂存的参数。好处:App 可以在新用户首次打开时,直接跳过繁琐的常规首页,瞬间构建出对应的工作界面,实现意图的无缝承接。更多关于这一底层机制的剖析,可参考 xinstall 的《智能体分发时代 App 安装传参逻辑的底层重构》。3. 参数还原与事件图谱:捕捉任务流量真身问题:安装激活只是一次握手,App 还需要持续观测该 Agent 带来的后续留存、活跃与付费行为,甚至需要分辨这是真实用户意图,还是被批量脚本(自动化测试 Agent)刷量的虚假数据。做法:在 App 数据仓中,将首次拉起时还原的参数(如 workflow_id、agent_platform)与用户的长期属性进行强绑定。构建基于任务事件的观测模型,分析用户从“被 Agent 唤起”到“任务完成”的完整链路时长与流失节点。好处:准确评估不同 AI 流量渠道的真实商业价值,同时建立强大的反作弊风控防线。推荐阅读《亚马逊 AI 战略升级?多云多 Agent 时代 App 该怎么认清流量真身》获取更深入的流量拆解思路。注:本文探讨的跨 Agent 多端任务流转及深层跨设备局域网通信归因等场景,属于对未来智能体分发趋势的前瞻性技术延展与思考。部分如跨平台终端底层无缝一键唤起等前沿应用方向,可能受到各大操作系统严格的隐私沙盒限制。目前此类高度定制化的高阶链路尚未作为标准功能全量无条件实现,如 App 开发者有类似超前业务需求,欢迎联系 xinstall 团队进行技术探讨或共同定向研发拓展。这件事和开发 / 增长团队的关系面对由 Claude Code 源码泄露引发的行业蝴蝶效应,团队需要立即采取行动,打通底层数据经脉。面向开发 / 架构团队:字段预留与多端 ID 策略接口预留设计:在 App 的启动项拦截器中,专门为 Agent 流量预留解析层。核心字段建议:除了常规的渠道来源,务必增加 agent_platform(来源平台,如 Claude/Cursor/OpenClaw)、workflow_id(执行的工作流批次号)、risk_level(风险控制等级)以及 task_context(JSON 格式的任务上下文)。多端打通:通过深度链接与 Universal Links 体系,确保无论用户是在移动端还是桌面端点击了 Agent 的反馈链接,都能被快速唤起并带入参数。面向产品 / 增长团队:争夺归因解释权入口定义权:不要再单纯地把买量预算砸给传统广告平台。主动去各大 Agent 社区(如龙虾点评榜、各类智能体平台)铺设带有专属 ChannelCode 的插件或指令集。重塑 Onboarding 体验:当检测到启动参数中包含特定的 task_type 时,大胆跳过那些教程式的新手引导,直接把用户想要的最终结果页面(如生成好的设计图、写好的文档)怼到他们面前,用极致的“效率缩短”留住这批高质量流量。常见问题(FAQ)什么是 npm 的 source map 文件?为什么它会导致源码泄露?在前端及 Node.js 开发中,开发者通常会将原始代码(如 TypeScript)编译、压缩和混淆成体积更小的文件发布。.map(Source Map)文件就像是一本“翻译字典”,记录了压缩代码与原始代码的行列对应关系,甚至直接包含(如 sourcesContent 字段)了未编译的源代码。正常情况下,它只在内部开发或调试时使用,一旦因为 .npmignore 配置失误被打包传到公开网络,任何人都能利用它轻易反向提取出完整的工程源码。Claude Code 的 KAIROS 模式究竟是什么?根据泄露代码揭示,KAIROS 是 Anthropic 正在研发的一种极具前瞻性的“持久化自主模式”。它允许 Claude 不仅在被提问时回答问题,而是作为一个具备独立生命周期的后台守护进程持续运行。它可以常驻系统后台监控状态、处理预设任务,并在系统低活跃期(类似人类的睡眠时间)自动进行记忆整理和知识整合,是向全自动“数字员工”演进的重要探索。泄露代码中提到的“卧底模式(Undercover Mode)”有什么作用?“卧底模式”是代码中发现的一项争议性内部功能。据源码注释显示,当 Anthropic 公司的员工使用 Claude Code 在 GitHub 等公开代码仓库进行开发和提交(Commit)时,该模式会自动激活。它的核心作用是强制抹除提交记录、签名以及注释中一切与“AI 辅助生成”相关的痕迹,且无法手动关闭,旨在隐藏其内部 AI 工具在实际生产环境中的真实介入程度与模型代号。行业动态观察Anthropic 此次超 51 万行源代码的惊天泄露,看似是一场乌龙事故,实则将彻底打破 AI 行业的现有平静。对于那些估值数百亿的硅谷巨头而言,护城河或许不再是单纯的工程架构设计,因为这些知识壁垒正在被以各种意外或开源的方式迅速瓦解。但对于广大的 App 开发者、SaaS 厂商和 B 端企业而言,这却是一个千载难逢的洗牌窗口。当开发一个复杂 Agent 的成本被拉低到“周末熬两天夜”的程度时,市面上的智能体会像曾经的移动 App 一样泛滥成灾。在即将到来的产能过剩时代,真正的胜负手将不再是谁能写出更聪明的代码,而是谁能最好地掌握 分发、归因与变现 的命脉。那些能够率先利用智能传参与多渠道追踪技术,在乱局中清晰理出“任务流量”脉络的团队,必将成为下一代交互革命中最先吃到红利的人。
490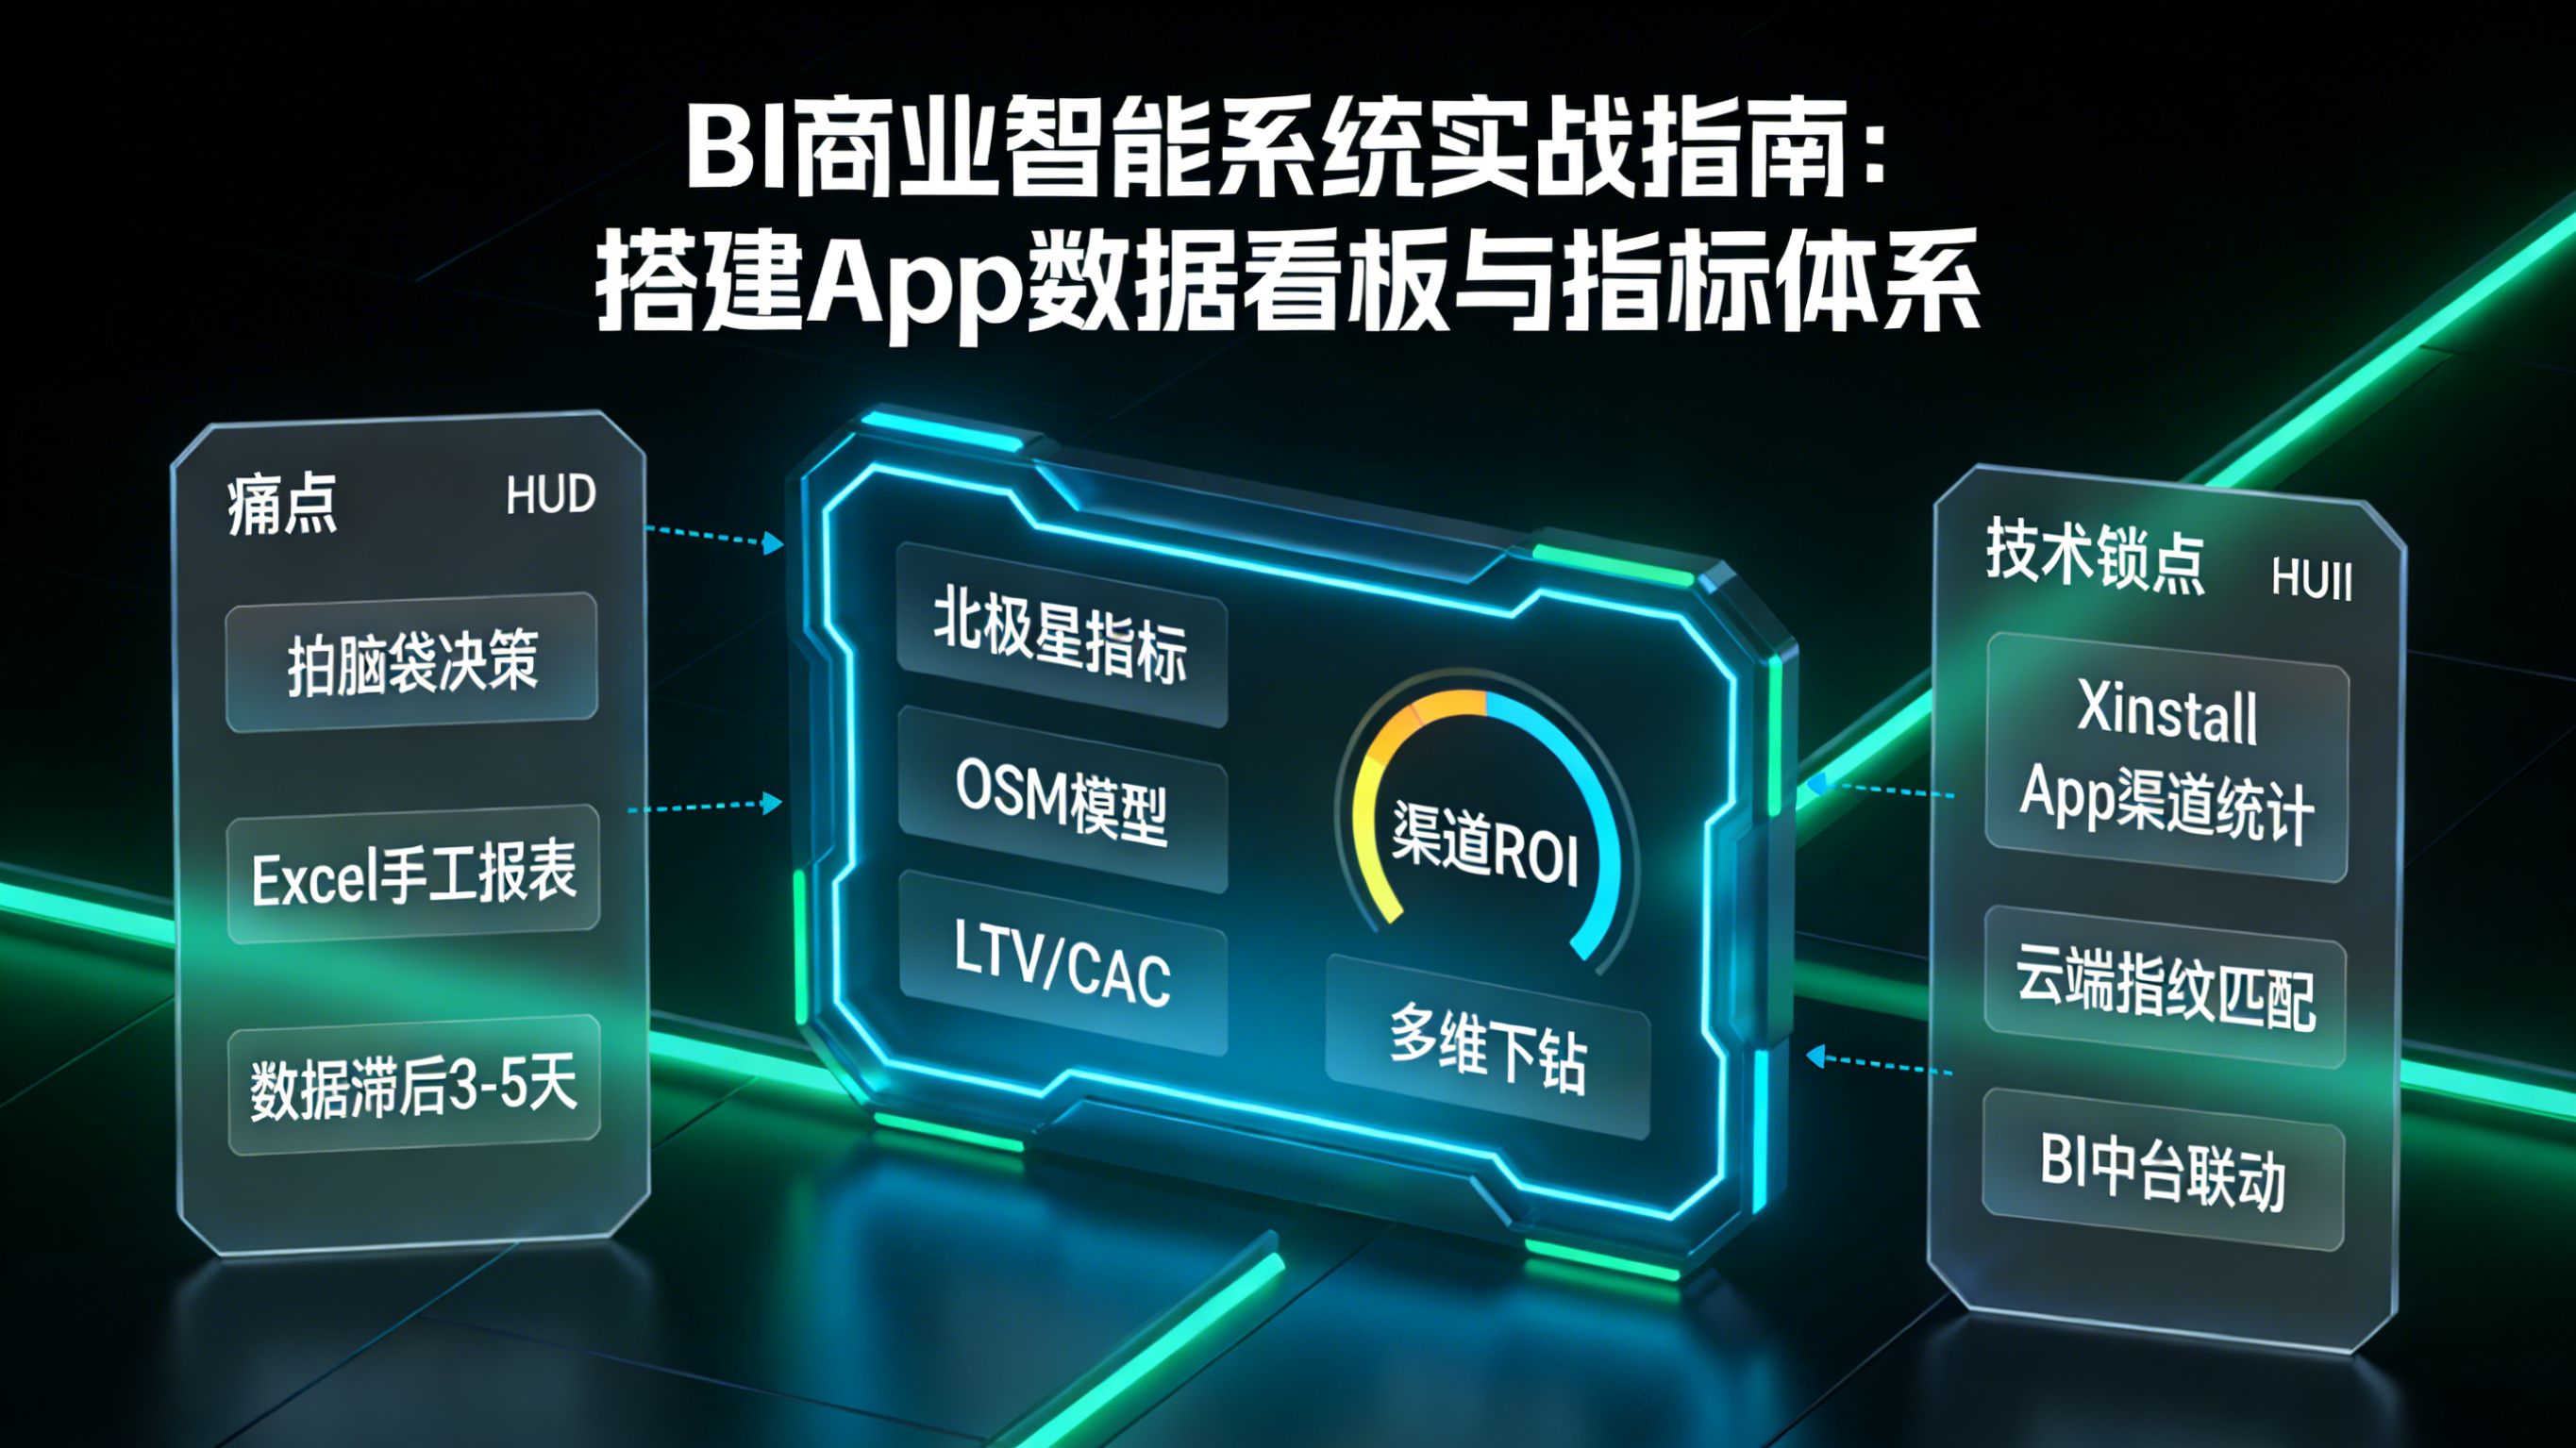
商业智能(BI)系统如何帮助 App 实现数据驱动增长? 在流量红利见顶的当下,告别凭直觉拍脑袋的决策方式,构建一套自动化的商业智能(BI)数据看板已成为企业的必修课。通过将各业务线的数据清洗拉通并进行多维下钻分析,企业能够精准洞察每一个用户的全生命周期价值。对于面临复杂推广环境的 App 团队,将类似 Xinstall 这种前置归因数据接入 BI 中台,更是实现全链路渠道 ROI 洞察的必要基石。什么是 BI(商业智能)及其核心价值在搭建系统之前,我们必须首先厘清 BI 在企业数据架构中的真实定位。BI 的定义与数据中台的区别很多团队常常混淆 BI(Business Intelligence)与数据中台/数据仓库(Data Warehouse)的概念。简单来说,数据中台是后端的“大脑与工厂”,负责从各业务系统(如 MySQL、日志文件)中抽取数据,进行繁重的 ETL(提取、转换、加载)清洗,并建立统一的底层数据表。而 BI 则是前端的“眼睛与仪表盘”,它直接连接建立好的数据仓库,通过 SQL 查询引擎将冰冷的数字转化为可视化图表。只有后端数据中台的口径一致,前端 BI 呈现的分析结论才能指导业务。告别 Excel:实现自动化与实时可视化传统的报表依赖数据分析师每周从数据库导出 CSV 并在 Excel 中跑数据透视表,这种模式不仅极度消耗人力,而且往往带有 3 到 5 天的滞后性。参考 商业级 BI 工具对数据可视化图表选择的标准建议,现代 BI 工具的核心价值在于:API 接口自动化同步:数据T+1(次日)或准实时(如延迟 5 分钟)自动更新。敏捷探索:业务人员无需写代码,只需通过拖拽维度(如地区、时间)和度量(如销售额、转化率),就能秒级生成折线图、漏斗图或散点图。搭建高效 App 数据看板的核心原则搭建看板绝不是简单地把所有图表堆砌在屏幕上。优秀的 BI 看板应当像汽车的仪表盘一样,既能提示当前车速,也能在缺油时给出红色预警。北极星指标与 OSM 模型在建立指标体系时,业界通用的最佳实践是 OSM 模型(Objective 目标, Strategy 策略, Measurement 度量)。首先,必须为 App 确立一个唯一的“北极星指标”,它通常代表了产品带给用户的核心价值与企业的商业变现能力(如短视频 App 的“日均观看时长”,或电商 App 的核心 [ARPU 提升策略](F12 URL占位))。随后,围绕这个北极星指标,将其拆解为一、二级过程指标。例如,若北极星指标为“总营收”,则可拆解为“日活人数 × 付费转化率 × 客单价”。剥离那些看似繁荣但对目标无益的“虚荣指标”。报表分层设计:管理层、运营与执行层一个成功的 BI 系统必须做到“千人千面”,根据看表人的角色进行分层设计:管理层看板(大盘监控):高度聚合。重点展示核心 KPI 达成率、整体利润趋势、大盘 LTV(生命周期价值)与 CAC(获客成本)的健康度。运营层看板(业务洞察):聚焦漏斗。展示核心业务转化漏斗(如从点击到注册再到付费的转化流失率),以及正在进行的各场营销活动的实时 ROI。执行层看板(明细操作):细粒度追踪。具体到每日各渠道的 [PV与UV的区别](F15 URL占位) 及获客明细、单条广告素材的点击成本(CPC)、具体推送通道的触达率。技术诊断案例:通过 BI 报表洞察买量渠道的虚假繁荣仅仅把数据展示出来是不够的,BI 的灵魂在于“分析”。以下是一个经典的基于 BI 多维下钻排查异常的实战案例。异常现象:某渠道带来大量新设备,但总营收未增长某社交 App 市场部为了冲刺季度 DAU 目标,当月新接入了三个信息流投放渠道。在第一周的浅层运营周报中,数据显示“渠道 A”表现极其优异:单周带来了 5 万台新进设备,且单用户获取成本(CAC)仅为行业平均水平的四分之一。然而,在月底财务复盘时,管理层敏锐地发现:大盘总营收并没有随着这 5 万新增用户产生匹配的增长,大盘整体付费率反而被严重稀释。物理与数据对账:结合 LTV 与 CAC 的极值排查资深数据分析师立刻调出 BI 系统的全局追踪看板,通过核心的 LTV / CAC 健康度模型进行对账。在正常健康的商业模式中,渠道的 LTV(按 30 天或 90 天预估)与 CAC 的比例应至少大于 3。分析师在 BI 看板中对各个渠道进行维度拆解后发现:渠道 B 和渠道 C 的比例均在 2.8 到 3.5 之间波动,一切正常;但渠道 A 用户的 7 日 LTV 趋近于 0,其产生的极微弱价值甚至连低廉的获客成本都无法覆盖,呈现严重的倒挂极值。技术介入:多维下钻分析与留存漏斗对比为了拿到铁证,分析师利用 BI 系统的“多维下钻(Drill-down)”功能,将渠道 A 的流量按“设备型号”、“网络环境(IP)”和“次序行为事件”进行了细粒度切片。BI 生成的可视化散点图和漏斗图清晰地暴露出两个致命特征:漏斗断崖式下跌:该渠道 90% 的用户在触发“下载”和“注册”事件后,后续的“深度浏览”、“发起聊天”、“点击充值”等业务事件几乎为零。行为时间戳高度聚集:这批设备的注册时间分布极不自然,通常在凌晨 2 点到 4 点呈现出高度一致的机器脚本操作特征,且 IP 地址大量聚集于几个特定的云服务商号段。产出结果:剔除作弊流量,整体预算 ROI 提升 35%基于 BI 报表多维分析提供的铁证,市场部立刻关停了渠道 A 的全部投放,将剩余的推广预算紧急向虽然获客成本较高、但留存好、LTV 高的渠道 B 转移。调整后的下个月,大盘的总体获客成本虽略微上升了 12%,但整体推广预算的真实 ROI(投资回报率)却逆势提升了约 35%,成功挽回了数十万的无效投放损失,这就是数据驱动决策的真实威力。BI 系统架构与渠道数据接入管线要让前端看板拥有上述强大的下钻分析能力,底层的架构管线必须稳如磐石。ETL 数据清洗与数仓(Data Warehouse)建模所有的业务系统(业务数据库的订单记录、服务器日志的埋点数据)产生的数据都是杂乱的。它们必须经过 ETL 过程:Extract(抽取):将各源头数据同步至暂存区。Transform(转换):这是最核心的一环。统一时间格式、清洗掉空值与作弊异常值、对维度(如地区、渠道名)进行标准化映射。Load(加载):将清洗干净的数据按照星型模型(Star Schema)或雪花模型写入 ClickHouse 或 Hive 这样的数仓中,为 BI 的快速查询做好数据准备。跨端归因与多维数据拼接对于移动端业务,BI 报表要算清一笔账,最难的环节是跨端拼接。例如,用户在微信外部点击了一篇带有参数的 H5 推广软文,随后跳转至 App Store 下载,最后打开 App。普通的内部数仓很难把端外的点击行为与端内的激活、甚至一周后的付费行为准确绑定。为了解决这个数据孤岛,企业通常会接入类似 App渠道统计 的专业基础设施平台。这类平台通过底层的云端指纹匹配与剪贴板参数透传技术,在 App 首次冷启动时,精准地将前置广告点击日志与 App 激活日志进行关联。BI 中台只需接收这套打通后的设备级归因明细表,就能在底层数仓中完美关联业务侧的订单库,从而准确输出每一个细分渠道的 LTV 与 ROI 报表。常见问题(FAQ)中小企业应该自研 BI 还是采购成熟的 SaaS 工具?极不推荐中小团队从 0 到 1 自研可视化报表引擎。早期资金受限时,建议参考 Apache Superset 开源 BI 架构 或 Metabase 这种轻量级开源方案快速跑通逻辑。当业务复杂、数据量庞大时,直接采购成熟的商业 BI(如 Tableau、Power BI、帆软 FineBI),团队应将宝贵的研发精力聚焦在“核心业务数据的清洗与指标口径定义”上,而不是去造图表库的轮子。为什么 BI 报表中的数据往往有 T+1 的延迟?不能看实时数据吗?这源于离线数仓的计算资源瓶颈。海量历史数据的全量计算(尤其是多张亿级大表的 Join 关联)非常消耗服务器算力,如果白天跑会导致线上业务拥堵。因此这些任务通常安排在凌晨低峰期执行,导致次日才能看到前一日的完整报表(即 T+1)。如果业务(如大促、直播带货)需要毫秒级大屏,必须单独搭建一套基于 Flink 或 Kafka 的实时流计算架构,成本较高,通常只针对少数核心指标。业务人员如何培养用 BI 看板做决策的习惯?必须彻底消除“报表只是做给老板看”的误区。企业应该推行“指标包干到人”制度。任何一个产品功能的迭代、或运营活动的上线,负责人都必须在对应的 BI 细分看板上持续追踪反馈数据。将“看数据、找异常”作为团队每日晨会的第一项议程,当数据指标与个人绩效强绑定时,数据驱动的文化自然就会落地。
1255
海报扫码统计如何精准归因?在地铁、电梯或实体门店投放海报,是品牌曝光和获取本地用户的核心手段,但高昂的物料和点位费往往换来一本难以核算的糊涂账。传统的静态二维码只能统计“被扫了多少次”,一旦用户跳去应用商店下载 App,追踪链条立刻断裂,后续的注册与付费完全成了盲区。海报扫码统计精准归因的核心在于“场景还原技术”,通过为不同点位的海报生成携带动态参数的专属二维码,并结合设备环境指纹匹配,能够将用户线下的扫码动作与线上的激活行为精准缝合。本文将拆解线下海报数据断层的三大痛点,剖析动态二维码与延迟深度链接的技术实现,并结合实战案例展示如何利用 Xinstall 等工具精准追踪每张海报的真实 ROI。线下海报营销的“归因黑盒”线下广告的触达往往是碎片化和瞬时的。当品牌方花费巨资铺设了成千上万张海报后,最害怕的不是没人看,而是看了之后“不知道是谁买了单”。这种线下到线上的数据断层,构成了营销界长期难以攻克的黑盒。为了更宏观地理解这种信息不对称对预算分配的致命影响,你可以参考 户外广告与线下营销 ROI 评估模型研究 中的相关探讨,认识到打通 O2O 闭环的紧迫性。传统扫码统计的局限过去,海报上印的通常是静态二维码,扫码后要么指向一个普通的官网,要么指向微信公众号。后台数据看板上,运营人员只能看到某个网页的 PV(页面访问量)或 UV(独立访客数)。一旦用户对产品感兴趣,跳出该页面前往苹果 App Store 或各大安卓应用商店搜索下载 App,这条脆弱的追踪链条就彻底断裂了。前端有扫码记录,后端有新增激活,但这两者之间没有任何关联依据,导致高价值的转化行为成了无法溯源的“自然量”。关于这种局限性在全渠道推广中的具体表现,可参考 海报推广统计该怎么做?渠道二维码扫码归因,了解为什么静态码已经无法满足现代增长团队的需求。多点位投放的“大锅饭”困境大型品牌在做城市下沉时,往往会同时在公交站台、写字楼电梯、商超大屏投放同一套视觉海报。由于使用的是同一个常规下载二维码,所有渠道带来的流量汇聚成一锅粥。这种“大锅饭”式的统计让预算优化变成了拍脑门:团队既无法淘汰那些扫码转化率极差的无效点位,也无法给那些真正带来高净值用户的优质点位追加预算,整体投放效率极其低下。物理环境与跳转漏斗折损线下环境充满了不可控因素。光线暗、距离远可能导致扫码失败;网络信号差(如地铁运行中)会让落地页加载缓慢;而更常见的是,用户习惯用微信扫码,直接遭遇微信对外链的严格拦截。在这个从“线下扫码 -> 页面加载 -> 引导跳转 -> 商店下载”的漫长漏斗中,如果没有强有力的技术支撑进行中间态的引导与参数留存,绝大部分扫码意向都会在中途流失殆尽。场景还原技术打通数据闭环要打破上述归因黑盒,必须在用户扫码的瞬间,将线下的物理属性(时间、地点、物料编号)转化为线上的数字标签,并伴随用户穿透应用商店。这一切依赖于动态参数二维码与场景还原技术的完美结合。关于多点位渠道码的批量生成与落地管理,可以通过 二维码扫描统计怎么做?无限生成渠道码 进一步掌握实战操作技巧。动态参数:给海报发放“数字身份证”精准归因的第一步是“千海报千码”。利用第三方统计归因工具,市场部可以为每一个具体的投放点位(例如“北京朝阳大悦城东门A号牌”、“上海国贸电梯3号位”)批量生成独立的渠道二维码。这些二维码在视觉上可能与常规码无异,但其底层链接中嵌入了自定义的动态参数(如 ?media=ooh&spot=BJ_CY_01)。当用户扫码的瞬间,系统就已经精确捕获了该点位的身份信息。环境指纹与云端暂存匹配用户扫码后由于尚未安装 App,无法直接记录设备强特征 ID。此时系统会提取用户的非敏感网络与环境特征(如 IP 地址、系统版本、屏幕分辨率等),生成一个临时的“设备指纹”,并将其与海报参数绑定,暂存在云端服务器中。当用户历经波折从商店下载完成并首次打开 App 时,内置的 SDK 会再次采集当前环境特征生成指纹,向云端发起匹配认领。一旦特征吻合,线下的扫码属性便成功赋能给这个新用户。延迟深度链接(Deferred Deep Linking)的应用场景还原的终极形态不仅是“知道你从哪来”,还要“给你想要的”。通过 Deferred Deep Linking 技术,动态参数不仅包含渠道归属,还可以包含具体的业务指令。假设用户扫了一张“某款限量版运动鞋”的海报,下载打开 App 后,系统不需要用户再去繁琐的首页搜索,而是直接将他们带到那双运动鞋的商品详情页。这种“所见即所得”的体验,能让首次激活后的购买转化率实现质的飞跃。物理对账与多维数据校对逻辑打通了数据并不意味着万事大吉。线下的物料投放容易滋生作弊(如地推人员自己刷单、竞品恶意破坏),必须建立一套严密的物理对账与校对逻辑来清洗脏数据。这套防作弊与对账的逻辑,与一线人员管理的痛点高度重合,你可以在 App地推推广怎么做数据统计?防作弊方案 中找到更多可复用的风控策略。扫码与激活的 CTIT 分析排查线下数据健康度,最锋利的武器是 CTIT(Click/Scan to Install Time,扫码到安装的时间差)。线下扫码到下载激活的合理时间分布,通常呈现两个波峰:一个是现场网络极佳时的“短时激活(几分钟内)”,另一个是用户留存了页面意向、回家连上 WiFi 后的“延迟激活(数小时内)”。但如果后台显示某海报点位的海量激活,其 CTIT 极其反常地聚集在扫码后的 1 到 2 秒内,这严重违背物理常识,必须立刻拉响机器刷量的防作弊警报。空间与地理位置(LBS)的交叉验证海报是物理存在的客观实体,这就是最好的天然风控屏障。如果数据后台显示,放置在广州某核心商圈的海报二维码带来了巨大的激活量,但交叉比对发现,这些激活用户的 IP 地址或 LBS 定位大量集中在东北某个偏远小镇,或者频繁飘忽于海外。这说明该二维码很可能被拍照泄露到了网络上的“羊毛群”中,被黑灰产用于薅取新人奖励。这部分数据必须从该点位的真实 ROI 考核中剔除。用户全生命周期路径追踪评估一张海报的价值,绝不能只停留在“激活”这一浅层指标。必须将考核节点后置,追踪该点位来源用户的次日留存、首单转化率甚至生命周期总价值(LTV)。对账时经常会发现:海报 A 位于交通枢纽,扫码量巨大但用户下载领完免费福利就立刻卸载;而海报 B 位于高端社区,扫码量平平,但首单客单价极高。只有基于全生命周期的底层拉通,才能做出正确的汰换决策。专家诊断案例:某零售品牌海报 ROI 逆袭为了更直观地展现场景还原技术的威力,我们来看某生鲜零售 App 是如何挽救一场近乎失败的电梯海报营销战役的。高昂投放费与模糊的转化报表该品牌花费近百万预算,在目标城市的 5000 个中高档小区电梯内铺设了宣传海报,主打“扫码下载立领 50 元生鲜大礼包”。投放首周,整体后台显示该城市日均新增达到了 3000 人。但市场总监面临着巨大的困惑:无法证明这些新增有多少是直接由这 5000 块海报带来的,更有其他渠道(如线上信息流团队)站出来抢夺功劳;同时,也完全不知道哪几个片区的小区产出最高。分发动态码与配置场景还原技术团队介入后,紧急更换了第二批次的海报物料。他们通过 Xinstall 批量生成了 5000 个带有点位参数(精确到小区和单元楼栋)的专属二维码,并配置了 Deferred Deep Linking 功能。用户扫码下载打开 App 后,系统不仅静默记录了其所在的小区,还自动弹出了“您好,XX 小区专属邻居,您的 50 元礼包已到账”的定制化页面,大幅降低了新用户的陌生感。准确率飙升与预算优化结果数据回收两周后,清晰的归因图谱呈现出来。团队惊讶地发现,仅仅 15% 的高档核心小区电梯,贡献了整个线下渠道 70% 的有效订单;而另有部分片区由于竞品恶意撕毁物料,扫码量竟然挂零。基于这套严密的数据,市场部果断终止了无效点位的续投,将预算全部集中在优质片区与高转化梯媒。调整后,不仅平息了内部团队的“抢功”争议,还将线下渠道的 ROI 追踪准确率提升至 91.6%,整体单客获客成本大幅降低了 34%。常见问题排查指南扫码后没有立即下载还能归因吗?这是线下场景非常典型的情况。用户在电梯或地铁里扫码后,可能因为信号差或流量不够,只打开了 H5 页面,等回家连上 WiFi 后才去应用商店搜索下载。这种“异步归因”是完全可以追踪的。只要云端指纹匹配系统设置了合理的有效时间窗(通常为 1 到 24 小时),用户回家后下载打开 App 时,系统依然能通过短时指纹比对将其精确归因到几个小时前的那次线下扫码动作上。微信扫码被拦截怎么处理?绝大多数线下用户已经养成了用微信扫码的习惯,但如果海报二维码直接包含一个 App 安装包链接(APK),会被微信安全机制无情屏蔽。标准的解法是:二维码必须指向一个带有“微信内智能引导遮罩”的 H5 落地页。用户扫码进入 H5 后,云端先抓取指纹记录参数,然后页面通过视觉动图提示用户点击右上角“在浏览器中打开”进行下载。这样既绕开了微信封锁,又保全了追踪参数。渠道二维码可以无限生成吗?专业的第三方归因工具通常支持批量且无限次的渠道码生成。无论是 50 个商超大屏、5000 块电梯海报,还是 10 万个随商品发出的快递包裹好评卡,都可以通过 API 接口自动生成专属参数码,并将所有数据汇聚在同一个多维看板中进行管理,完全不受数量限制。参考资料与排障说明本文针对海报扫码统计的数据断层痛点,深入拆解了基于场景还原与动态参数二维码(Deferred Deep Linking)的 O2O 闭环方案。在实际落地线下营销战役时,强烈建议摒弃无法溯源后链路的静态网页码,全面切换至带有指纹匹配与一键拉起功能的技术闭环中。这不仅能有效拦截恶意刷单和羊毛党,更能将预算花在真正产出高 LTV(生命周期价值)用户的黄金点位上。
730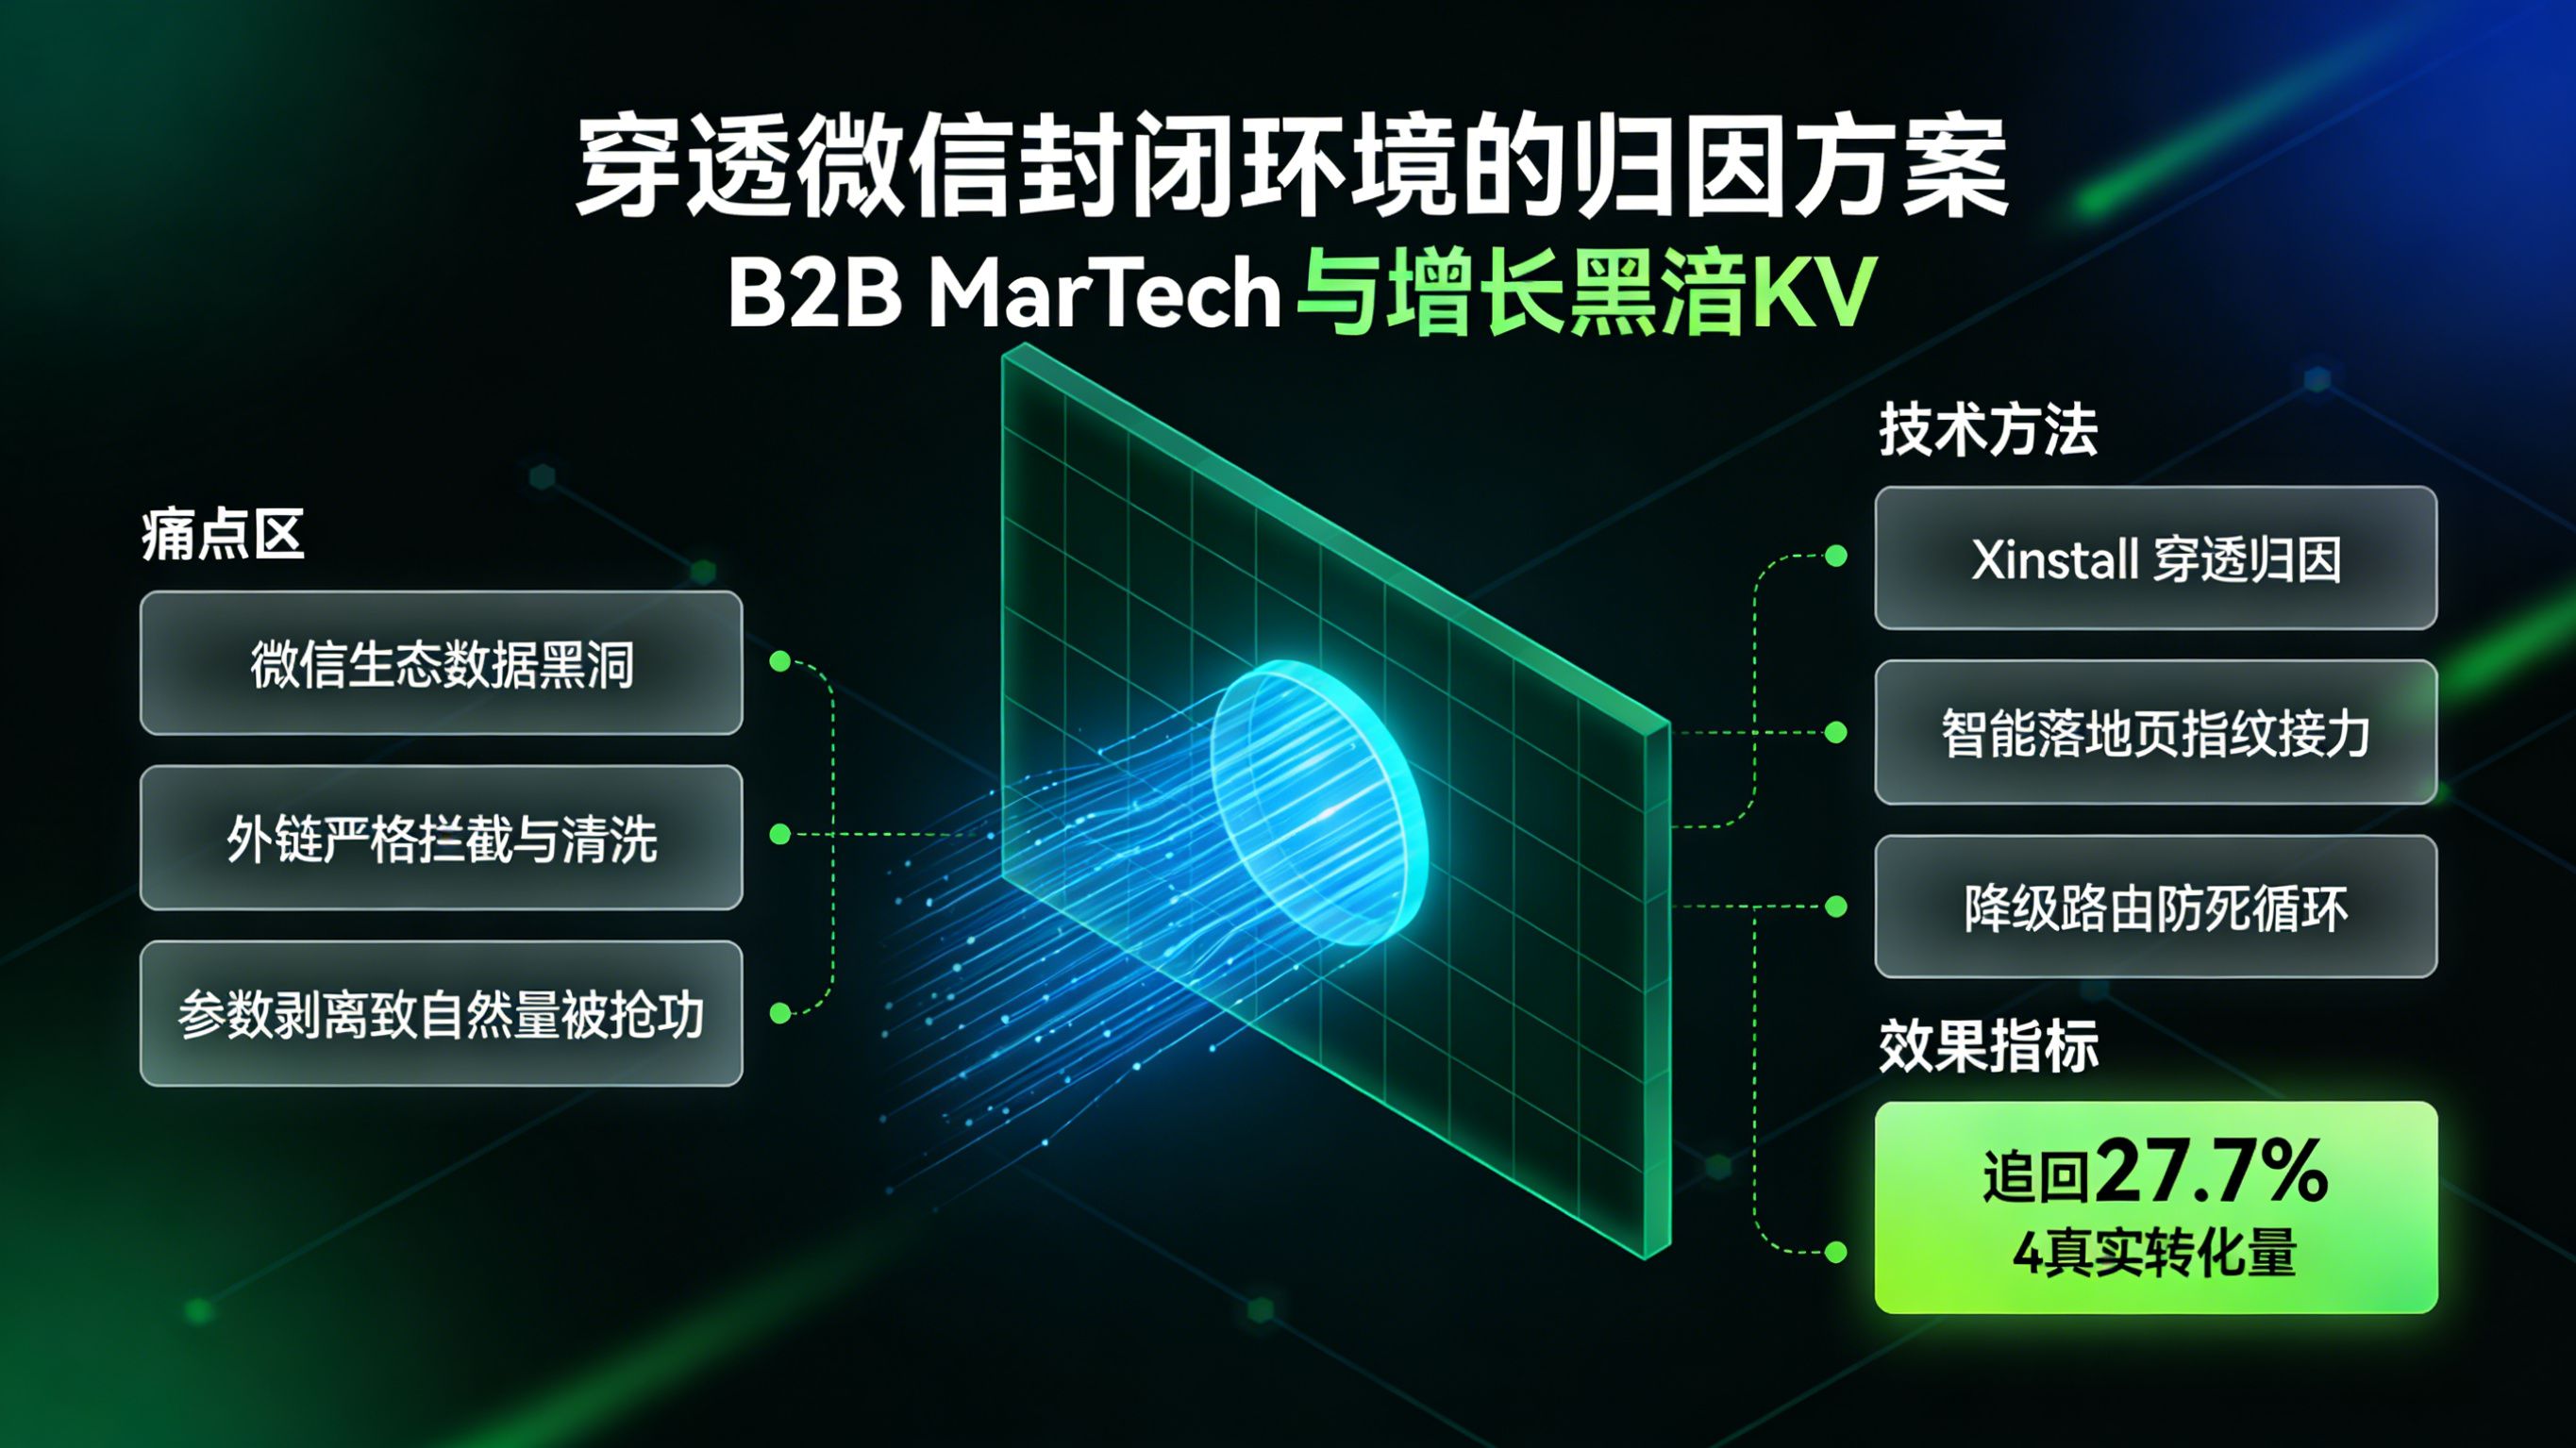
微信渠道统计不准怎么办?微信作为国内最大的社交流量池,一直是 App 获客的核心阵地,但很多投放手发现,社群和朋友圈带来的点击量极大,后台统计到的激活转化却寥寥无几。微信渠道统计不准的根源,在于其封闭生态对外链的严格管控和多重跳转导致的“参数剥离”。要解决这一偏差,需要建立物理对账逻辑排查断层点,并采用落地页指纹接力、云端参数还原等专门针对封闭环境的技术方案。本文将拆解微信数据丢失的三大技术陷阱,梳理物理对账排查流程,并结合真实专家诊断案例,展示如何利用 Xinstall 等第三方工具重构跳转链路,找回被微信生态吞噬的真实转化量。微信生态的数据黑洞在微信内做推广,数据流失的速率远高于常规的开放式信息流媒体。由于微信对安全和商业生态的强管控,用户从点击外链到最终打开 App 的每一步,都在经历“滤网”式的拦截与清洗。外链拦截与合规机制微信对外部链接有着极其严格的管理制度。根据《微信外部链接内容管理规范》,平台为了防止诱导分享、保护用户隐私与数据安全,天然屏蔽了大部分未备案的深度链接(Deep Link)和直接下载 App 的请求。如果你的推广链接被判定为“诱导关注”或包含风险内容,甚至会被直接拦截并提示“停止访问” 。在这样严格的底线要求下,直接通过带参数的短链跳转应用商店的传统做法,在微信内几乎行不通。想了解这种严格拦截机制下,普通网页跳转与微信内跳转在数据流转上的巨大鸿沟,可以参考 网页跳转App统计如何实现 的底层原理拆解。中间页跳转导致参数剥离即便你的外链是合规的,微信也不会让它轻易地把数据带走。当用户在微信内点击一条包含渠道来源和活动代码的推广链接(如 ?channel=wechat&id=123)时,微信内置浏览器常常会将其重定向到一个安全提示中间页,或者跳转至腾讯自家的应用宝 。在这个跨域重定向的过程中,原本附着在 URL 尾部用于归因追踪的参数,往往会被系统粗暴地清洗或截断,导致线索在半路中断。浏览器打开的漏斗折损为了绕开微信的直接拦截,运营最常用的“土办法”是在页面上放一个遮罩,提示用户点击右上角“在浏览器打开”。这个看似简单的额外动作,实际上会引发极高的用户流失率。更致命的是,当用户从微信内置浏览器切换到手机自带的 Safari 或 Chrome 时,前端的 Cookie 和 Session 会彻底失效。环境的割裂使得两端的行为无法串联,造成严重的跨端归因断层。物理对账排查逻辑面对“点击多、激活少”的账面落差,不要急着怀疑流量作弊,而应先建立严谨的物理对账逻辑。通过倒推数据漏斗,可以精准定位“数据究竟死在了哪一步”。物理对账是排查任何渠道偏差的基石,推荐结合 投放效果不准怎么排查 中提到的 CTIT 与回望期校对法,建立完整的排障思维。对齐前后端时间戳排查微信数据不准,首先要从微信后台(或前端页面统计分析平台)导出点击日志,与自家服务端的激活日志按小时甚至分钟级别进行比对。观察是否存在点击高峰期与激活低谷期的极度错位,如果在同一时段内,前端记录了海量点击,而后端对应的激活数据却是一条平缓的直线,这说明断层必然发生在跳转下载链路之中。漏斗核心断层点排查将跳转漏斗细分为三个核心观测节点:微信内页面访问量(PV) -> 唤起外部浏览器/应用商店的请求数 -> App 首次联网启动数。通过在每个节点打入探针日志,可以清楚地看到数据是在“微信提示跳浏览器”时流失的,还是在“浏览器拉起 App”环节未能成功带入参数。定位到具体断层点后,技术团队才能对症下药。识别被抢功的自然量微信环境下的参数剥离会导致一个典型现象:微信渠道的激活数据惨不忍睹,但同一时期各大应用商店的“自然搜索下载量”却莫名其妙地飙升 。这种情况下,绝大概率是因为归因链路断裂,导致微信带来的真实有效量被错误地统计成了应用商店的自然量。通过对比活动前后的自然新增基线,可以大致估算出被“抢功”的流量规模。穿透封闭环境核心技术要修复微信生态带来的断层,依赖传统的渠道包和简单链接已经捉襟见肘。必须引入智能落地页和多维特征识别等高级技术,才能在合规的前提下穿透封闭环境。掌握这些核心技术后,你就能把微信的公域和私域流量真正盘活。具体操作可以深度阅读 微信引流统计如何实现 的实战指南。智能落地页指纹接力针对参数被清洗的痛点,行业内最有效的解决方案是使用 H5 智能落地页作为“跳板”。当用户在微信内访问该 H5 时,系统会立刻抓取当前的网络环境、IP、UA 等非敏感设备特征生成临时“数字指纹” 。随后,系统将原本要传递的渠道参数与该指纹绑定,安全地挂载存放到云端。当用户最终下载并打开 App 时,SDK 会再次生成指纹向云端认领参数,从而实现精准的接力归因。引导遮罩与降级路由为了最大限度保留流量,智能落地页必须具备优秀的视觉引导与降级路由能力。如果检测到当前处于严格的微信内置环境且无法直接唤起,页面会自动弹出视觉友好的遮罩,用动图指引用户点击右上角在浏览器中打开。由于第一步的“指纹”已经存入云端,用户跳出微信进入外部商店后,即便 URL 参数完全丢失,只要最终激活了 App,云端匹配系统依然能把参数下发给客户端。打通双端操作系统生态在微信内实现穿透,还需要针对 iOS 和安卓双端进行差异化适配。对于 iOS 系统,可以通过配置微信开放标签(Open Tag)配合 Universal Links,在满足特定白名单条件时实现微信内直接一键拉起 App 。对于碎片化严重的安卓阵营,则更多依赖云端多维特征匹配算法与剪贴板辅助技术 ,确保在经过应用宝等重重拦截网后,依然能完成参数的精准还原。专家诊断抢救案例为了直观展示上述方案的威力,我们来看某在线教育 App 在微信生态中遭遇的严重数据事故,以及他们是如何绝地反击的。社群裂变的高点击低转化该教育 App 策划了一场覆盖全国数千个微信社群的裂变拉新活动,投入了高昂的运营成本。活动首日,H5 落地页的访问量迅速突破 20 万次;然而,业务后台统计到的“明确带有微信社群追踪参数”的激活量仅有不到 2000 人。转化率不足 1%,渠道数据出现严重塌方,运营团队完全无法统计各个兼职群主的拉新业绩。参数截断与跳转死循环风控与技术团队紧急介入,通过物理对账与日志排查发现了致命问题。原有的普通短链在微信内不仅被重定向至中间安全页导致 inviter_id 丢失,更糟糕的是,部分低端安卓机型在微信内点击下载时,由于未适配降级路由,陷入了既无法下载也无法唤起外部浏览器的死循环。大量的真实用户就这样在死循环中耗尽耐心并离开。重构链路追回真实转化团队当机立断,火速接入了具备穿透归因能力的第三方监控服务。他们将分享链接整体替换为带有指纹接力与降级路由功能的智能 H5,并优化了引导下载交互。活动次周,虽然整体前端点击量与首周持平,但成功追溯并归因的真实转化量暴增。最终,系统帮助业务方追回了约 27.4% 之前被截断和丢失的归因数据,不仅挽救了这场活动的 ROI 报表,也成功平息了群主们对业绩考核的质疑。常见问题排查指南分享链接封禁归因失效如果推广域名被微信完全拦截(即用户点击后出现包含红色感叹号的警告页面),用户根本无法访问落地页,JS 脚本无法执行,指纹归因自然无从谈起 。应对这种情况,必须优先解决合规与防封问题,例如采用多域名轮询机制、规范页面文案、去除诱导性字眼。只要页面能正常打开并触发第一步的参数暂存,后续的归因就能生效。小程序与H5跳转差异很多团队纠结于用小程序还是 H5 作为跳板。小程序跳转 App 受限于微信的严格规范,通常要求必须是由 App 自身分享出去的特定卡片才能跳回原 App,场景非常局限。而通过 H5 配合右上角跳转或指纹归因技术,虽然多了一步页面引导操作,但能无缝适应朋友圈、公众号推文和社群广告等极其广泛的获客场景。维度H5 落地页(配合指纹归因)微信小程序(跳转 App)适用场景朋友圈、社群、公众号阅读原文、外链点击App 主动分享的小程序卡片、特定交互按钮技术限制易被微信内置浏览器拦截跳转,需依赖引导遮罩必须满足微信官方《小程序跳转 App 规则》,双向绑定严格归因稳定性极高(利用云端指纹接力,参数不易丢失)中等(若用户未按规定路径点击卡片,极易断链)用户体验部分机型需跳转外部浏览器(步骤多一环)微信生态内体验相对丝滑(但门槛极高)防止微信环境异常刷量微信生态内存在大量爬虫抓取网页快照、安全检测机器人扫描链接的行为,这些动作会产生海量的虚假点击。如果统计系统不够智能,就会把这些机器点击算作流量,导致点击率虚高。专业的第三方归因工具会通过过滤无头浏览器(Headless Browser)UA、判断 JS 执行轨迹和页面停留时间,来精准剔除这些非人行为带来的无效数据干扰。参考资料与排障说明本文针对微信渠道统计不准的痛点,深入剖析了封闭生态下的外链拦截机制与参数剥离现象。通过引入智能落地页指纹接力和物理对账逻辑,为运营和技术团队提供了一套标准化的数据找回与排障 SOP。在实际投放中,强烈建议避免在微信内直接使用裸露的下载短链,而是全面升级为具备降级路由和指纹暂存能力的动态 H5 中间页,这样才能最大程度保障渠道考核的公正性与营销预算的安全。
857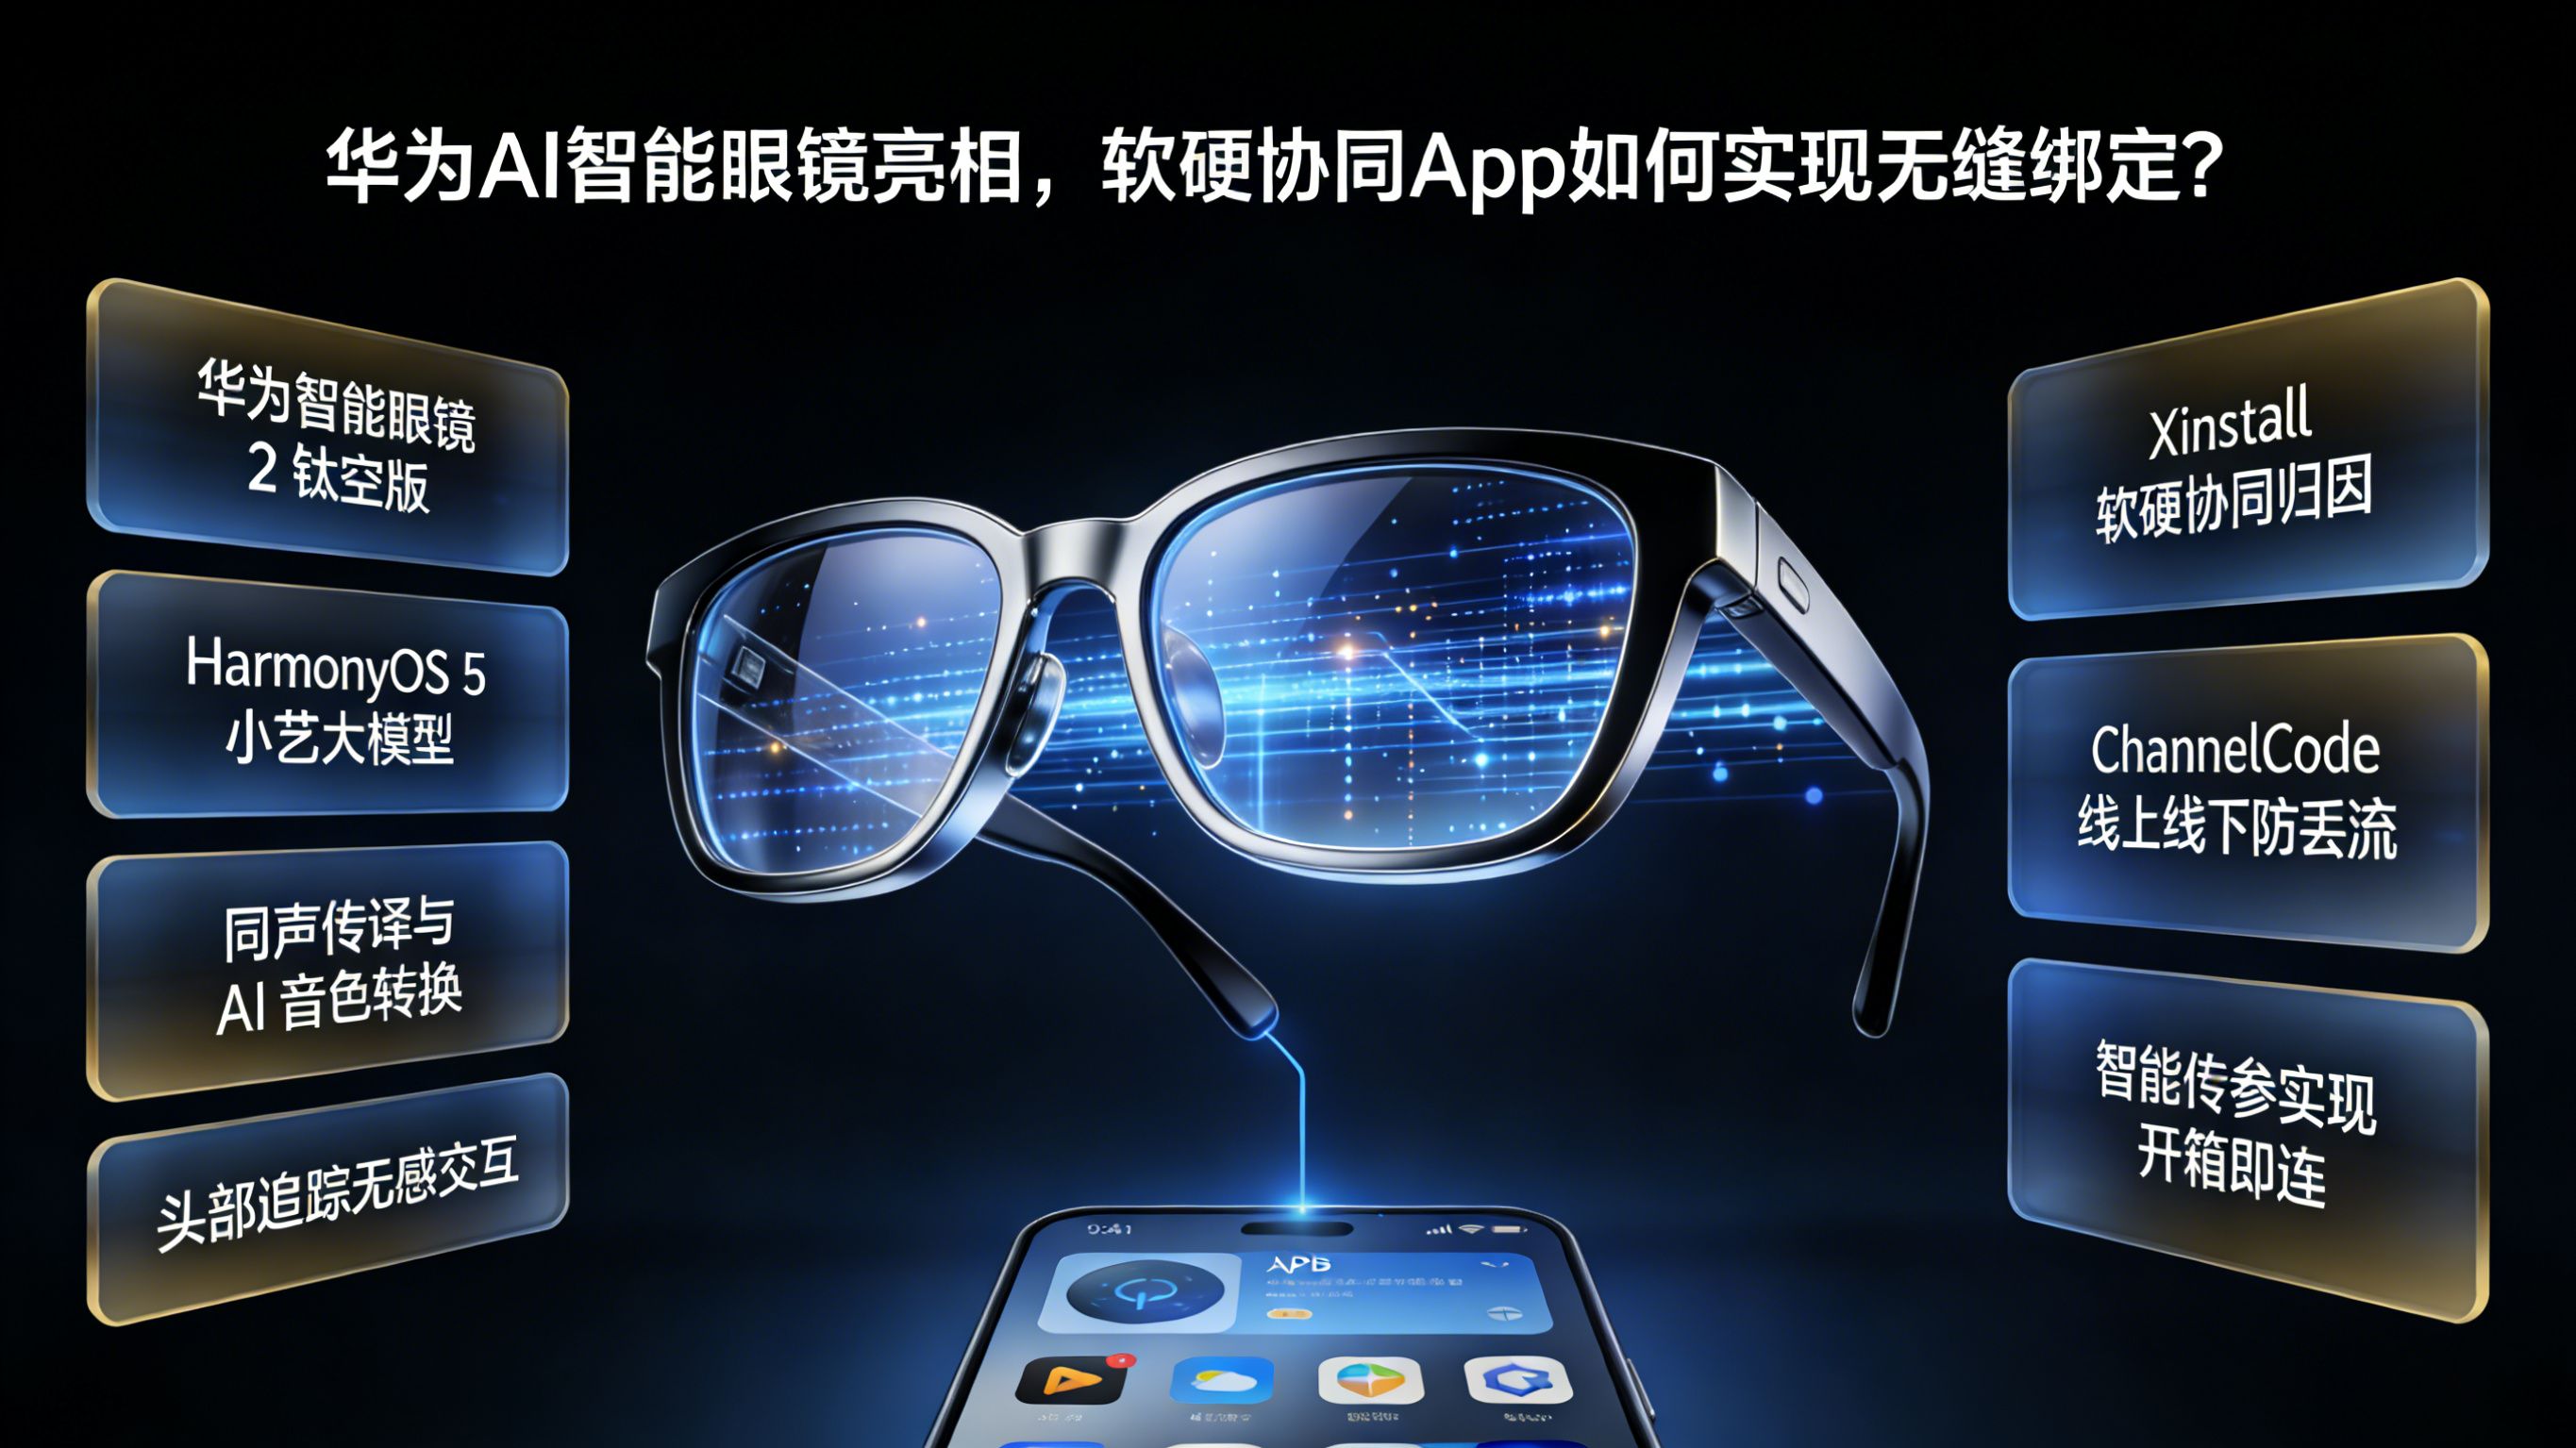
4月16日,华为正式发布由余承东亲自“带货”的智能眼镜 2 钛空圆框光学镜,凭借 HarmonyOS 5 与小艺大模型翻译的加持,迅速引爆了科技圈对“AI眼镜元年”的热情。当智能硬件成为全新的 AI 时代入口,普通消费者在惊叹于同声传译与无感交互等黑科技的同时,千万 App 开发者与出海硬件厂商的增长团队却面临着一个隐秘而棘手的难题:当这些智能设备通过错综复杂的线下门店、海外代理商及线上社交平台售出后,配套的 App 该如何精准追踪用户的流量来源,并为用户提供从下载到激活“开箱即连”的丝滑体验?新闻与环境拆解作为全球通信与智能设备的风向标,华为此次重磅推出的智能眼镜 2 钛空版,不仅是对现有可穿戴设备形态的一次精细化打磨,更是手机巨头将大模型能力向端侧设备全面下放的标志性事件。从外观设计到内核系统,这款定价 2299 元的新品展示了极高的技术密度。突破工艺与佩戴体验的硬件边界在外观设计上,钛空圆框光学镜采用了圆形钛金属镜框搭配黑银色渐变镜腿,并挑战工艺极限,在鼻梁和桩头位置雕刻了象征智慧与力量的“鸢尾”花纹。为了解决长久以来智能眼镜为人诟病的“负重感”,华为针对亚洲人脸型设计了人体工学鼻托与防滑耳勾。而在续航这一核心痛点上,该设备支持长达 11 小时的连续聆听,并配备磁吸快充技术,充电 10 分钟即可支持 3 小时音乐播放,彻底打破了全天候佩戴的电量焦虑。HarmonyOS 5 全面赋能大模型端侧落地硬件是躯壳,AI 才是灵魂。在 HarmonyOS 5 的系统级加持下,该眼镜搭载了全新升级的小艺翻译功能。最引人瞩目的是其“同声传译”模式——不仅能在配合手机时实现屏幕文字与眼镜语音的同步流转,更加入了极具未来感的“AI 音色转换”功能。在多人跨语言交流场景中,AI 能够模拟原说话人的音色进行翻译播报,极大提升了信息传递的自然度与效率。此外,基于传感器升级的头部控制功能,让用户在双手被占用的驾驶或家务场景中,仅需点点头或摇摇头即可接挂电话,真正实现了无感交互。手机巨头的“降维打击”与全场景生态闭环业界普遍将 2025 年视为“AI眼镜元年”。相较于早期的明星创业公司,华为等手机巨头的入局被视为一场典型的“降维打击”。华为不仅拥有成熟的芯片、声学单元与高密度电池供应链,其最大的护城河在于庞大的鸿蒙全场景生态。这款智能眼镜能够与华为手机、平板、智能家居无缝流转,依托华为遍布全球 140 多个国家的销售网络与庞大用户基数,它已经不仅仅是一副眼镜,而是整个华为 AI 战略延伸至人类五官的最前沿触角。智能眼镜赛道的商业化演进回顾历史,华为早在 2019 年就联合潮牌 Gentle Monster 开启了智能眼镜的商业化探索,远早于后来名声大噪的 Ray-Ban Meta。从前几代的听音、消息播报,到如今深度融入大模型与姿态识别,科技巨头正在将竞争的主战场从趋于饱和的智能手机,大举向 AI 穿戴设备转移。这一切都昭示着:硬件形态的创新已经成熟,接下来将是软件生态与服务调用的全面爆发。从新闻到用户路径的归因问题当普通消费者与科技媒体都在为 AI 音色克隆、头部追踪等炫酷功能狂欢时,视角一旦切换到智能硬件背后的 App 开发者和渠道增长操盘手身上,这场狂欢立刻变成了一场充满断层的“流量黑箱危机”。在真实的消费场景中,一名用户可能是在小红书刷到了数码博主的评测,随后跳转到京东下单;也可能是周末逛商场时在华为体验店被导购说服购买。当用户满怀期待地拆开包装,第一步必然是掏出手机,扫描说明书上的二维码去下载类似“智慧生活”的配套 App。然而,在这个从“实体设备”向“数字 App”跨越的瞬间,现有的归因体系彻底失效了。App 被下载安装后,系统完全不知道这个用户是从哪个博主的链接买的,也不知道是哪家线下门店卖出的设备。更糟糕的是,由于缺乏参数的传递,用户打开 App 后,面对的往往是一个冰冷的首页。他们必须手动点击“添加设备”,在一长串数百个设备列表中艰难翻找“智能眼镜 2 钛空版”,然后开启蓝牙,长按设备按键进行繁琐的配对。这种割裂的体验,不仅让品牌方损失了大量宝贵的渠道 ROI 数据,更在用户体验的黄金前五分钟,给号称“极致智能”的 AI 硬件泼了一盆冷水。多终端、跨系统的割裂,让硬件分发与 App 促活成为两座孤岛。工程实践:重构安装归因与全链路归因为了抹平实体硬件与数字应用之间的鸿沟,开发者需要一套能够穿透软硬件壁垒的底层追踪基建。渠道编号 ChannelCode:贯穿线上线下的唯一流量标识问题:智能眼镜的销售网络错综复杂,电商分销、KOL 带货、线下万家门店,当海量用户扫码下载 App 时,流量来源一片混沌。做法:品牌方可以为每一个分销商、每一家线下门店甚至每一个数码博主生成专属的带有参数的二维码或下载链接。借助强大的全渠道统计能力,在说明书或包装盒外码的扫码瞬间,将特定的渠道标识记录下来。好处:当用户激活 App 时,后台能够精准溯源,明确知道“这 1000 个 App 激活用户中,有 300 个来自某知名博主的种草转化,500 个来自北京某旗舰店的现货发售”,从而为营销费用的结算与投放策略的优化提供最硬核的数据支撑。智能传参唤起:重塑“开箱即用”的软硬互联体验问题:用户首次安装配套 App,初始化状态下系统无法预知用户购买的硬件型号,导致手动搜索配对的流失率极高。做法:在下载二维码中不仅封装渠道信息,更封装 hardware_model=eyewear_2_titanium 与 default_language=zh_CN 等硬件特征参数。利用智能传参安装技术,在用户首次打开 App 的瞬间,系统在底层通过深度链接逻辑捕获这些参数。具体的设计思路,可以参考开发者在《智能体分发时代 App 安装传参逻辑的底层重构》中所沉淀的经典范式。好处:用户下载完 App 一打开,屏幕上直接弹窗:“欢迎您,智能眼镜 2 钛空版用户,是否立即一键配对?”免去了所有的手动搜索与繁琐选项。设备连入即刻生效,极致的开箱体验由此诞生。参数还原与跨端事件模型:全生命周期追踪问题:设备绑定后,用户在眼镜端高频使用小艺翻译,但 App 端往往只会记录为一次简单的接口调用,缺乏对用户真实交互意图的洞察。做法:建立跨端事件数据仓。通过初始绑定时带入的参数建立会话关联,将眼镜端发起的“同传翻译请求”、“颈椎健康提醒”等任务流量,与 App 内的用户画像关联起来。好处:能够精准描绘出不同渠道来源用户的活跃周期。比如发现通过极客博主购买的用户,使用“自写代码控制机械臂”的频次远高于线下门店购买的用户,进而指导硬件下一代产品的功能侧重与固件 OTA 规划。注:本文探讨的跨端智能硬件协同与线下二维码极速配对归因场景,属于对未来分发趋势的前瞻性技术延展与思考,例如渠道精细化归因、跨平台一键拉起、私域裂变链路优化等前沿应用方向。目前此类高度定制化链路尚未作为标准功能全量实现,如 App 开发者有类似高阶业务需求,欢迎联系 Xinstall 客服团队进行技术探讨或共同定向研发拓展。这件事和开发 / 增长团队的关系面对 AI 穿戴设备引发的流量重构,团队需要迅速建立跨端协同机制。面向开发 / 架构团队:在配套 App 的 SDK 接入中,务必预留解析 hardware_type 和 sales_channel 的接口。优化蓝牙低功耗扫描逻辑,当接收到特定传参命中时,实现应用后台的静默唤醒与设备的极速握手协议。面向产品团队:夺回用户“入口第一眼”的定义权。不要再让用户面对海量的通用设备库,而是利用传参技术定制个性化的设备欢迎引导页,将核心功能(如同声传译的权限开启)前置到初始化流程中。面向增长 / 数据团队:彻底重构 ROI 看板。将传统的“线上点击转化率”升级为“软硬一体转化率”。利用定制二维码或推客链接赋能庞大的线下销售与私域网络,真正算清每一笔推广费用的去向。常见问题(FAQ)华为智能眼镜2钛空圆框光学镜在交互上有哪些核心创新?这款智能眼镜不仅保留了经典的语音助手唤醒,更创新性地加入了基于内部高精度传感器的头部控制功能。用户在双手不便的场景下,仅需通过简单的点头或摇头动作,即可完成接听、拒接电话等指令操作,极大拓展了无感交互的边界。这款智能眼镜的“同声传译”功能是如何运作的?该功能深度依托了 HarmonyOS 5 操作系统与端云协同算力。在配合手机使用时,眼镜能够捕捉语音并实时进行翻译。最亮眼的是其引入了 AI 音色转换技术,在翻译播报时可以模拟原说话人的特征音色,使得多语种、多人交谈场景下的信息传递更加自然和清晰,避免了传统翻译软件机械发音带来的干扰。为什么业界普遍将2025年称为“AI眼镜元年”?因为底层的算力、电池密度与显示工艺已经越过临界点,加之大模型技术的成熟,使得智能眼镜不再只是一个简单的蓝牙播放器或摄像头。以华为等拥有极强全产业链整合能力的手机巨头大举入场为标志,科技巨头的竞争主战场正式从智能手机向 AI 穿戴设备转移,市场迎来了产品体验质变与大规模商业化普及的历史拐点。行业动态观察华为智能眼镜 2 钛空版的问世,绝不仅仅是一款潮酷科技单品的发布,它是整个科技行业交互革命的缩影。当大模型的推理能力越来越强,限制其实际价值的不再是智商,而是“它附着在什么设备上,以多快的速度感知用户”。对于海量 App 与出海智能硬件厂商而言,这场终端变革意味着传统的“屏幕流量”正在被“任务流量”和“跨端协同流量”所稀释。如果硬件仅仅是卖出去,而无法通过配套 App 建立起精准的用户数据连接与使用黏性,那么企业将永远停留在赚取微薄硬件差价的代工厂阶段。如今正是重构底层数据归因体系的绝佳窗口期。只有打通了从社交裂变、扫码引流到设备唤醒、参数继承的全链路通路,企业才能在这个波澜壮阔的 AI 硬件大航海时代,牢牢握住用户的数字生命线。
703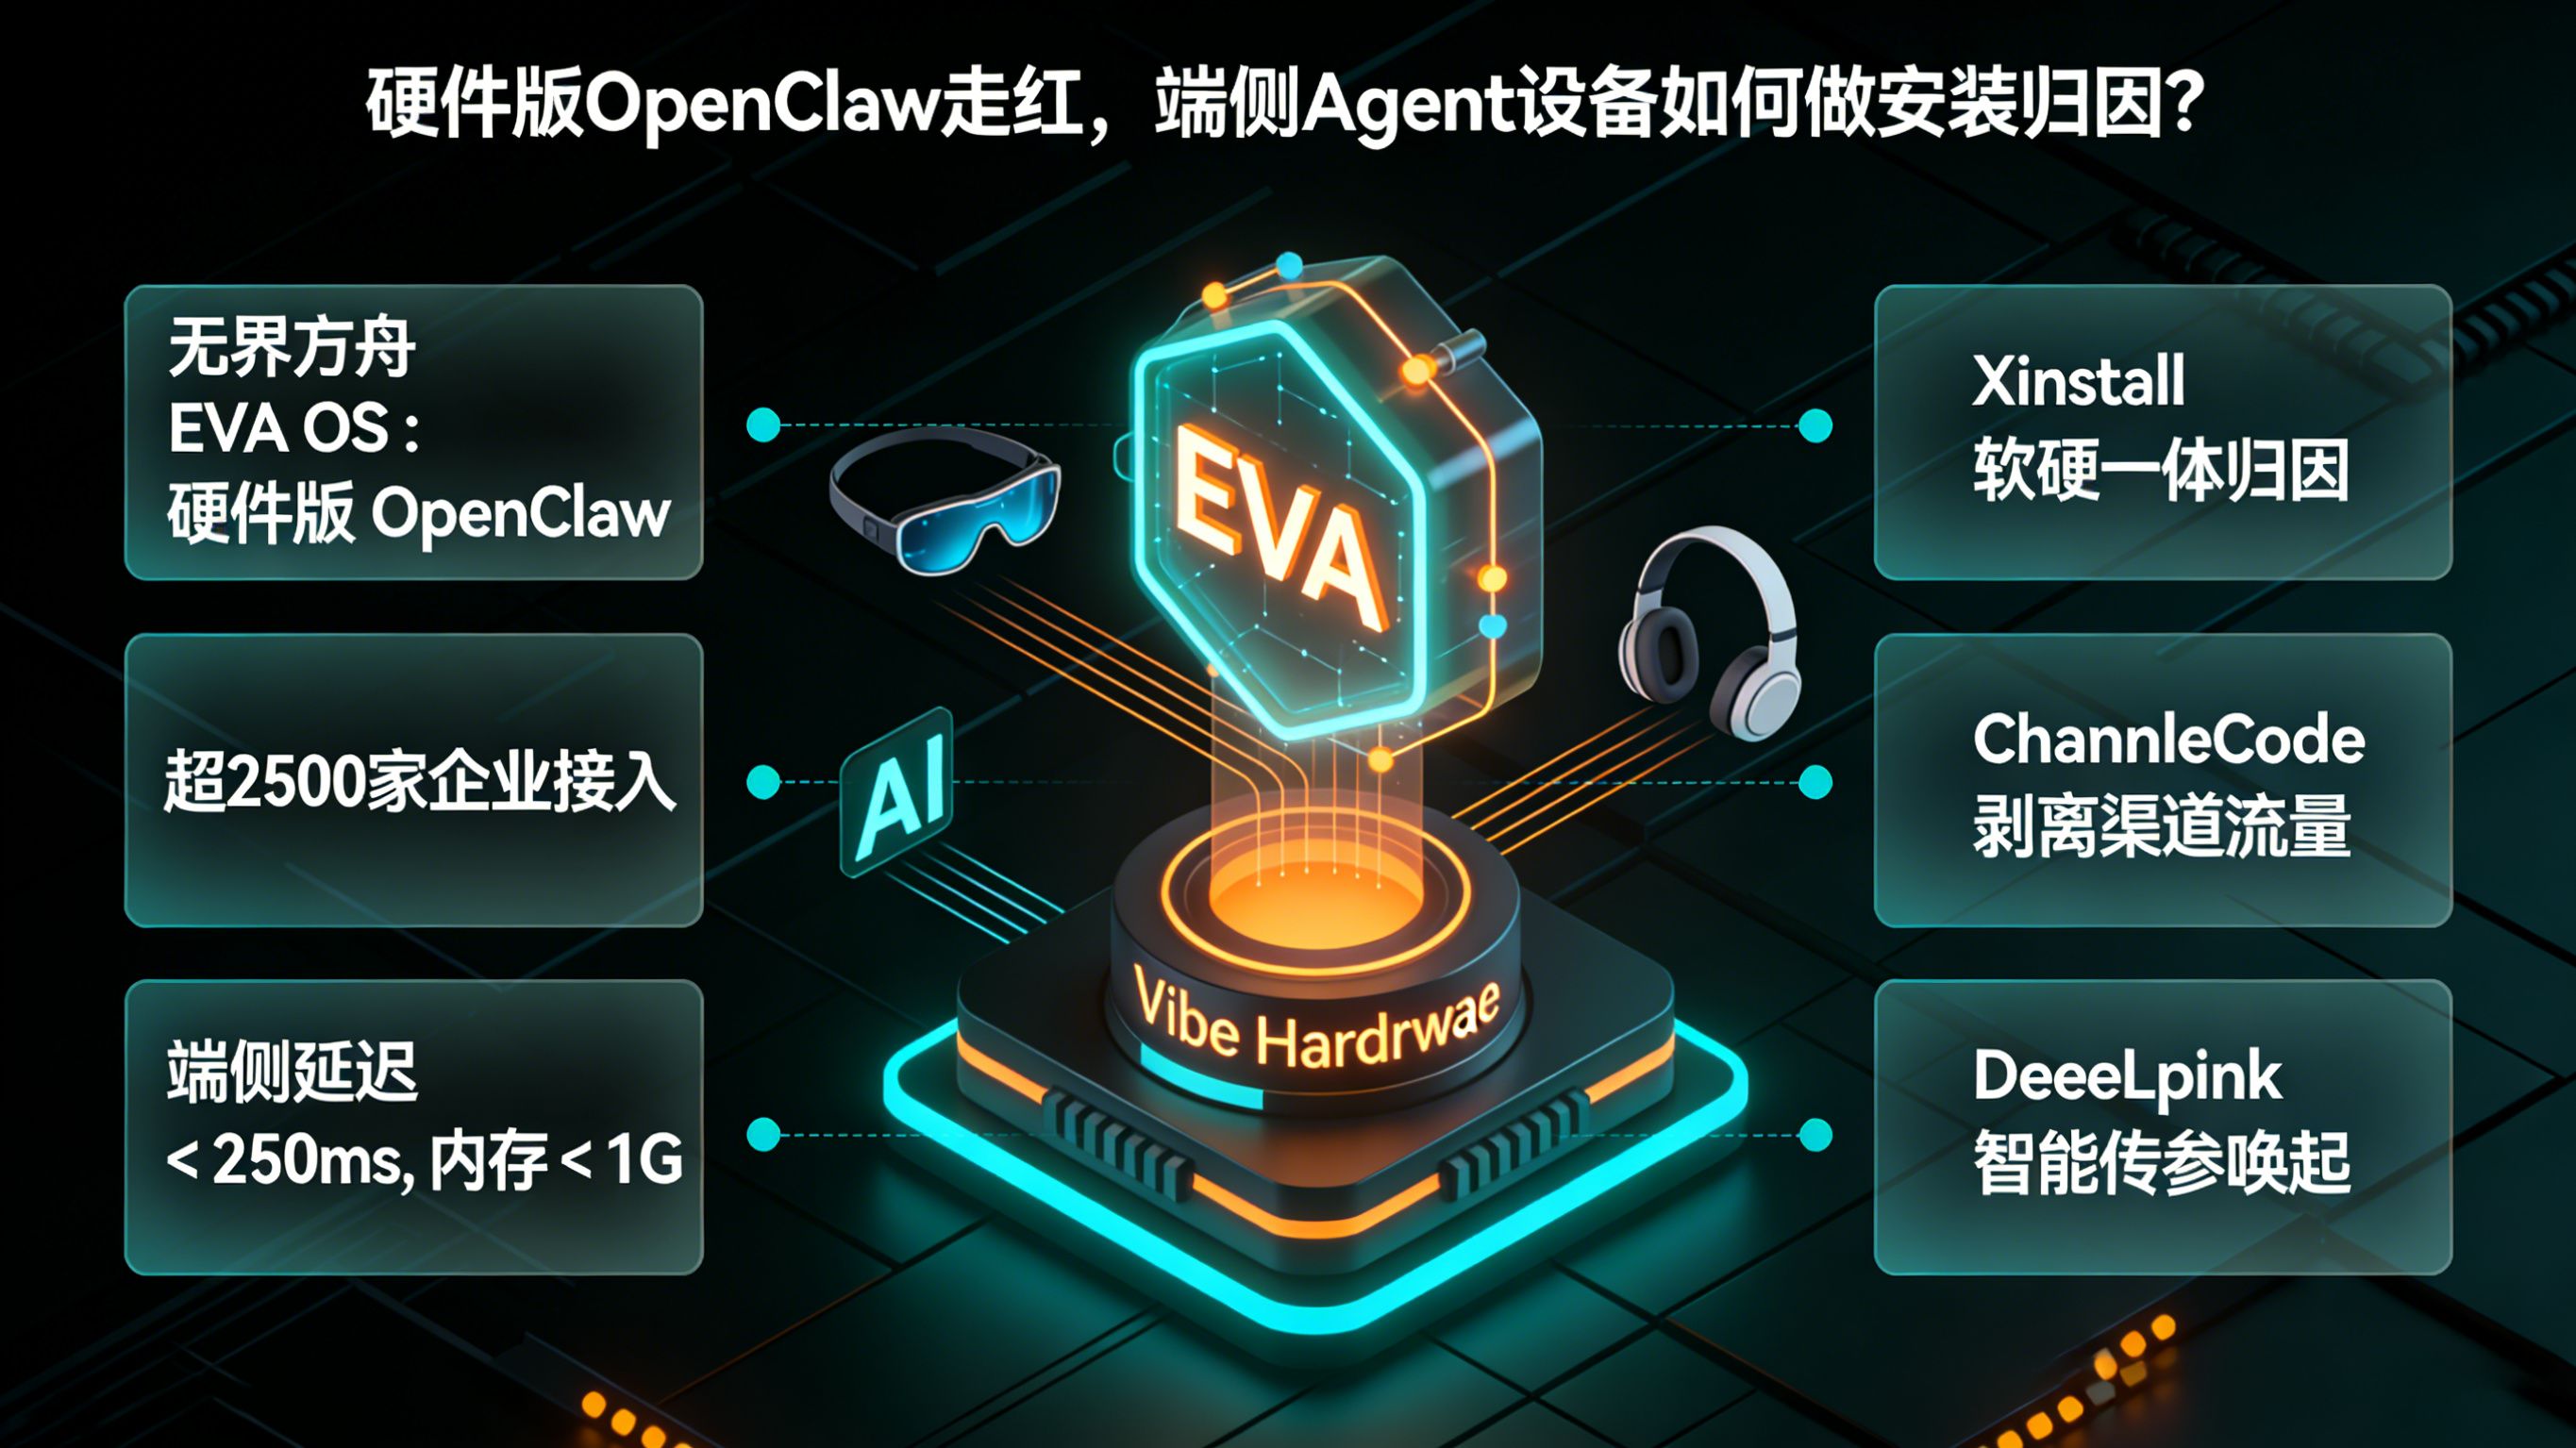
无界方舟连续完成数亿元融资,韶音等入局,其硬件版OpenClaw“EVA OS”引爆端侧Agent生态。当AI从云端走向耳机、眼镜等硬件,开发者如何精准追踪设备的渠道分发与激活归因?36氪独家报道,无界方舟过去一年连获4轮融资,最新Pre-A轮由韶音、国瑞源基金等加持。获韶音投资,一家AI公司做了“硬件版OpenClaw” | 36氪独家 创始人曾晓东提出“Vibe Hardware”范式,EVA OS让硬件具备环境感知与自主写代码能力,端侧语音延迟<250ms,成本降70%-92%。对硬件出海与生态开发者,超2500家企业接入EVA OS预示着AI终端井喷:但设备从电商售出到用户联网激活,跨场景的流量来源与应用分发ROI成了黑箱。新闻与环境拆解EVA OS试图解决AI算法与终端硬件间的巨大鸿沟。核心产品:硬件版Harness EngineeringEVA OS作为中间层,让AI感知芯片算力、传感器状态,自主调驱动写APP;端云协同,端侧主导感知交互,云端复杂推理。商业落地:超2500家接入与硬件样板覆盖AI耳机、眼镜、机械臂等;样板间“奇多多AI学伴机”日均使用达145分钟。本轮融资将推自主更新终端EVA Pi。投资逻辑:端侧原生重塑硬件韶音等看中其统一底座能力;端到端模型跑在CPU上(内存<1G),适配出海弱网环境,成本降至通用方案1/20。从新闻到用户路径的归因问题端侧硬件分发链路极长:用户在海外独立站/亚马逊看广告购买AI眼镜,到手后扫码下载配套App并激活EVA OS。这一过程脱离了纯软件追踪:如何知道哪个KOL卖出了这台设备?硬件内置的默认参数(语种、预设技能)在用户下App时丢失;多设备联动(手机+耳机+OS)导致归因断层。传统广告归因在硬件出海与跨端激活面前纷纷失效。工程实践:重构安装归因与全链路归因渠道编号 ChannelCode:软硬一体分发追踪问题:硬件售出渠道多,激活App时流量来源不明。做法:在电商引流链接或包装二维码中嵌入ChannelCode,标记具体销售渠道或KOL。《亚马逊 AI 战略升级?多云多 Agent 时代 App 该怎么认清流量真身》好处:精准统计“硬件销售到App激活”的真实转化率,优化海外投放。智能传参唤起:设备配置无缝继承问题:用户首次连接硬件,OS初始化配置与App状态脱节。做法:DeepLink封装device_model、os_preset_id,智能传参安装还原配套App。《智能体分发时代 App 安装传参逻辑的底层重构》好处:用户下好App即刻识别对应硬件版本并下发个性化Agent技能,实现“开箱即用”。参数还原与事件模型:设备生命周期图问题:硬件活跃度(如奇多多145分钟)与获客成本脱钩。做法:Session ID串联“购买引流->App下载->OS激活->日常交互”。好处:可视不同渠道用户的硬件使用深度,指导产品选型与备货。注:本文探讨的端侧Agent硬件分发归因属于前瞻延展。目前高度定制链路尚未标准实现,如有需求,欢迎联系 Xinstall 客服探讨研发。这件事和开发 / 增长团队的关系面向开发 / 架构团队:在配套App预留hardware_mac、os_version字段,支持二维码或链接的流式传参;确保端云协同握手顺畅。面向产品 / 增长团队:将KOL或代理商设为分发渠道,建立ChannelCode统计体系;关注设备激活与高频功能的留存。常见问题(FAQ)EVA OS是什么?无界方舟打造的面向智能终端的AIOS,类似硬件版的OpenClaw,让AI懂硬件环境并自主写APP。为什么获韶音投资?韶音看重其统一能力底座,端到端极低成本与弱网可用性高度契合硬件出海需求。端侧延迟与成本优势?语音延迟<250ms,完全跑在CPU内存<1G,成本降至通用方案1/20。硬件落地情况?超2500家企业接入(耳机/眼镜/机械臂等),将发原生终端EVA Pi。行业动态观察EVA OS破局中间层,AI原生硬件从概念走向规模出海。App与硬件团队需全链归因穿越跨端黑箱,掘金端侧Agent生态。
398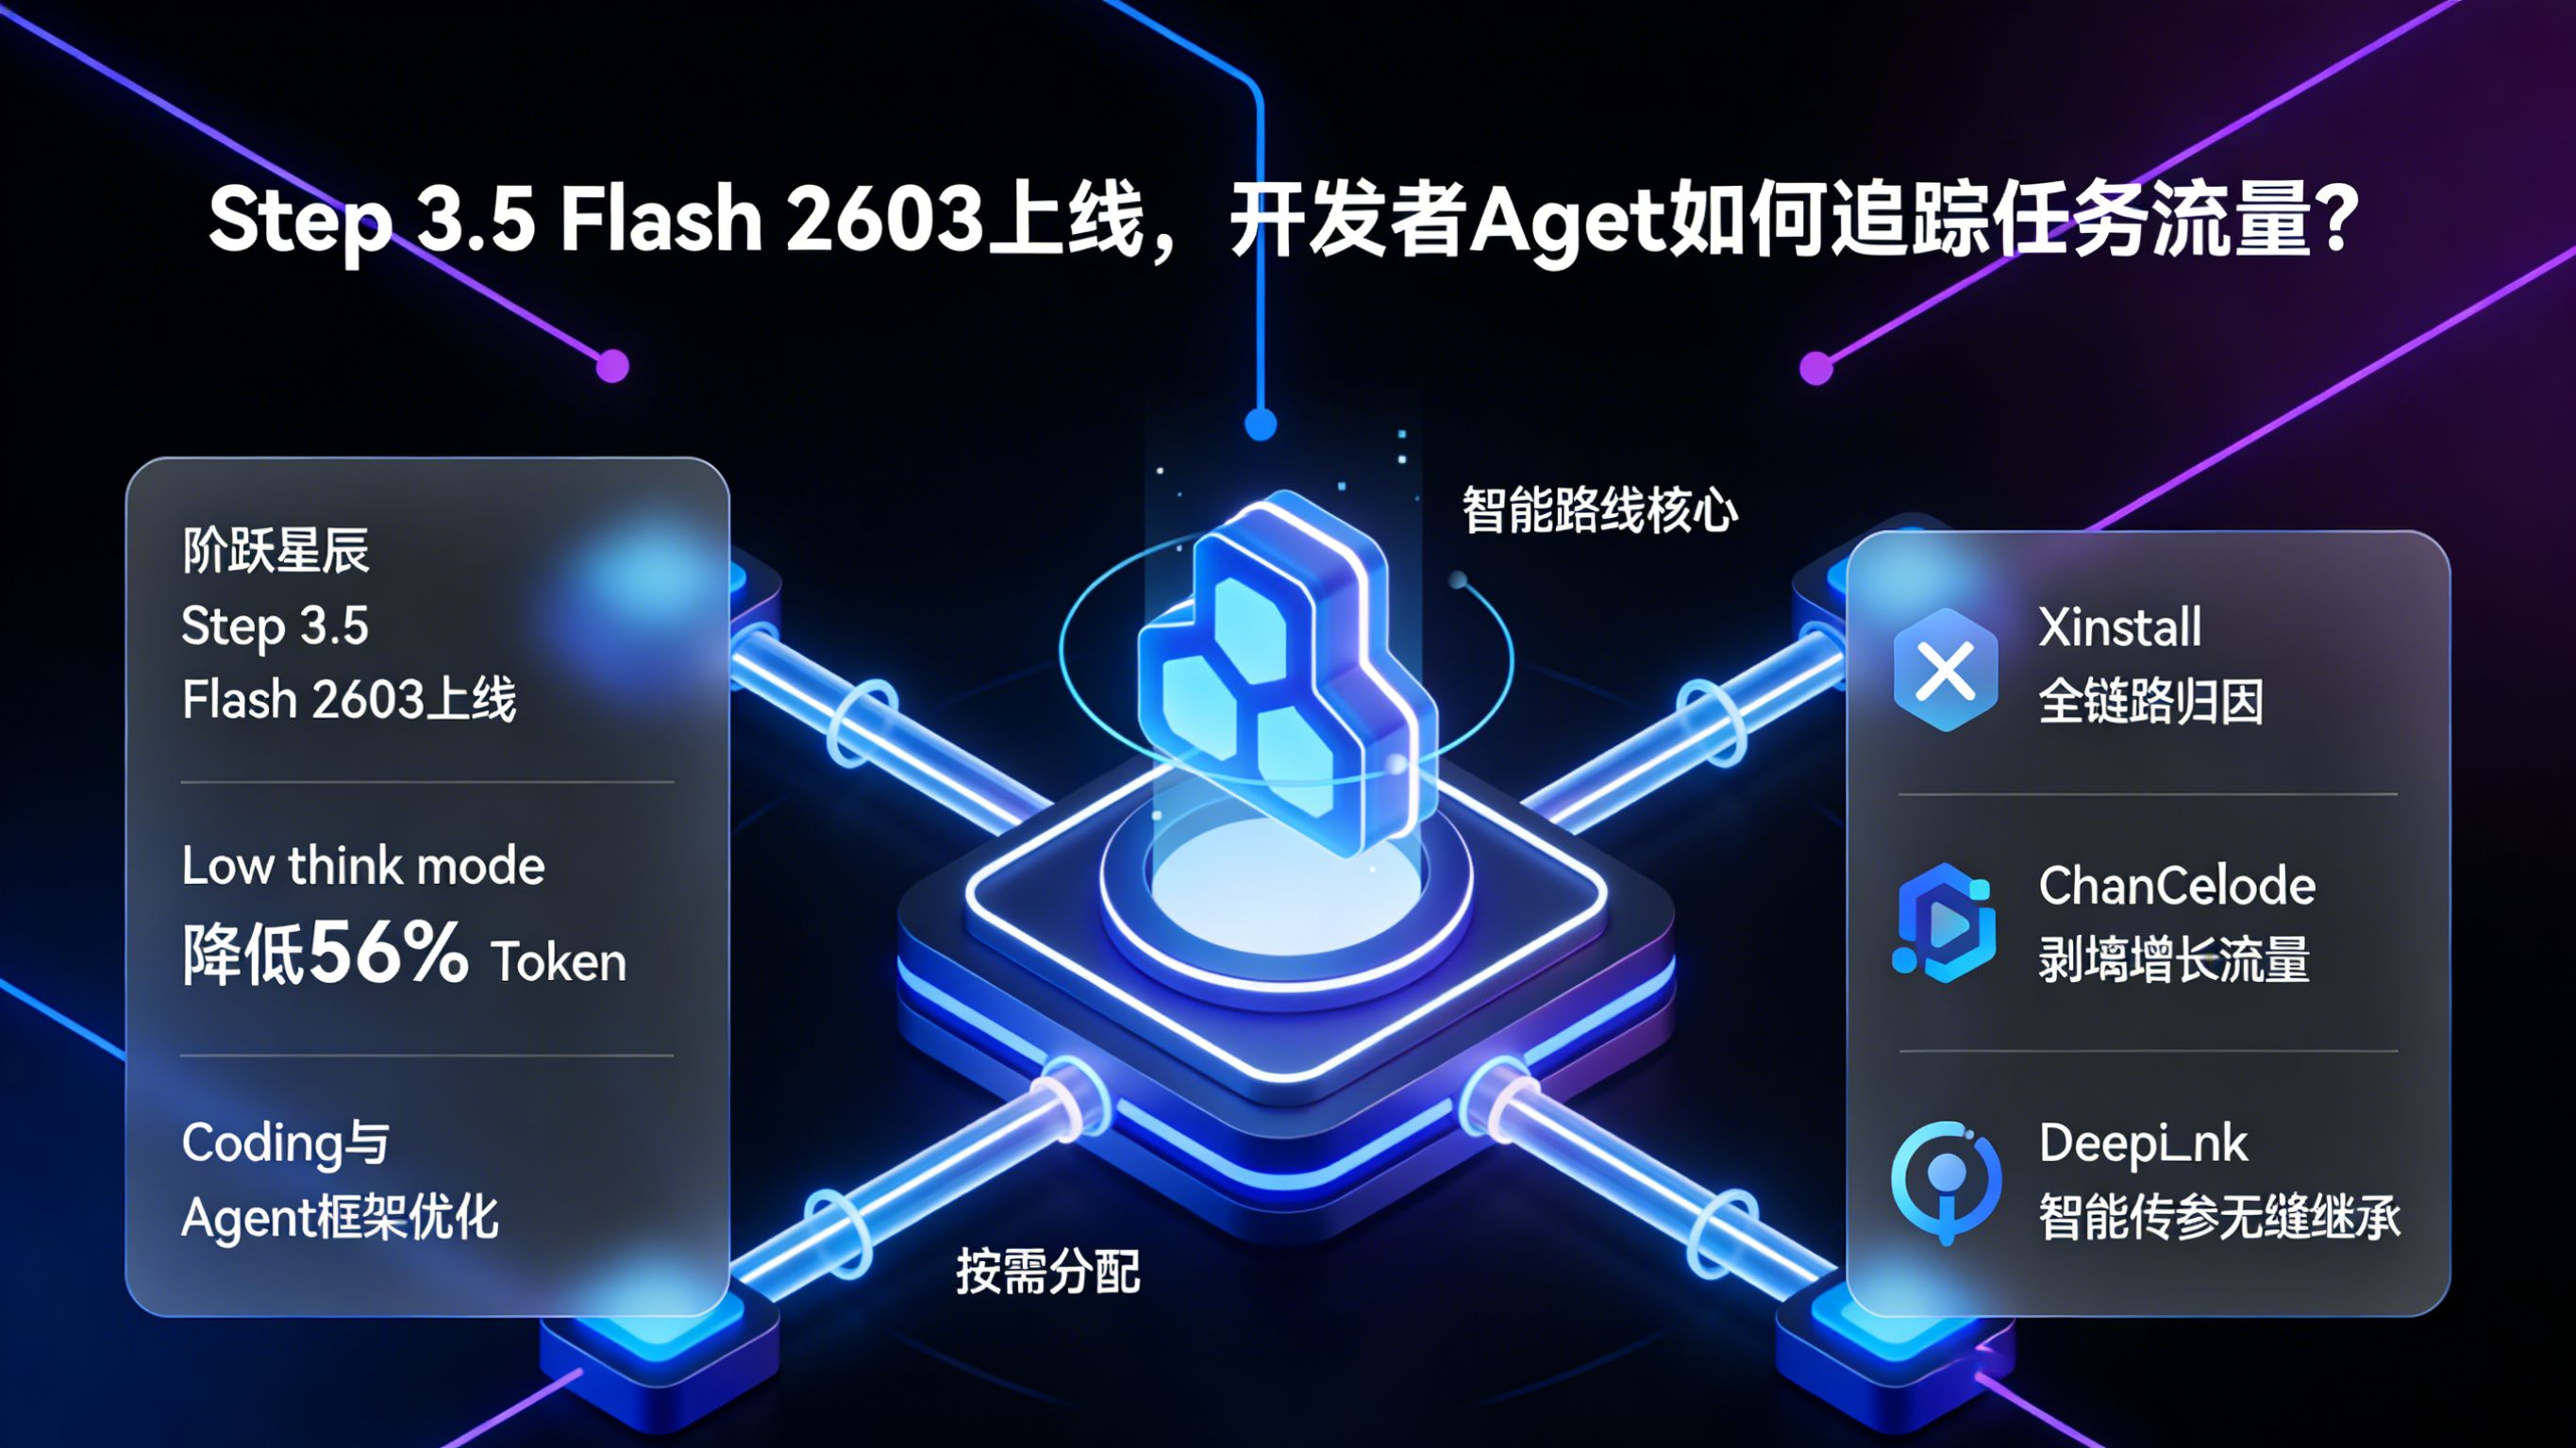
阶跃星辰上线Step 3.5 Flash 2603模型,低推理模式(low think mode)Token消耗骤降56%,专为Coding与Agent框架优化。当“按需分配”重塑AI流,开发者如何跨终端追踪任务流量与分发成本?4月2日,阶跃星辰面向Step Plan用户开放该版本。官方测试显示,默认High模式分数持平、Token降14%;切至Low模式再降56%。阶跃星辰上线 Step 3.5 Flash 新版本,新增低推理模式 团队观察到Agent场景大量高频低杂任务,通过“复杂用重型、高频用轻量”避免每步“深度思考”,精细化迭代提升响应与灵活性。对App开发者和平台方,模型矩阵细分加速Agent普及:但调用链变长、模式频繁切换,从唤起到执行的转化归因成新痛点。新闻与环境拆解Step 3.5 Flash 2603以极低成本主打Agent中间件流。核心升级:Low Think Mode降本优化版延续高响应;新增低推理模式降56% Token消耗;默认模式降14%且分数不减。场景聚焦:Coding与Agent框架专门针对这两大框架优化稳定性和Token效率;满足用户“重型+轻量”组合调用的工作流需求。行业映射:AI应用走向精细化火山豆包Token破120万亿验证B端扩张,阶跃星辰的“快上加快”则从工具向生产力基建进化。从新闻到用户路径的归因问题Agent工作流碎片化:下载IDE插件/唤起App端,来源是GitHub还是官网?多模态推理链中,“轻/重模型切换”参数丢失中断;API分发层级多,无法追踪“具体场景贡献的Token流量与ROI”。传统统计无法拆解多模式复合调用的转化路径。工程实践:重构安装归因与全链路归因渠道编号 ChannelCode:插件分发唯一标识问题:开发者经多渠道获取Agent工具,流量源混杂。做法:下载/集成接口嵌入ChannelCode,标记开源社区或文档推广等。《亚马逊 AI 战略升级?多云多 Agent 时代 App 该怎么认清流量真身》好处:精准剥离“开发者增长流量”,指导投放。智能传参安装:推理模式无缝继承问题:跨平台启动时,low_think设置与上下文易丢失。做法:DeepLink封装mode_config、agent_task_id,智能传参安装还原。《智能体分发时代 App 安装传参逻辑的底层重构》好处:App/插件启动即进入低耗模式,避免冷启动断点。参数还原与事件模型:工作流节点追踪问题:复合调用链(轻-重-轻)的转化ROI不清。做法:Session ID串联触发->中间推理->结果输出全流程。好处:可视各节点的成本与效率,优化计费模型。注:本文探讨的Agent任务分发归因属于前瞻延展。目前高度定制链路尚未标准实现,如有需求,欢迎联系 Xinstall 客服探讨研发。这件事和开发 / 增长团队的关系面向开发 / 架构团队:预留think_mode、task_complexity字段,支持流式传参;测试新版API兼容性。面向产品 / 增长团队:将低成本模式作为获客钩子,建立ChannelCode统计;挖掘高频场景流量红利。常见问题(FAQ)Step 3.5 Flash 2603有何不同?新增低推理模式降56% Token消耗,专为Coding和Agent框架优化。什么是“按需分配”?Agent流中,复杂环节用重型模型,高频中间步骤用此轻量模型,免去无效深度思考。性能有无下降?官方称默认High模式下推理分数基本持平,且Token已降14%。行业趋势?大模型正从单纯比拼参数,转向“快/省/稳”的精细化管线基建(如豆包破120万亿Token)。行业动态观察Step 3.5 Flash 2603低耗模式,加速AI从工具箱融入流水线。App团队需用全链归因穿越调用黑箱,捕捉Agent爆发红利。
458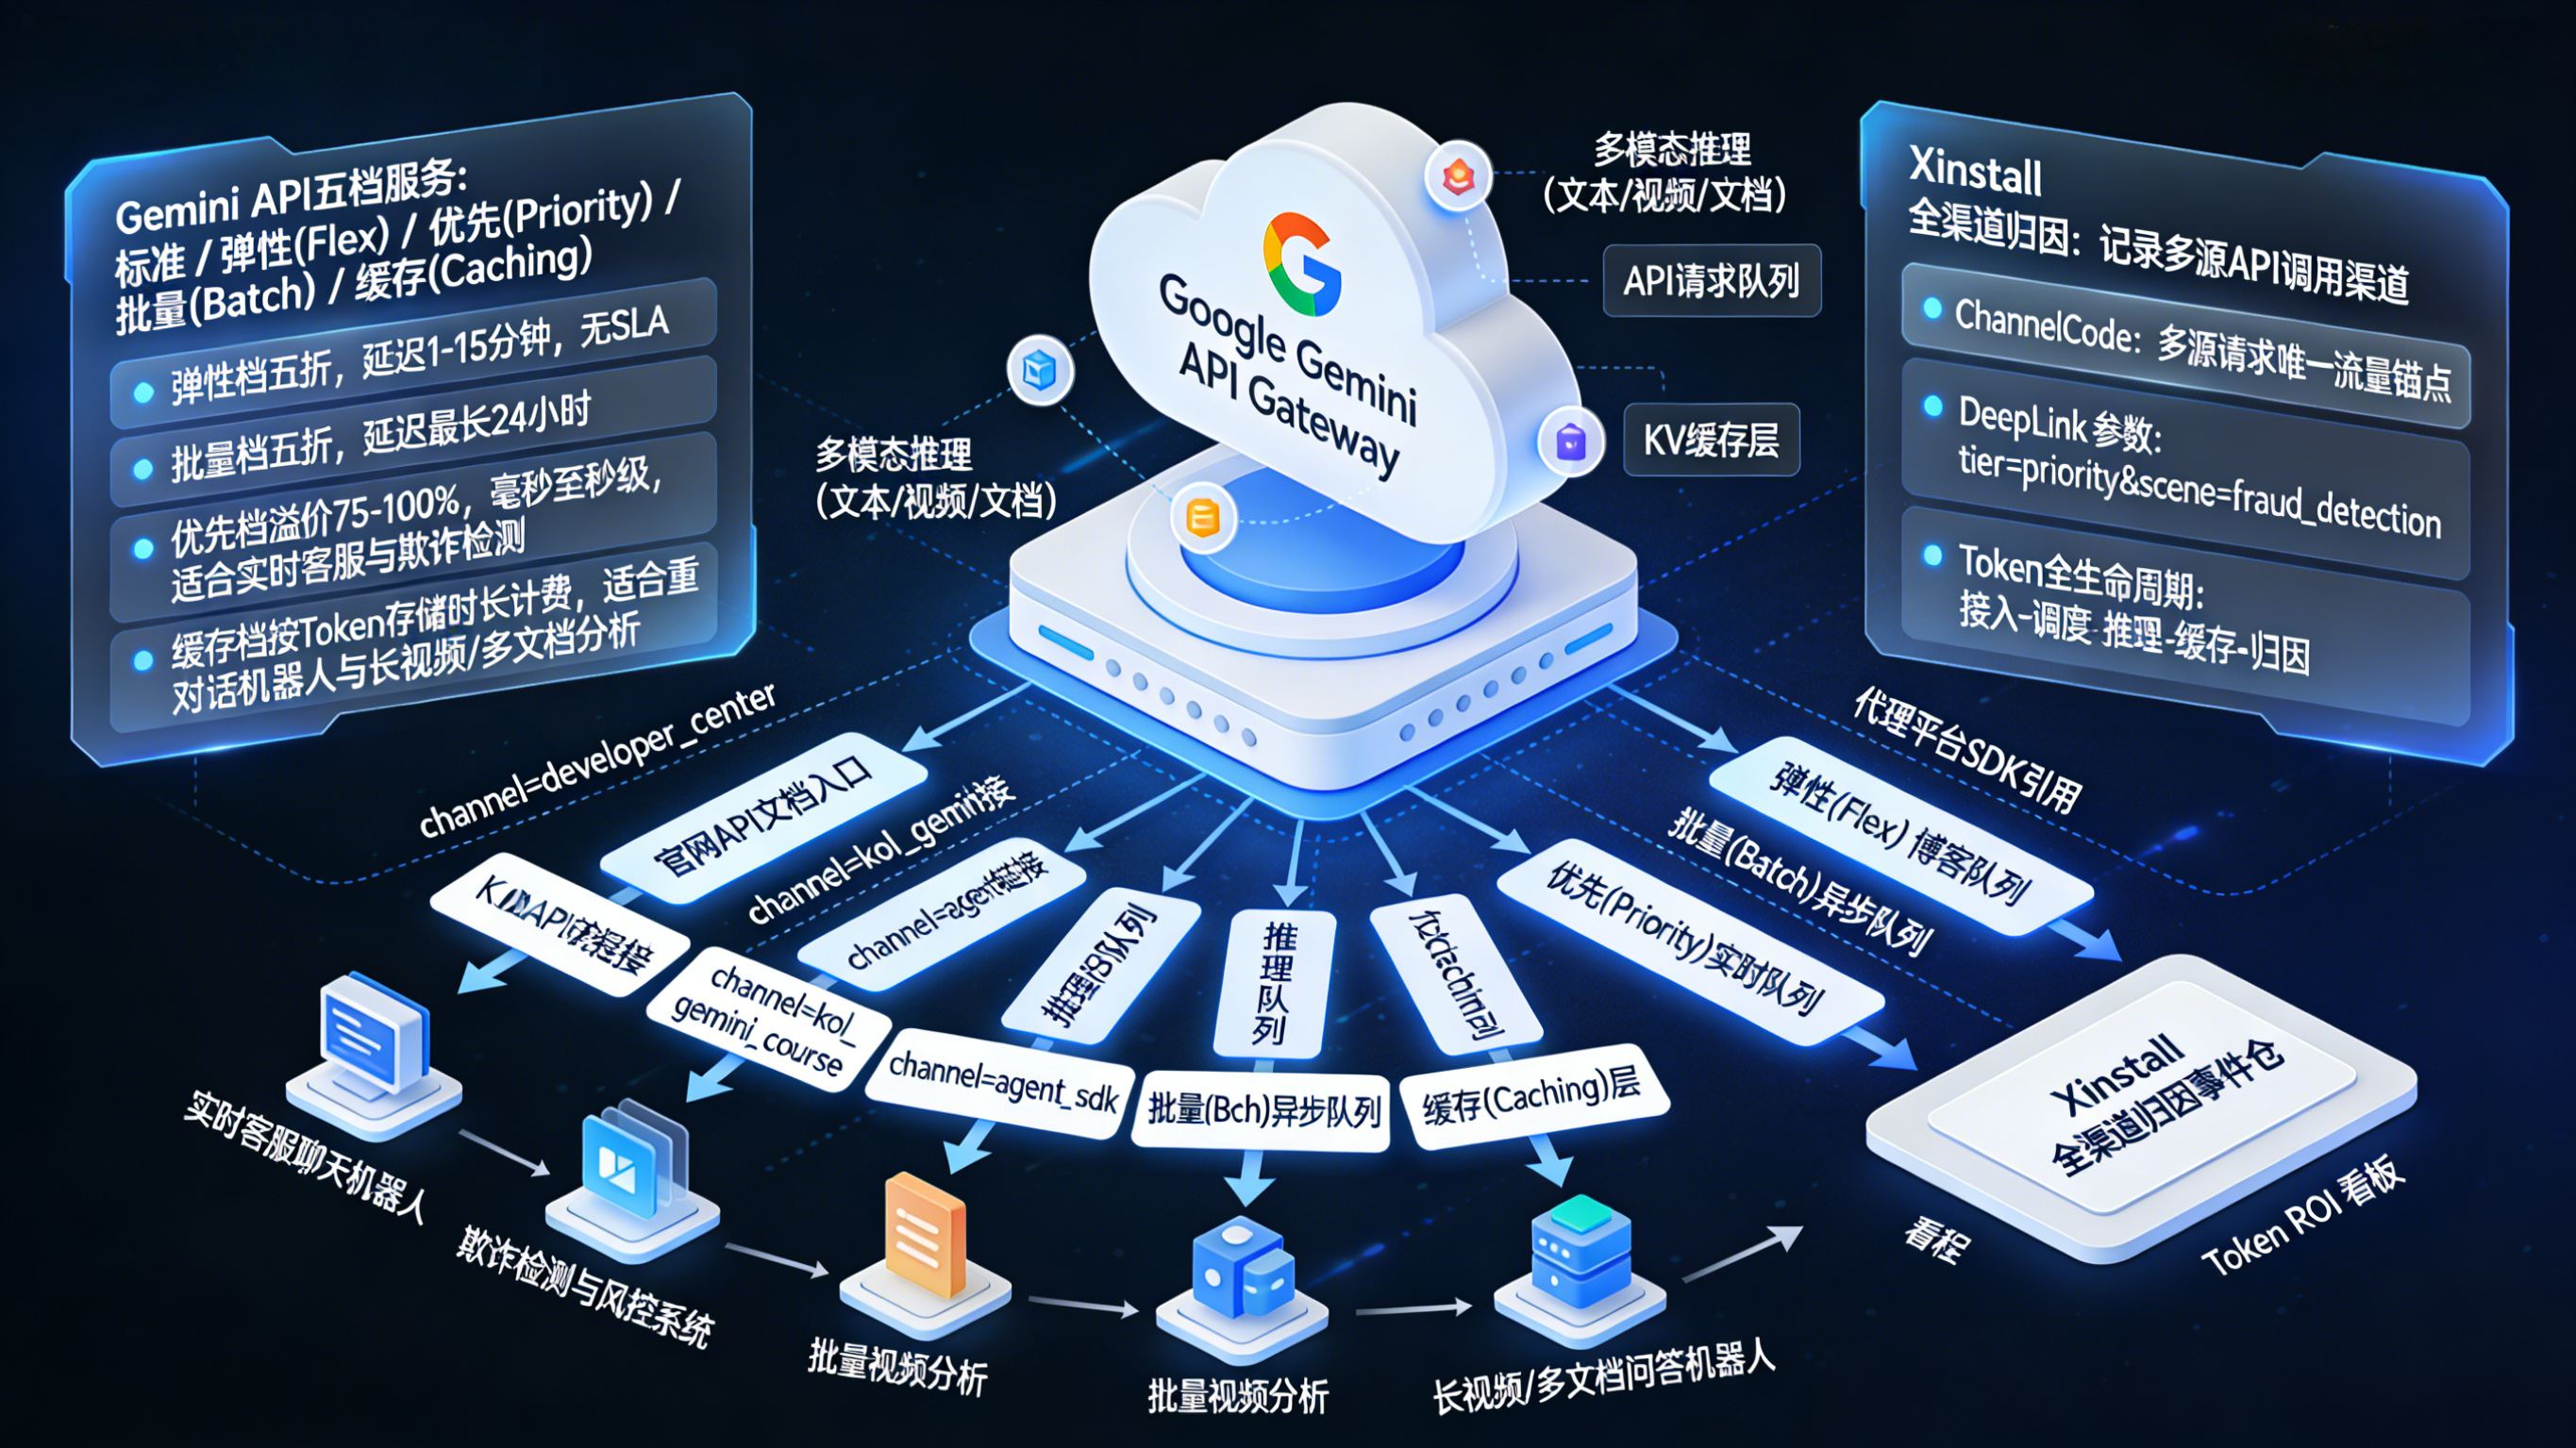
财联社4月3日消息,谷歌悄然更新Gemini API计费体系,推出标准、弹性、优先、批量和缓存五档推理服务,按实际使用场景精准分级。弹性档利用闲置算力五折优惠,批量延迟可达24小时,优先档溢价75%-100%换取毫秒响应。开发者们看到低门槛批量调用时雀跃不已,但AI产品经理却开始忧虑:在多渠道接入、多Agent工作流的复杂环境中,谁能准确统计每个档位的Token消耗来源,避免“五折弹性”变成隐形成本黑洞?新闻与环境拆解谷歌Gemini API定价调整并非简单涨价,而是对大模型服务从“统一Token计费”向“性能-成本梯度匹配”的战略转向,针对聊天机器人、视频分析等高频场景优化资源分配。五档服务的核心参数与适用场景标准档作为基准,提供稳定推理性能;弹性档(Flex)通过非高峰闲置算力实现五折优惠,目标延迟1-15分钟但无SLA保证,适合实验迭代;批量(Batch)同样五折,延迟最长24小时,适用于离线大批量处理;缓存(Caching)按Token存储时长计费,专为重复对话机器人、长视频分析或海量文档查询设计;优先(Priority)定价高出标准75%-100%,延迟控制在毫秒至秒级,谷歌明确推荐用于实时客服聊天机器人、欺诈检测和业务关键智能助手。定价背后的算力优化逻辑更新强调“基于实际推理需求”,弹性/批量降低入门门槛(五折),优先保障生产级实时性(高溢价)。例如,缓存档针对“复杂系统指令对话”场景,能显著减少重复计算成本;优先档则解决毫秒级响应痛点,直接对标企业级客服与风控需求。这一设计响应了开发者从“模型试水”到“生产部署”的全生命周期预算压力。与竞品的差异对比:谷歌的API经济新打法相较OpenAI的GPT系列统一定价,Gemini五档更细粒度:批量24h延迟对标Anthropic的异步处理,但五折更具竞争力;优先毫秒响应直击实时Agent需求,溢价合理。财联社分析,此举利用谷歌全球边缘网络闲置资源,实现“峰谷套利”,为开发者提供从“免费实验”到“企业级SLA”的完整梯度。产业影响:多模态推理服务的爆发窗口Gemini多模态能力(文本+视频+文档)将驱动聊天机器人从“问答”向“多轮交互+分析”升级。贝壳财经指出,缓存档尤其适合“长视频重复分析”,契合短剧Agent、监控风控等新兴场景。整体调整加速API从“基础设施”向“按需服务”的演进,推动开发者从自建算力转向云端精细调用。从新闻到用户路径的归因问题当科技媒体聚焦五折弹性与毫秒优先的“价格战”时,切换到AI App开发者和增长团队的视角,这场API更新瞬间暴露了“Token流量黑洞”。想象一个典型链路:用户通过官网文档、KOL教程或代理SDK接入Gemini,发起“实时客服”任务自动路由优先档,或“批量视频分析”落入五折批量。但在多Agent工作流中(Claude Code调用Gemini、OpenClaw串联多API),现有日志仅记录总Token消耗:哪个渠道带来了高价值优先任务?意图参数(如“欺诈检测场景”)在跨服务调度中丢失,导致档位错配与ROI虚高。更棘手的是,缓存Token的存储链路黑箱化,企业无法追溯“重复对话机器人”的来源贡献。工程实践:重构安装归因与全链路归因面对Gemini多档调用,开发者需底层机制串联渠道入口与推理执行。渠道编号 ChannelCode:多源API调用的统一锚点问题:订阅来自官网、社区、代理,Token来源混沌,无法分摊成本。做法:在SDK接入链接嵌入ChannelCode,利用全渠道统计随请求头传递至Gemini,确保每个推理任务携带唯一入口标识。好处:后台看板实时显示“优先档75%任务来自KOL渠道,批量ROI最高”,指导预算倾斜与返佣。智能传参安装:档位意图与场景参数端到端还原问题:任务从App发起,到Gemini执行后,意图(如“毫秒客服”)蒸发。做法:DeepLink封装tier=priority&scene=fraud_detection,智能传参安装底层捕获并注入API payload。详见xinstall在《智能体分发时代 App 安装传参逻辑的底层重构》中的实现范式。好处:自动适配档位,避免错选弹性导致延迟投诉;缓存场景下,参数确保Token复用精准。参数还原与事件模型:Token全生命周期图谱问题:无法衡量渠道对缓存/优先贡献。做法:以ChannelCode为核心,建跨API事件数据仓,串联接入-调度-推理-反馈链路。好处:可视“五折批量任务的渠道转化漏斗”,反哺Agent工作流优化。注:本文探讨的多档API场景下的Token多云归因与参数零损耗属于对未来分发趋势的前瞻性技术延展与思考,例如渠道精细化归因、跨平台一键拉起、私域裂变链路优化等前沿应用方向。目前此类高度定制化链路尚未作为标准功能全量实现,如 App 开发者有类似高阶业务需求,欢迎联系 Xinstall 客服团队进行技术探讨或共同定向研发拓展。这件事和开发 / 增长团队的关系Gemini分档计费重塑API调用经济,团队需跨层协作。面向开发 / 架构团队:预留channel_code、tier_preference字段,支持Gemini SDK异构注入;集成事件上报SDK,实现参数在多服务间的原子传递。面向产品 / 增长团队:定义渠道矩阵,将KOL/代理设高价值节点;利用ChannelCode看板,优先补贴优先档场景投放。常见问题(FAQ)Gemini API五档服务的核心区别是什么?标准档基准稳定;弹性/批量五折,延迟1-15min/24h适合非实时;缓存按Token存储计费;优先溢价毫秒级,专为客服/风控设计。弹性档为什么只提供五折优惠而不保证延迟?弹性利用非高峰闲置算力,目标1-15min但无SLA,平衡成本与可用性,适用于实验与批量迭代。缓存档适合哪些具体场景?复杂系统指令对话机器人、长视频重复分析、海量文档查询,能显著降低重复推理Token成本。优先档溢价75%-100%是否值得?针对实时客服、欺诈检测等业务关键场景,毫秒-秒级延迟换取高可靠性,对企业级Agent价值巨大。行业动态观察谷歌Gemini五档定价不是API涨价那么简单,而是宣告大模型服务进入“性能即服务”时代。当多模态推理从实验室走向生产,Token流量将取代页面PV,成为开发者饭碗的核心指标。在Claude Code、OpenClaw多Agent浪潮下,五折批量虽亲民,却放大渠道统计痛点。唯有全链归因体系,方能化海量调用为精准变现。现在,重构Token中枢,正是抢占API经济高地的战略窗口。
617
鸿蒙装机逼近1亿大关?阔直板新形态重塑移动端自适应场景还原
2026-10-21
深度链接路由分发与失败降级怎么做更平滑?深度链接降级兜底方案
2026-10-20
深度链接转化追踪与 ROI 评估怎么做更有效?深度链接转化追踪方案
2026-10-20
AI工时达员工六倍?自主智能体普及倒逼企业级全链路归因
2026-10-19
AI短剧成算力新引擎?社群私域裂变呼唤全渠道精准链路归因
2026-10-16
Meta开源8160亿模型Muse?桌面算力觉醒驱动智能体跨端无损流转
2026-10-16
活动直达内页怎么实现?深度链接活动直达方案
2026-10-15
DeepSeek拟获千亿新融资?产业资本押注倒逼任务调用ROI精准归因
2026-10-13
智能传参和 Scheme 协议有何不同?智能传参与 Scheme 对比
2026-10-12
字节发现模型长上下文漂移?任务状态保持呼唤高可靠数据穿透
2026-10-12
字节发现模型长上下文漂移?任务状态保持呼唤高可靠数据穿透
2026-10-09
邀请关系怎么自动绑定?智能传参邀请关系绑定
2026-10-08
三星利润飙升782%?存储超级周期倒逼端侧应用长程任务优化
2026-10-08
免填邀请码机制怎么实现?智能传参免填邀请码
2026-10-07
预约下载怎么提升转化?深度链接预约下载优化
2026-10-07