手机微信扫一扫联系客服
联系电话:18046269997


 APP安装免填邀请码
 社交分享效果统计
 广告投放数据统计
 CPA/CPS推广效果统计
 App地推统计
 App拉起
 网页/应用内直接安装
 Android多渠道打包
 App安装后自动绑定
 App分享效果统计
 Deeplink深度链接
手机微信扫一扫联系客服
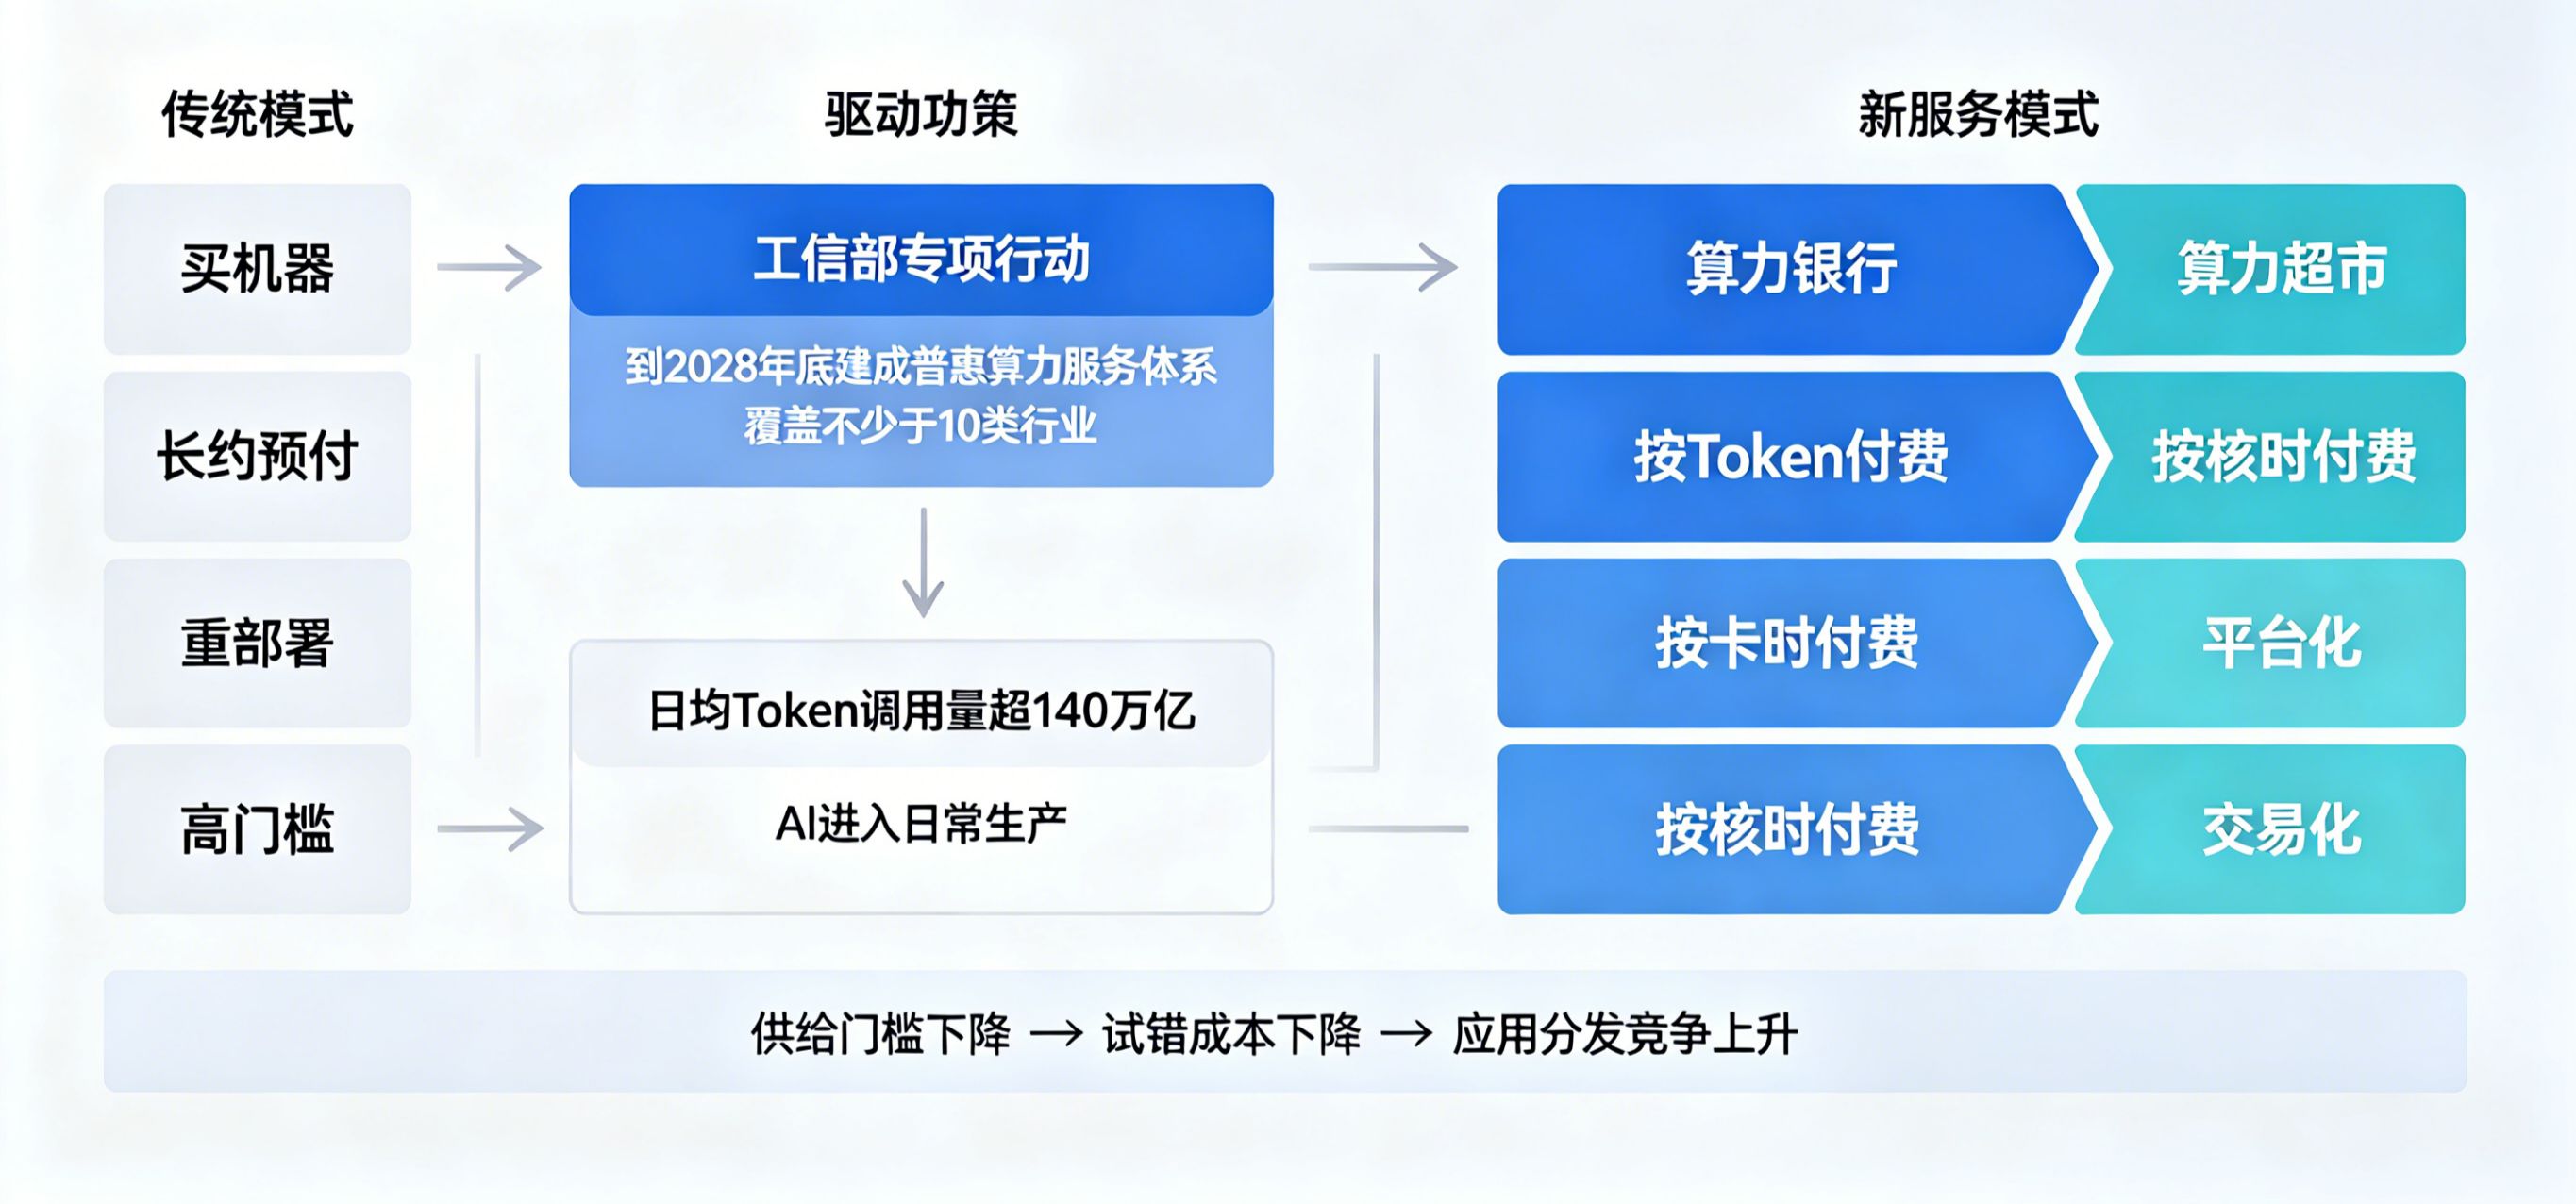
“算力银行”“算力超市”第一次被写进工信部面向中小企业的专项行动里,这不是一个新概念包装,而是算力服务模式开始正式走向平台化、标准化和交易化。对很多AI应用团队来说,这件事真正重要的地方,不在于又多了几个政策热词,而在于供给侧的门槛正在被快速拉低:过去做一个可上线的AI应用,先要想模型、想GPU、想成本;接下来,越来越多团队可能只需要像买云资源一样,按Token、按卡时、按核时获取所需能力。这会直接改变AI应用的生长方式。模型能力继续上行当然重要,但当算力不再是头部公司的专属稀缺品,真正拉开差距的,很可能不再只是“谁更能训模型”,而是“谁更快把应用做出来、推出去、接住流量并把任务转成留存”。新闻与环境拆解“算力银行”“算力超市”为什么现在出现从官方披露的数据看,这波政策并不是拍脑袋出台。近年来我国算力总规模年增速保持在30%左右,而算力调用规模上升得更快。国家数据局统计显示,截至今年3月,我国日均 Token 调用量已经超过140万亿,相比2024年初的1000亿增长了1000多倍,和2025年底的100万亿相比,短短3个月又增加了40%以上。这组数字的含义很清楚:今天企业对算力的需求,已经不是“要不要上AI”,而是“AI开始进入日常生产”。一旦调用量级跨过某个临界点,传统那套长期签约、大额预付、重采购、重部署的模式就会越来越不适配,尤其是对中小企业而言。从“买机器”到“买服务”此次专项行动最值得关注的一点,是工信部首次明确提出探索“算力银行”“算力超市”等创新业务。这个表述虽然带有形象化色彩,但背后的逻辑其实非常实用。“算力银行”更像一种资源存取与调度机制。企业或机构可以把闲置算力资源“存入”平台,通过跨区域、跨周期调度实现灵活调用,让本来沉淀的资源变成可交易、可流动、可复用的能力。“算力超市”则更接近一个标准化交易入口。平台汇聚不同供应商的算力产品,支持按卡时、核时、Token 等方式灵活付费,用户可以直接在线选择、下单、使用。它像电商,不是因为页面像商城,而是因为交易对象被标准化了,购买动作被简化了,使用门槛被压低了。这意味着算力正在从重资产变成轻服务,从少数企业才能掌握的“基础设施能力”,变成越来越多团队能够按需调用的“生产要素”。为什么这件事特别利好中小企业过去很多中小企业不是不想做AI,而是算不过账。自己买卡、租机、拉专线、配运维,前期投入高,利用率还未必稳定。一旦业务需求呈现“小批量、碎片化、临时性”,传统方案的成本结构就会迅速失真。而这次政策恰恰对准了这个问题。通知提出,到2028年底,要基本建成覆盖广、成本低、服务优、生态活、人才强的普惠算力服务体系,并在中小企业划分标准适用的15类行业中覆盖不少于10类门类。换句话说,算力普惠不再只是面向少数技术企业,而是准备进入更广泛的实体行业和中小企业日常经营。这类变化对开发者的意义非常直接:未来会有更多行业型、区域型、场景型 AI 应用出现。以前做不了的轻量化垂直应用,可能因为获取算力更便宜、试错成本更低,而突然变成能成立的产品。地方与产业链已经开始试运行这不是纸面规划。上海电信“算力超市”已经上线运行,对接青浦、临港“东西两翼”智算中心,面向算力供应商、中小企业和公众开放,支持算力服务商入驻,也支持智算单卡、多卡、裸金属、GPU云主机等服务在线订购,并具备多级账号管理和精准计量计费等能力。河南空港智算中心则走了另一条更贴近应用层的路径。作为中部地区首个全面接入 DeepSeek 大模型的智算中心,它通过“一点接入、即取即用”的方式降低中小企业使用主流 AI 模型的门槛。国产 AI 芯片企业太初元碁为其搭建了智算底座,并完成 Token API 接口部署,让企业不必先做大额投入,也能通过 Token 计费方式调用国产智算能力。同时,中心还提供 Token 试用服务,帮助中小企业和高校降低试错成本。这些案例说明,算力普惠已经不只是“给资源”,而是在往“算力+模型+应用”的一站式供给方向走。从新闻到用户路径的归因问题大众看到“算力银行”“算力超市”,第一反应通常是:以后做AI更便宜了,更多公司会做AI应用。这当然没错,但对 App 开发者、增长负责人和数据团队来说,更关键的问题不是“供给会不会变多”,而是“供给变多以后,流量怎么认、场景怎么接、任务怎么追”。因为算力门槛一旦下降,AI应用的数量很可能会迅速增加,应用形态也会更碎片化。很多产品不再是一个标准 App 承接所有用户,而可能是一个行业 Agent、一个嵌入式工作台、一个插件化工具、一个网页小入口,甚至是一段被调用的能力接口。用户也不一定总是“人点开页面再安装”,更多时候会先在别的平台、别的工作流、别的任务上下文里调用某个能力,再回到你的产品。这时,传统的页面级埋点和下载来源统计会越来越不够用。问题会集中出现在三个地方:第一,入口变碎。用户可能来自“算力超市”平台专区、地方中小企业公共服务平台、某个行业 SaaS、某个模型应用市场,或者某个企业内部系统。表面看都是“外部导入”,实际上用户意图、任务场景和转化质量完全不同。第二,任务替代页面。过去很多增长分析围绕页面访问、按钮点击、安装激活展开;但 AI 应用的真实使用越来越像任务链路:谁发起任务、任务在哪个平台创建、在哪个 Agent 中执行、最后由哪个 App 或服务完成交付。页面只是壳,任务才是“流量真身”。第三,场景容易丢。一个用户可能先在地方“算力超市”试用 Token,再通过模型接口跑出结果,然后再进入某个应用完成落地。如果安装、注册或首次打开时,前面的任务上下文丢了,产品端就很难知道:这个用户到底是因为哪个场景而来,他本来想做什么,他是不是来自有价值的行业试点项目。这就是为什么“普惠算力”看起来像供给侧新闻,实际上会很快变成“分发与归因问题”。工程实践:重构安装归因与全链路归因用 ChannelCode 先把入口收束起来问题在于,入口一旦变成“算力超市专区、园区服务平台、智算中心门户、模型应用市场、合作 SaaS 嵌入位”这种多来源结构,靠传统 campaign_name 或手工备注几乎无法长期管理。更稳妥的做法,是给每一个可控入口配置统一的 全渠道统计 标识体系,用 ChannelCode 把“来源平台、合作方、地区、行业、场景”编码进同一套入口标识中。比如可以区分“上海算力超市-金融专区”“河南智算中心-高校试用”“某SaaS工作流-制造业工具链”等不同来源。这样做的好处是,哪怕前端入口五花八门,后台仍然可以在同一张看板里识别不同来源流量的真实质量。对增长团队而言,入口定义权不再掌握在外部平台手里,而是能回到自己的统计体系中。如果你在设计 AI 应用的流量接入策略,可以直接参考 xinstall 在《亚马逊 AI 战略升级?多云多 Agent 时代 App 该怎么认清流量真身》里讨论过的核心思路:先统一入口,再谈归因精细化。否则渠道越多,报表越乱。用智能传参把任务上下文带进 App入口识别解决的是“用户从哪来”,但 AI 应用更棘手的问题在于“用户为什么来”。假设一个中小企业用户先在“算力超市”里选择了 GPU 云主机,接着调用某个模型服务,又在一个行业模板中生成了初步结果,然后才进入你的 App 继续完成报表整理、客服自动化或知识库检索。如果安装完成后 App 只能看到一个“新用户首次打开”,那前面的业务上下文几乎全丢了。这时就需要 智能传参安装 来把场景和意图从入口带入产品内部。你不只是要记录“来自哪个平台”,还应该带上 scene、workspace_id、workflow_id、model_plan、industry_tag 这类关键上下文字段,让产品首启后能自动识别用户要完成什么,而不是把所有人都扔回首页重新摸索。这样做带来的好处有两个:一是首启体验更完整,用户会感觉这个产品“知道我为什么来”;二是数据层不再只记录一次安装,而能记录一次有上下文的任务承接。关于这套“链接携参 → 安装 → 首启 → 参数还原”的底层逻辑,可以直接沿用 xinstall 在《智能体分发时代 App 安装传参逻辑的底层重构》中提到的方法,把入口场景、任务上下文和产品承接串成一条完整链路。用任务事件图替代单点转化报表算力普惠之后,越来越多 AI 产品不会只处理“安装—注册—付费”这条单线漏斗,而会出现更复杂的任务流量。比如某个企业先领到“算力券”,然后在地方平台试跑模型,再调用某个行业 Agent,最后把结果提交到内部系统或第三方 App。如果你的数据体系只能看见“下载量”“激活量”“付费率”,就很难真正理解哪条业务路径有效。更合理的方式,是把任务流量纳入事件图:谁发起任务,agent_platform、agent_id任务属于哪个工作流,workflow_id来源于哪个入口,channelCode属于什么业务场景,scene当前权限和风险级别如何,risk_level有了这些字段,开发和数据团队才能开始真正观测 AI 应用的真实增长过程:不是谁来看了页面,而是谁把任务带过来了、任务在哪里完成、哪里发生了掉线或失败。注:本文探讨的“多平台算力入口 + 多 Agent 调用链 + 任务级归因”属于对未来 AI 分发趋势的前瞻性技术延展与思考,例如渠道精细化归因、跨平台一键承接、私域任务链优化等方向。目前此类高度定制化链路并未全部作为标准功能统一落地,如团队已经出现较复杂的多入口、多 Agent、高阶参数还原需求,欢迎联系 Xinstall 客服团队进行技术探讨或联合定向研发。这件事和开发 / 增长团队的关系面向开发和架构团队现在最值得做的,不是急着追风口,而是把“未来会有更多任务级流量进入系统”这件事提前写进架构里。可以优先补这几类能力:预留入口参数字段,如 channelCode、scene、workflow_id、agent_platform区分人物流量与任务流量,避免全部混在同一套事件里首启路由支持按参数分发,而不是一律返回首页数据仓表结构支持多平台、多阶段事件串联如果今天不做,等渠道和 Agent 真多起来,再补会很痛苦。面向产品与增长团队产品和增长侧要重新定义“获客”这件事。算力普惠之后,用户不一定从广告来,也不一定从应用商店来,很多高质量用户会从“试用算力”“行业专区”“工作流入口”“合作平台模板”这类非传统入口进入。这意味着:入口设计要比投放本身更重要试用链路要比下载页更重要任务完成率要比表面激活率更重要如果团队还在用移动互联网时代那套“买量—安装—留存”的单线思路理解 AI 应用增长,很容易错过真正有效的流量。现在就能做的三件事开发团队先补参数字段与任务事件模型。产品团队先梳理“从外部平台进入本产品”的所有入口。增长团队先把渠道看板从“页面点击”升级为“任务来源 + 场景来源”。常见问题(FAQ)“算力银行”和“算力超市”到底有什么区别?“算力银行”更强调资源的存取、调度和复用,核心是把闲置算力变成可流通能力;“算力超市”更强调标准化交易和在线选购,核心是让企业能像买云服务一样按需购买算力。一个偏资源管理,一个偏服务交易,但两者都在降低企业获取算力的门槛。为什么中小企业会特别需要这种模式?因为中小企业的算力需求往往不是全年稳定的大单量,而是小批量、碎片化、阶段性的。传统长期绑定、大额预付的服务模式成本太高、灵活性太差,而按 Token、卡时、核时计费更接近它们的真实业务节奏。“算力超市”已经有实际案例了吗?有。上海电信“算力超市”已经上线运行,可提供智算单卡、多卡、裸金属、GPU 云主机等服务在线订购,并支持多级账号管理和精准计量计费。它说明这件事已经从政策提法走向实际平台运营。为什么这条新闻会影响 AI 应用分发?因为算力一旦普惠,AI 应用的供给会更快增加,应用入口会更多元,用户路径也会更碎片化。到那时,谁能更好识别入口、还原场景、承接任务流量,谁就更有机会把“算力可得”变成“增长可得”。行业动态观察“算力银行”“算力超市”真正改变的,不只是算力怎么买,而是 AI 应用怎么长出来。过去很多产品死在算力门槛,未来更多产品可能死在分发门槛。供给侧一旦繁荣,流量识别、任务承接和归因解释权会迅速成为新的竞争点。对 App 团队和 B 端产品团队来说,现在是一个很关键的窗口期:一边是政策在推动算力普惠,一边是任务流量正在替代传统页面流量。谁能先把渠道识别、智能传参和任务事件图搭起来,谁就更有机会接住这一波由算力下沉带来的真实应用增长。
 783
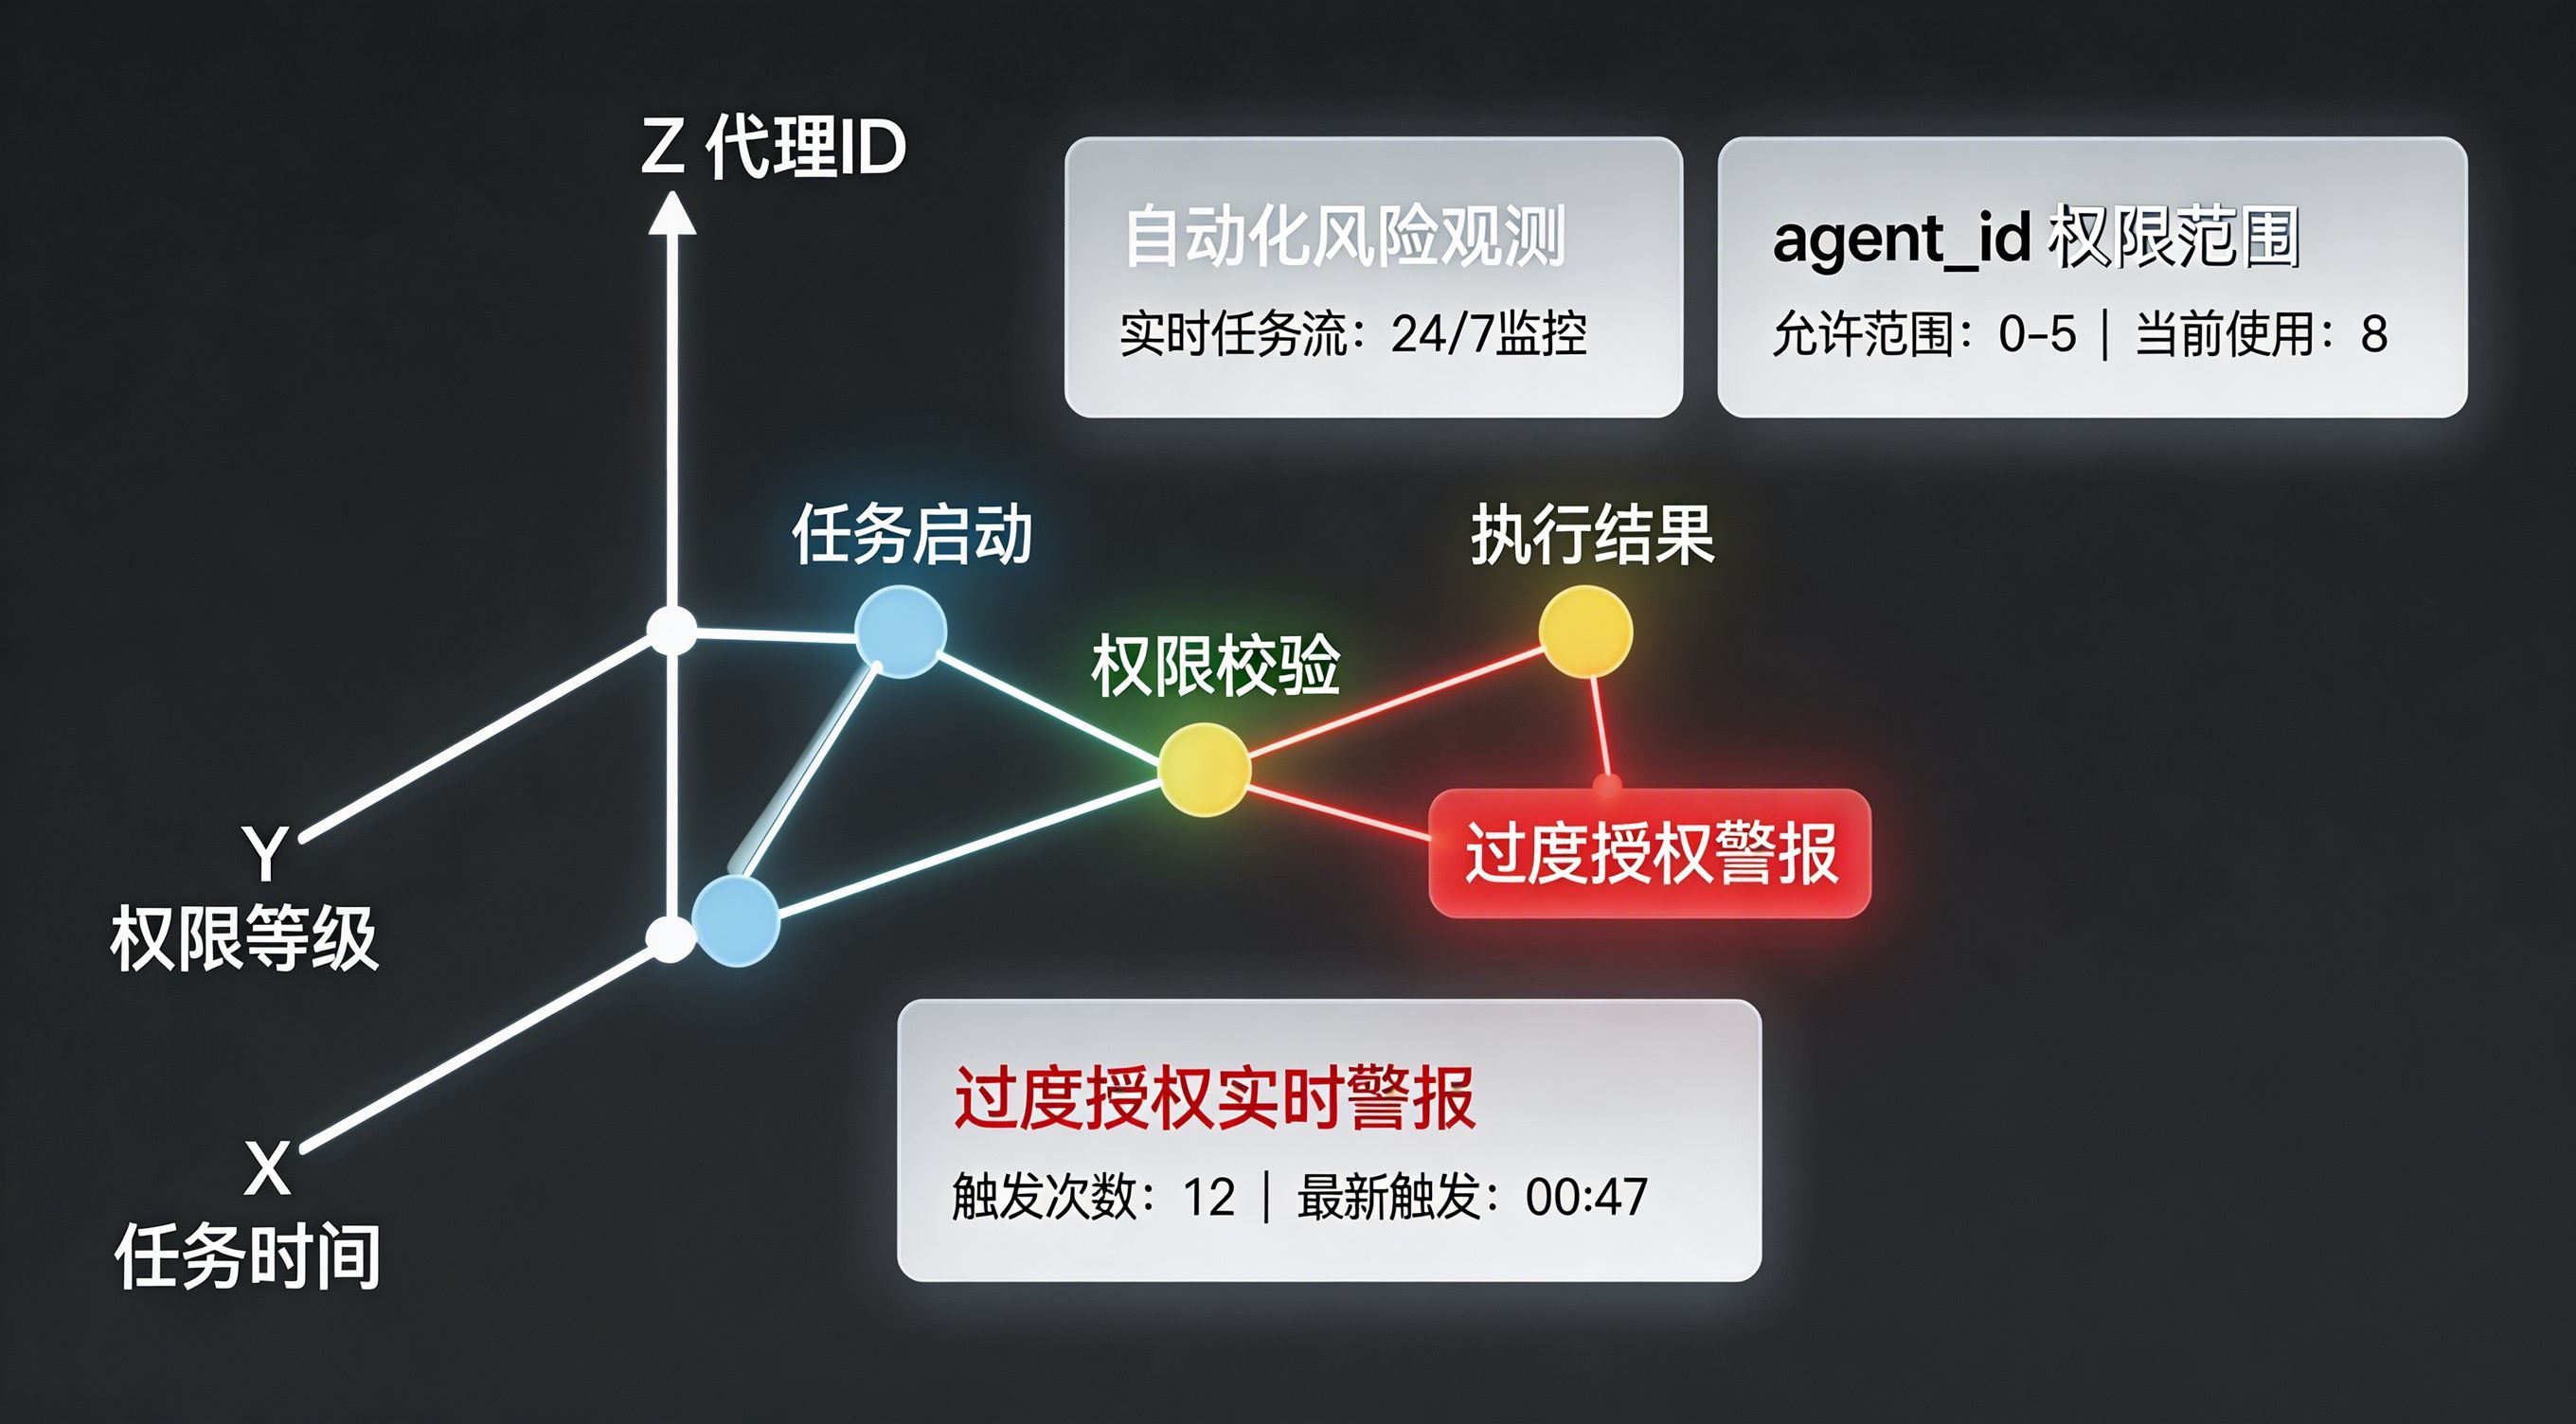
基础设施身份管理厂商Teleport发布的“2026年企业基础设施安全AI现状报告”显示,为AI系统授予过度访问权限的企业,安全事件发生率是权限管控合规企业的4.5倍。该报告调研了205位CISO、安全架构师与平台负责人,发现身份管理体系建设进度完全跟不上AI落地速度。这份报告不是泛泛的安全警示,而是直指企业级AI部署的核心痛点:权限滥用已成为生产环境的最大隐患。对App开发者、增长团队和架构师来说,它意味着任务授权、数据流转和跨系统调用必须重新审视。新闻与环境拆解调研背景与关键数据报告基于2025年12月对员工规模500至10000人的企业调研。92%的企业已在生产环境上线AI,85%的安全负责人担忧风险,59%遭遇或疑似AI安全事件。过度权限企业事件率76%,最小权限仅17%。Teleport CEO Ev Kontsevoy称:“不安全的并非AI本身,而是我们赋予它的权限。”AI仅是压垮身份管理的最后一根稻草,基础设施复杂度已让用户组/角色数超过员工总数。权限发放的结构性问题67%企业用静态凭证给AI,事件概率升20%。跨工具/环境运行的智能体继承全权限,配置错或泄露即放大影响,仅3%企业有机器自动化管控。43%企业AI每月无人监督改配置,7%不知变更频率。报告反常识发现:对AI部署最自信的企业,事件率是保守者的两倍。可见性不足是根源,79%企业评估自主AI,但仅13%做好防护。行业共振与类似研究Lumos Identity同期研究显示,96%企业遇身份事件,55%归咎过度授权。Brittney Diesel评论:“身份体系成核心控制平面,管控人与机器及AI智能体。”43%企业无AI治理规范,21%无管控,差距巨大。报告建议:统一身份层,用短时最小权限凭证替换静态凭证,机器自动化治理取代人工审核。从新闻到用户路径的归因问题企业部署AI Agent时,常给宽泛权限让它跨系统调用工具。但当Agent发起任务到外部App或服务,路径就变复杂:谁授权、权限边界在哪、调用失败时谁负责?传统归因只看最终安装/激活,忽略任务来源、权限继承和风险信号,导致事件追溯难,安全盲区多。例如,Agent用静态凭证调用App,失败时不知是权限不足还是参数错。过度授权放大风险,事件率4.5倍。工程实践:重构安装归因与全链路归因ChannelCode:入口与权限标识用ChannelCode统一标注任务来源和权限级别,如agent_platform、risk_level。链接嵌入code,App首启解析,确保权限匹配场景。智能传参安装:最小权限还原传参携带agent_id、workflow_id、scene,确保App只获必要权限。沙箱还原参数,云端短时匹配,避免静态凭证泄露。任务事件图:自动化风险观测构建事件图:任务发起、执行、权限校验、结果回传。结构化日志汇聚数据仓,实时警报过度授权。注:本文探讨的AI权限多端还原属于对未来分发趋势的前瞻性技术延展,目前高度定制化链路尚未标准实现,欢迎联系Xinstall探讨。这件事和开发 / 增长团队的关系面向开发团队预留权限参数接口,沙箱校验传参。设计事件模型:agent_id、permission_scope。支持最小权限模式。面向增长团队优先最小权限任务投放,监控risk_level转化。A/B测试权限边界对留存影响。面向数据团队分离用户/任务流量,权限事件入仓。自动化审计,事件率<17%目标。常见问题(FAQ)Teleport报告调研覆盖哪些企业?员工500-10000人企业,92%已上线AI生产环境。为什么过度授权事件率4.5倍?宽泛权限放大配置错/泄露影响,静态凭证占67%,事件升20%。AI权限治理怎么起步?统一身份层,短时最小权限凭证,机器自动化取代人工。报告反常识结论是什么?AI部署最自信企业,事件率是保守者的两倍,可见性不足。行业动态观察Teleport报告印证AI权限成基础设施痛点,92%企业上线但治理滞后。事件率4.5倍警醒:从“能用”到“可控”需跨层重构。对团队是机遇:任务归因从安装数到权限图,抓准最小权限分发,将安全变增长护城河。窗口期正开,谁先建好身份+归因栈,谁先领先。
559
Android API怎么调用?移动端开发者如何利用系统接口与 SDK 实现 App 的高精度来源参数回传?在移动增长和 App 开发领域,行业里越来越把高精度的安装来源追踪与参数回传视为打通跨端业务链路的技术底座。然而,安卓生态极其碎片化,各种系统 API 的调用时机与权限限制常常让开发者头疼不已。本文将深入剖析底层 Intent 解析与异步回调函数,结合真实的代码实战诊断案例,带你避开生命周期冲突的坑洞。客观而言,利用第三方成熟封装的 SDK(如 Xinstall)可以大幅降低直接调用底层网络与系统 API 带来的冗余维护成本,帮助研发团队在跨端归因场景中实现开箱即用。移动端渠道参数回传的底层 API 逻辑在 Android 开发中,实现 Web 端到 App 端的参数传递,其核心依赖于系统底层的意图机制与设备特征匹配方案。理解这些原生 API 的运作原理,是解决参数丢失问题的第一步。Intent 机制与 App Links 意图拦截Android 系统在处理外部唤起(如用户在浏览器中点击推广链接)时,最核心的通信枢纽就是 Intent 对象。当一个标准的外部 URI 触发时,系统会向下分发意图,开发者需要利用谷歌官方推荐的 App Links 规范,在应用中进行精准拦截。在具体实现上,开发者需要在 AndroidManifest.xml 中为特定的 Activity 配置 intent-filter,声明支持的 scheme 和 host。当 App 被成功唤起后,在对应 Activity 的 onCreate 或 onNewIntent 生命周期内,通过调用系统 API getIntent().getData() 即可解析出完整的 URI 结构。随后,利用 Uri.getQueryParameter("channel") 等方法,即可精准提取出拼接在推广链接后的动态参数。这种方式适用于用户已安装 App 的“热启动”场景,能够实现毫秒级的参数直达。剪贴板读取 API 与设备特征采集如果用户是首次点击推广链接且尚未安装 App(即冷启动),传统的 Intent 机制就会失效,因为应用商店的下载过程会切断 URI 参数的直接传递。此时,底层实现通常需要依赖 Android 的 ClipboardManager API 或者设备非隐私环境特征的采集。前端 H5 页面在用户点击下载的瞬间,会将包含渠道 ID 的特征码隐秘写入手机剪贴板。当 App 首次安装并打开时,调用剪贴板 API 读取系统剪切板内容,并通过特定的正则表达式提取参数。如果剪贴板方案因系统版本受限,代码还需要调用 android.os.Build 系列 API 获取当前机型的系统版本、屏幕分辨率以及网络 IP 等弱特征,向后端的归因服务器发起异步请求,进行模糊匹配以还原下载前的来源参数。SDK 接口接入与核心权限配置为了避免重复造轮子,绝大多数开发团队会选择接入成熟的统计与参数回传 SDK。但在接入第三方库时,基础的 Android 工程配置往往是引发编译报错的重灾区。Manifest 权限声明与构建环境依赖任何涉及网络通信和参数回传的 API 调用,都必须在工程的基础配置文件中声明系统权限。开发者需要在 AndroidManifest.xml 中显式添加 <uses-permission android:name="android.permission.INTERNET"/> 以及获取网络状态的权限。结合 [androidsdk环境配置](F49 URL 占位) 的最佳实践,在现代 Android Studio 工程中,还需要在模块级的 build.gradle 文件中正确引入依赖库。由于不同 SDK 可能会内部嵌套特定版本的网络请求库(如 OkHttp)或 JSON 解析框架(如 Gson),很容易在编译阶段引发类冲突。通过合理使用 Gradle 的 exclude 语法或强制统一依赖版本(Resolution Strategy),可以有效保障构建环境的纯净与稳定。防止 API 拦截的混淆规则(ProGuard)设置很多新手开发者经常遇到一个诡异的现象:在本地 Debug 环境下,一切网络回调和参数解析 API 都运转正常,但一旦打包成 Release 混淆包推向市场,参数接口就彻底失效甚至导致 App 崩溃。追溯其底层原因,在于 R8 或 ProGuard 混淆工具为了压缩包体,将用于接收回调数据的 Java Bean 实体类名或核心的 SDK 接口方法名混淆成了无意义的字母(如 a.b.c)。这直接导致反序列化框架在进行 JSON 字段映射时找不到对应的目标属性,从而返回 Null。为了解决这一痛点,必须在项目参考 [sdk下载与安全校验](F66 URL 占位) 的安全规范,在 proguard-rules.pro 文件中针对相关包路径显式添加 -keep class 防混淆指令,确保回调实体与对外暴露的 API 方法原样保留。代码实战诊断:排查异步回调中的参数丢失底层 API 的调用时机一旦出错,就会在复杂的 Android 生命周期中引发难以察觉的数据丢失。以下是一个关于异步回调错位的真实代码排查案例。异常现象:冷启动携参率低下与新增断层某垂直电商 App 在自主接入了一套用于渠道参数回传的网络 API 后,业务部门发现了一个严重的数据断层:在热启动(即用户手机后台已挂起该 App)时,点击外部链接唤起 App,参数获取的成功率高达 100%。然而,对于首次前往应用商店下载安装的“冷启动”新用户,后台数据库日志显示有接近 40% 的新增设备回调参数为空(Null)。这直接导致大量新用户的首单奖励无法正常发放到账,引发了极其严重的客诉。数据与诊断过程:主线程阻塞与生命周期错位对账技术专家团队迅速介入,通过 Android Studio 的 Profiler 性能分析工具对冷启动日志进行了微秒级的追踪与校验对账。通过深挖代码逻辑,专家发现问题出在 API 的调用时机上。原有的开发人员为了图省事,直接将网络参数回传的 API 放在了应用首页 MainActivity 的 onResume() 生命周期内。由于冷启动时,App 不仅需要解析系统剪贴板,还需要向云端发送设备指纹特征进行网络鉴权,这部分异步网络请求通常需要耗时约 300 毫秒。但在很多中低端安卓机型上,UI 主线程的渲染速度极快,在异步回调结果还未返回之前,主线程里的新客判定逻辑就已经提前执行完毕。此时由于参数变量还没被异步线程赋值,业务层便直接上报了 Null,造成了典型的生命周期竞态条件错位。技术介入:重构 Application 初始化与异步回调监听针对这种异步并发导致的时序错乱,技术团队彻底抛弃了在业务 Activity 中直接调用原生 API 并同步等待的做法。团队对代码架构进行了重构,首先将 SDK 的基础初始化 API 迁移至全局的 Application.onCreate() 阶段,确保其在整个系统进程被拉起时处于最高优先级的执行序列。其次,在参数获取的核心业务点,引入了标准的异步接口回调设计(采用 Interface Callback 或者 Kotlin Coroutines 协程机制)。在业务层发起参数请求后,加入了一个非阻塞式的挂起等待逻辑,强行确保只有在底层网络 API 明确返回了 onSuccess(String channelCode) 之后,才放行下游的新客发奖和 UI 弹窗逻辑,彻底切断了时间差导致的空指针可能。产出结果:消除数据并发丢失,携参激活率提升 16.8%这套异步重构方案打包热更新发布后,并发条件下的参数丢失异常被彻底消灭。经过一周的数据大盘对账显示,首次安装新用户群体的“携参激活成功率”相对历史基准线大幅提升了约 16.8%。这不仅完美修复了新客奖励无法下发的 Bug,更真正补齐了原本漏水的跨端数据漏斗,使得整体渠道归因的颗粒度达到了业务可信的标准。高精度归因方案与跨端架构升级随着安卓系统的不断演进,单纯依赖自研调用原生 API 已经越来越难以应对复杂的移动端环境,技术架构的升级势在必行。自研 API 接口在碎片化安卓生态中的局限从 Android 12 开始,系统对剪贴板的越权读取增加了严格的隐私弹窗警告,使得传统的无痕剪贴板传参方案大受打击。与此同时,国内各大手机厂商(如华为、小米)也纷纷收紧了对底层硬件标识符(如 OAID、IMEI、MAC 地址)的获取权限。开发者如果依然依靠自己堆砌代码去调用这些千奇百怪、不断废弃的原生 API,不仅需要处理无穷无尽的 SecurityException 异常,其适配和维护的成本更是呈现出指数级的上升趋势。接入 Xinstall SDK 实现全链路参数穿透面向追求高效与稳定性的开发团队,将专业的事情交给专业的工具是更为明智的架构选择。直接接入类似 Xinstall 的成熟第三方 SDK 是解决跨端参数回传的更优解。它不仅在底层将数十个复杂的系统 API 与隐私适配逻辑封装为了极简的两三行调用代码,更在云端构建了基于海量设备特征的高并发指纹匹配引擎。移动端开发者无需再头疼各版本安卓的生命周期差异与时序回调问题,只需在统一的异步接口中专注于最终参数的业务逻辑处理,彻底免除了碎片化生态带来的适配痛苦。常见问题调用 Android 剪贴板 API 时遇到隐私弹窗警告怎么办?在 Android 12(API 级别 31)及以上的系统中,任何对剪贴板的读取行为都会触发系统级的 Toast 弹窗提示(例如“应用已从剪贴板粘贴”),这容易引起用户的隐私反感。为了提升用户体验,开发者应避免在 App 一启动就盲目读取。建议在代码中先调用 ClipboardManager.hasPrimaryClip() 判断是否有内容,并在可能的情况下优先使用安全的跨端归因 SDK 方案,利用设备指纹等无需侵入剪贴板的弱特征匹配技术来替代粗暴的剪贴板 API 调用。SDK 初始化 API 应该在冷启动的哪个生命周期调用?对于强依赖全局上下文且自身耗时极短的基础统计组件,应当放置在 Application.onCreate() 中进行最优先的初始化。但需要特别注意的是,如果初始化的 API 内部包含重度磁盘 I/O 读写或同步的网络请求,必须将其放入后台线程池(或使用懒加载机制)。如果直接阻塞主线程,不仅会严重拖慢应用的冷启动速度,在低端机型上甚至会引发系统级的 ANR(应用无响应)异常,导致 App 被强行 Kill 掉。为什么 Debug 环境下参数回传正常,打 Release 包后接口失效?绝大多数情况下,这是因为开启了代码混淆工具(ProGuard 或 R8)所致。在 Release 打包阶段,混淆器会将用于接收 JSON 回调参数的 Java Bean 类名或内部字段名缩写成无意义的字符。这直接导致底层的网络反序列化框架(如 Gson 或 FastJson)在进行字段映射时匹配失败,最终业务层拿到的参数全为 Null。解决办法是在项目的 proguard-rules.pro 文件中,针对相关 SDK 的路径和数据实体类,显式添加 -keep class 防混淆白名单指令。代码块 1:插入到正文中这句的正下方(空一行再贴):“在业务层发起参数请求后,加入了一个非阻塞式的挂起等待逻辑,强行确保只有在底层网络 API 明确返回了 onSuccess(String channelCode) 之后,才放行下游的新客发奖和 UI 弹窗逻辑,彻底切断了时间差导致的空指针可能。”kotlin// 示例:利用 Kotlin 协程与挂起函数重构异步网络参数回调// 避免 MainActivity 的 UI 线程阻塞,确保拿到归因参数后再执行下游逻辑import kotlinx.coroutines.*import kotlin.coroutines.resumeimport kotlin.coroutines.resumeWithException// 模拟的底层参数回传 SDK 异步 API 接口interface AppParamCallback {fun onSuccess(channelCode: String)fun onError(errorMsg: String)}object AttributionManager {// 将传统的 Callback 异步回调转换为协程的挂起函数 (Suspend Function)suspend fun fetchChannelParamAsync(): String = suspendCancellableCoroutine { continuation ->// 模拟调用第三方 SDK 的初始化与异步获取参数 APIMockThirdPartySDK.getInstallParams(object : AppParamCallback {override fun onSuccess(channelCode: String) {// 网络回调成功,恢复协程并返回渠道参数if (continuation.isActive) {continuation.resume(channelCode)}} override fun onError(errorMsg: String) { // 回调失败,抛出异常交由业务层捕获 if (continuation.isActive) { continuation.resumeWithException(RuntimeException(errorMsg)) } } })}}// 在业务层 Activity 中安全地调用class MainActivity : AppCompatActivity() {override fun onCreate(savedInstanceState: Bundle?) {super.onCreate(savedInstanceState)setContentView(R.layout.activity_main) // 启动主线程协程,UI 不会卡顿 lifecycleScope.launch { try { // 挂起等待异步网络 API 返回结果 val channel = AttributionManager.fetchChannelParamAsync() // 确保 100% 拿到参数后,再执行新客发奖或弹窗 UI processNewUserReward(channel) } catch (e: Exception) { Log.e("API_ERROR", "获取来源参数失败,执行兜底逻辑", e) } }}private fun processNewUserReward(channel: String) { // 业务逻辑:根据 channel 发放对应的渠道专属奖励}}
697
App付费转化率怎么提升?当留存率优化已经触顶,付费转化率成为制约 LTV(用户终身价值)的最后瓶颈。2% 的付费率已经是很多产品的极限,ARPU(平均用户收入)徘徊在几毛钱。系统性提升付费转化率的核心是“付费漏斗诊断 + 价格锚点测试 + 用户分层变现”的闭环打法。通过识别高流失付费节点、优化价格呈现与会员权益设计,可以将付费率从 2% 拉升至 5% 以上。本文将基于变现漏斗模型,深度剖析付费转化在 LTV 体系中的战略地位,拆解三大核心优化方法,并结合某音乐 App 的实战案例,展示如何将付费转化率系统性提升 47.2%。付费转化在LTV体系中的战略价值付费转化率位于用户增长漏斗的“收入”环节,是决定 App 是否能实现盈利的试金石。为什么付费转化比留存更重要留存率拉长了用户生命周期,但付费转化率直接决定了收入的天花板。付费用户的 LTV 是免费用户的 10-50 倍。以音乐 App 为例,免费用户月 ARPU 0.2 元,SVIP 用户高达 15 元。即使 D1 留存率达到 50%,如果付费率只有 1%,整体 ARPU 依然只有 0.15 元/人。反之,D1 留存 30% 但付费率 5%,ARPU 就能达到 0.75 元/人,LTV 反而更高。付费漏斗的分层结构与行业标杆付费转化不是单一节点,而是完整的四级漏斗:行业付费漏斗标杆对比表漏斗节点社交类音乐类游戏类工具类展示页浏览100%100%100%100%价格页进入25%18%35%12%支付页提交12%8%22%5%成功成交6%3%12%1.5%音乐类标杆付费率 3%,游戏类 12%,工具类仅有 1.5%。如果你的产品付费率低于行业中位数 50%,说明变现路径存在系统性问题。付费率低下的“四大症结”复盘数百款付费产品后,发现 85% 的付费问题源于以下根源:价值不清晰:用户不知道付费后能获得什么独享权益;价格敏感:定价过高或缺乏价格锚点对比;支付繁琐:多步确认、支付方式少;时机不对:在用户尚未感知价值时强推付费。付费漏斗诊断:找出转化杀手提升付费的前提是精准诊断漏斗中的流失节点。各层级漏斗流失率分析通过全埋点监控,建立起从“商品展示页 → 价格权益页 → 支付确认页 → 成交成功页”的四级漏斗。某工具 App 发现其最大杀手节点是“价格页”,流失率高达 78%。原因是价格页只罗列了功能列表,却没有与免费版的直观对比,用户无法感知付费的“增量价值”。价格敏感度热图通过价格 A/B 测试,绘制用户对不同价格区间的敏感度热图。以月费为例:9.9 元:放弃率 65%;19.9 元:放弃率 82%;29.9 元:放弃率 91%。热图显示 9.9 元是价格“甜点区”,但结合权益价值,实际的最佳锚点往往是“对比价 39.9 元,现价仅 19.9 元”。用户分层付费画像付费行为高度分层。高留存用户(D7>20%)付费率是低留存用户的 8 倍。付费用户的典型画像是:高频次使用核心功能、停留时长长、对个性化推荐敏感。通过画像对比,可以针对性设计分层权益。价格锚点与A/B测试实战价格是付费转化的核心杠杆,必须通过科学测试寻找最优解。价格呈现优化三大价格套路实战对比套路类型示例付费率提升适用场景对比价原价¥39.9 现价仅¥19.9+42%首次付费限时价限时 3 天 8 折,仅剩 2 天!+31%促销活动捆绑包月付¥19.9 赠 30 天试用+56%会员续费对比价能有效降低心理预期,限时价制造紧迫感,捆绑包提升感知价值。A/B测试框架标准价格测试流程假设验证:付费率低 = 价格过高?样本设计:每组至少 5000 人,随机分流;测试周期:7 天,确保覆盖完整用户周期;核心指标:付费率、ARPU、LTV、续费预估;统计显著性:P 值 < 0.05,置信区间重叠度 < 20%。某游戏 App 测试“¥6.99 vs ¥9.99 的首次礼包”,结果 ¥6.99 组付费率提升 23%,但 ARPU 仅降 8%,ROI 最优。动态定价策略根据用户标签实时调整优惠:高 LTV 用户:推送专属权益会员;价格敏感用户:小额入门包;新用户:超低门槛试用。用户分层变现:会员体系设计付费不是“一锤子买卖”,可持续变现依赖会员体系。SVIP/会员/免费的权益分层权益金字塔设计原则SVIP (Top 5%) │ 专属客服 + 优先体验新功能───────────────────────┼──────────────────────高级会员 (Top 20%) │ 无广告 + 专属内容库───────────────────────┼──────────────────────基础会员 (Top 50%) │ 核心功能解锁───────────────────────┼──────────────────────免费用户 │ 功能受限 + 水印text每个层级都有独享权益,避免用户觉得“多花钱没区别”。续费率优化的时点干预续费前 7 天是关键窗口:D-7:发送“续费专属福利”短信;D-3:App 内弹窗“仅剩 3 天会员权益”;D-1:推送“最后机会,双倍积分返现”。续费率每提升 10%,LTV 增长 25%。专家诊断案例:某音乐App付费率翻番某独立音乐 App 付费率长期徘徊在 1.2%,月 ARPU 仅 0.8 元,难以支撑内容采购成本。漏斗诊断:VIP权益页流失78%埋点数据显示,用户路径为“首页 → VIP 权益页(流失 78%)→ 无”。权益页问题在于只罗列了“无广告、高音质”等功能,却没有与免费版的直观对比,用户感知不到付费的“增量价值”。重构方案:权益对比 + 价格锚点重做 VIP 权益页:左右对开布局,免费版灰色禁用 vs VIP 版金色高亮;价格锚点测试:¥9.9/月 vs ¥19.9/季 vs ¥99/年,三种 SKU 并列;首次付费门槛:新用户专享 3 天 ¥0.01 试用。接入 Xinstall 付费路径分析,实时监控各版本转化曲线。成果:付费率提升47.2%测试结果显示,¥9.9 月付 + 权益对比的组合最佳。优化上线 30 天后:付费转化率从 1.2% 跃升至 1.8%,提升 47.2%;月 ARPU 从 0.8 元升至 1.4 元;续费率提升 28%,LTV 实现倍增。常见问题(FAQ)首次付费提升但续费率下降怎么办?这是典型的“入门门槛过低”问题。检查会员权益是否匹配长期价值:无广告和高音质适合入门,但独家版权、离线缓存、专属推荐等深度权益才能锁住续费。立即调整续费前福利,强化会员身份认同感。价格测试样本量多少才靠谱?每组至少 5000 人以上,测试周期不少于 7 天(覆盖完整用户周期)。核心是统计显著性:P 值 < 0.05,且置信区间的重叠度低于 20%。样本量不足会导致“伪阳性”,错误认为优化有效。如何避免价格测试干扰正常业务?采用灰度发布,先在 10% 用户中测试,对照组与实验组严格随机分流。同时设置“安全阀”:如果实验组付费率连续 3 天低于对照组 20%,立即回滚。测试期间暂停其他促销活动,避免变量干扰。结语说明付费转化率的提升没有灵丹妙药,只有科学诊断与持续迭代。从漏斗诊断到价格测试,再到分层变现,每一步都需要数据支撑。每提升 1% 的付费率,都是对 LTV 的指数级放大。建立起付费路径的全链路监控与 A/B 测试闭环,才能让变现能力成为 App 的护城河。
1717
App短信营销怎么统计效果?在外部买量成本居高不下的今天,短信召回依然是撬动存量用户的黄金杠杆。然而,很多运营团队只盯着送达率和点击率算账,忽略了这些流量是否真正转化为付费充值。精准统计短信营销效果,必须从浅层的送达指标,深入到全链路的 ROI(投资回报率)。通过短链参数追踪与 RFM 用户分群技术,可以精准衡量短信从送达、点击到激活、注册、付费的完整转化价值。本文将拆解短信渠道的三大统计误区,剖析短链追踪与用户分群的核心机制,并结合物理对账逻辑与某电商平台的实战案例,展示如何利用 Xinstall 等工具动态优化文案频次,将短信综合 ROI 跃升 36.7%。短信营销的“三大统计误区”短信作为直接触达用户的渠道,具有极高的打开率和即时性。但如果只看表面的数据指标,运营很容易被虚假繁荣所迷惑。只看送达率与点击率,忽略深层转化短信运营商的后台报表通常只提供“送达率”和“点击率”两个浅层指标。送达率 95% 听起来很美,点击率 12% 也相当亮眼。但这些指标具有极大的欺骗性。高点击率可能只是标题党文案(如“您的账户异常,请立即登录查看”)的功劳。如果后续 App 内没有相应的优惠券、任务奖励或活动承接机制,这些点击流量最终的付费转化率可能接近于零。运营团队沉醉于前端的华丽数据,却无法评估短信营销对公司真实收入的贡献。缺乏精准分群,频次失控导致用户疲劳最致命的误区是“一视同仁”的全量群发策略。运营往往将所有用户塞进同一个短信池,不管是日活用户、沉睡用户还是流失用户,都推送相同的优惠信息。这种粗放做法不仅会触怒高价值用户(VIP 用户每天收到相同的内容会立刻退订),还会增加运营商投诉成本。如果不能基于 RFM(最近消费、消费频率、消费金额)模型进行科学的用户分群,短信营销就会迅速从“黄金渠道”沦为“骚扰渠道”。短链劫持与异常点击无法识别短信短链是追踪流量的关键载体,但也最容易成为黑产攻击的目标。部分渠道或内部员工为了刷取点击提成,会利用脚本或群控设备疯狂点击短链骗取费用。同时,短信短链还容易被运营商或手机安全卫士劫持,导致真实用户根本无法访问。如果运营无法区分真实用户点击与脚本刷量,就等于按虚假数据向渠道方结算 CPA 费用,营销预算被无形中掏空。短链追踪技术:短信渠道的全链路归因要实现短信的全链路追踪,必须将短链从简单的“下载链接”升级为智能的数据探针。动态短链生成与参数嵌入短信营销的第一步,是为不同活动、不同用户分群、不同文案版本生成专属的短链参数。通过后台管理系统,运营可以一键批量生成数百万条个性化短链。短链底层会嵌入多层追踪信息,包括渠道标识(如 channel=jd)、用户 ID(uid=12345)、文案版本号(version=A)、活动标签(activity=double11)等关键参数。这些参数确保了后续点击行为的完全可追溯性,即使在复杂跳转链路中也不会丢失。端云指纹匹配:跨越商店黑盒用户收到短信并点击短链时,系统会调起一个极度轻量的智能落地页。该页面在云端瞬间抓取当前设备的非敏感环境指纹,并将指纹与短链参数死死绑定,安全暂存。用户随后被引导至苹果 App Store 或安卓应用商店完成漫长的下载流程。当用户终于安装完成并首次打开 App 时,预埋的统计 SDK 会再次采集当前设备指纹,向云端发起高精度比对请求。一旦匹配成功,云端服务器便会将短信短链中携带的所有参数完美下发给 App。至此,跨越应用商店黑盒的精准归因宣告完成,用户在 App 内产生的任何后续行为都能被准确追溯回最初的那条短信。深度链接场景还原:提升激活后留存短链追踪不仅是为了统计数据,更是为了优化用户体验。短信推送“新人专享 50 元无门槛红包”,激活后 App 不应让用户在首页茫然四顾,而是通过深度链接技术直接将其路由至红包领取页面。这种消除认知负担的场景直达,能将短信激活后的次日留存率提升 30% 以上。RFM分群与防疲劳机制:精准召回策略有了全链路的数据追踪,运营的核心工作就从“群发”转向了“精准投放”。RFM模型的用户价值分层RFM 用户分群模型是短信营销的科学基石。它根据三个维度对用户进行价值分层:R(Recency):最近一次消费时间,越近越活跃;F(Frequency):消费频率,越频繁越忠诚;M(Monetary):消费金额,越高越高端。通过 RFM 评分,可以将用户分为 VIP(高R高F高M)、潜力用户(中R高F低M)、流失边缘(低R中F高M)等 8 大分群。VIP 用户推送专属尊享权益,流失用户推送破冰大额优惠券,沉默用户推送唤醒任务。这样精准的匹配,能将短信点击率提升 2-3 倍。动态频次控制与疲劳度监控精准分群后,还必须解决“发太多”的问题。系统会为每个用户建立个人“短信疲劳度模型”,核心指标包括:单用户连续接收频次;点击率衰减曲线;退订投诉率。当监测到某分群的点击率连续 3 天跌破 1% 时,系统自动触发降频策略,将该分群的下一次推送从 3 天冷却延长至 15 天。同时,结合机器学习模型预测最佳推送时机,避免用户养成“看到短信就删”的习惯。A/B测试与文案智能调优在同一 RFM 分群内,系统支持同时测试多套文案组合(标题、优惠力度、按钮文案)。通过实时监控各版本的点击到付费的全链路转化率,自动将预算倾斜向效果最佳的组合。这种闭环的智能调优机制,能持续迭代出短信营销的“爆款公式”。物理对账:短信ROI的精细化核算数据追踪与分群策略落地后,最终的成败取决于能否建立起科学的 ROI 对账体系。全漏斗ROI计算公式与对账短信渠道的 ROI 核算公式为:ROI =(短信驱动的付费收入 - 短信渠道成本)/ 短信渠道成本关键在于“短信驱动的付费收入”的精确拆分。运营必须按天甚至按小时,将短链追踪到的激活量与 App 后台的付费流水进行精确对账。只有那些参数中明确携带短信来源标识的用户产生的收入,才能计入短信渠道的业绩。这样可以避免将其他渠道(如抖音买量)的付费收入错误分摊到短信头上。异常流量识别与拦截短信短链是黑产攻击的热门目标。常见的异常信号包括:CTIT 异常:点击短链后 1 秒内激活;IP 高度聚集:大量激活来自同一机房网段;设备指纹重复:同一硬件反复重置 ID 激活。一旦触发任一阈值,风控引擎自动隔离该批次数据,暂停对账结算。专家诊断案例:某电商平台的短信召回战役为了直观展示短信全链路追踪的价值,我们复盘某头部电商平台是如何利用短链 + RFM 技术重振短信渠道的。高送达低转化的困局该电商平台每月向数千万用户推送优惠券与召回短信,运营商后台显示送达率高达 95%,平均点击率 12%,数据看似极美。然而,付费转化率长期徘徊在可怜的 0.8%,综合 ROI 勉强为 1.2,远低于抖音买量的 1.8。运营团队百思不得其解:为什么短信的到达成本如此之低,却转化如此乏力?技术重构与分群优化增长团队接入短链追踪后,发现了三大症结:全量群发导致 VIP 用户疲劳退订;缺乏场景承接,用户点击后找不到优惠券;异常流量占比高达 25%。他们重构了整个体系:引入 RFM 模型将用户分为 8 大分群,高价值用户推送专属定制券,流失用户推送破冰大额优惠券;短链落地页实现深度链接场景直达;风控引擎拦截了大量机刷异常流量。成果:ROI跃升 36.7%优化上线 30 天后,奇迹发生了。短信综合 ROI 从 1.2 跃升至 1.6,增幅 36.7%。其中,高价值分群的付费转化率提升了 2.5 倍,流失召回效果提升了 4 倍。平台不仅挽回了数百万的无效预算,还通过科学的频次控制,大幅降低了退订投诉率,短信渠道重获新生。常见问题运营商拦截短信短链怎么办?短链被运营商拦截是行业常态。应对策略包括轮换多套短域名备用、使用内容合规化文案、以及配置智能重定向。当主短链失效时,系统自动切换备用域名,确保流量不断。用户退订后如何重新召回?退订用户需设置至少 30 天冷却期。在此期间暂停所有推送。冷却期结束后,结合最新的 RFM 评分重新评估其价值。如果用户重新表现出高消费潜力,可尝试发送“破冰大额券”进行温和唤醒,但仍需严格监控其后续反馈。短信疲劳怎么判断和控制?核心指标是单用户点击率连续衰减。正常情况下,同一分群点击率不应连续 3 天跌破 1%。系统通过机器学习模型监控每个用户的个人疲劳曲线,一旦触发阈值,自动将其从高频池降级至低频池,甚至暂停推送。结语说明在精细化运营时代,短信营销已不再是简单的“群发优惠券”。通过短链的全链路追踪、RFM 的精准分群以及 ROI 的科学对账,运营团队才能将这一黄金渠道的价值彻底挖掘出来。只有建立起数据驱动的闭环优化体系,短信召回才能从“成本中心”转变为“利润引擎”,为 App 的存量增长注入源源不断的活力。
721
XChat即将在4月17日正式登陆App Store,这款由X平台推出的独立通讯应用,被视为马斯克“西方微信”战略的关键一步。它主打端对端加密、无广告、无追踪,同时深度集成Grok AI,试图把聊天、内容和智能助理合并到同一个入口里。这件事看起来像一款新的聊天应用上线,实际上更像一次超级App入口实验。对于App开发者、产品经理和增长团队来说,XChat不是单纯的竞品新闻,而是一个关于“用户入口会不会重新洗牌”的信号。新闻与环境拆解从推特私信到独立AppXChat并不是临时起意的产品。按照公开信息,马斯克对“微信模式”的执念至少可以追溯到2022年收购推特之后,他一直希望把社交、支付、通讯和生活服务装进一个闭环里。XChat的出现,意味着原本分散在X平台内部的聊天能力,开始被抽离出来,变成一款面向iPhone和iPad用户的独立应用。它的发布时间也很有节奏感。2026年3月3日,XChat iOS Beta 公测开放,1000个名额两小时内就被抢光,之后扩容到5000人;4月11日,App Store预购页上线;4月17日,正式下载。对一个通讯工具来说,这种预热方式本身就说明,它不是补丁式升级,而是一次战略性独立。功能配置接近主流竞品从功能清单看,XChat几乎把主流通讯产品能讲的点都讲了一遍:端对端加密、音视频通话、阅后即焚、截图拦截、文件共享、群聊、消息双向撤回,以及 Grok AI 的深度集成。它还采用 Rust 开发,安装包大小约 175.8MB,要求 iOS 16 以上系统,且无需绑定手机号即可注册。真正值得注意的,不只是功能多,而是它试图把“聊天框”变成一个任务入口。用户不是只来发消息,而是可以在对话界面里直接调用 Grok 做事,这让通讯场景和 AI 助理场景开始重叠。隐私叙事与信任争议并存XChat把自己定义成一个“私密、专注”的通讯空间,但争议也几乎同步出现。外界质疑点集中在三个地方:它所谓的“比特币式加密”是否准确、App Store 隐私标签里列出的数据收集项是否足够透明,以及它有没有经过独立安全审计。更关键的是,在没有公开审计报告之前,用户只能接受平台自己的解释。这意味着,XChat讲的是“安全通讯”,市场讨论的却是“信任从哪里来”。这类产品的命门不是功能列表,而是验证机制。从新闻到用户路径的归因问题XChat上线后,普通用户看到的是一个更酷、更安全、还能接 AI 的聊天工具;但对 App 开发者来说,它带来的第一个问题是入口变化。过去,用户路径更多发生在搜索、下载、注册和日常使用这些固定环节里;而当超级通讯应用成为新入口时,流量可能先进入聊天,再通过聊天跳转到内容、工具、支付或者第三方服务。这会让传统归因逻辑变得很难用。用户可能不是从广告点进来,而是从一条群消息、一个文件分享、一次 Grok 任务调用,或者一段来自 X 平台的内容拖拽进入新场景。页面流量还在,但任务流量已经开始替代它。对增长团队来说,真正要追的是“谁把任务发起了、任务经过了哪些平台、最后在哪一步转化”。工程实践:重构安装归因与全链路归因用 ChannelCode 管住入口问题很简单:当流量来自 XChat、X 平台、Grok 调用或外部分享时,怎么知道用户到底从哪个入口进来的。做法是给每个入口配置统一的 ChannelCode,把不同来源的链接、按钮、群发和任务跳转收束到同一套标识体系里。这样一来,开发团队在做活动页、落地页和下载页时,就不再依赖模糊的来源文本,而是可以直接用结构化渠道码管理流量。好处也很直接:渠道看板能区分“聊天内跳转”“内容内跳转”“任务驱动跳转”,增长团队可以更准确地判断哪类入口带来了更高质量的安装和激活。用智能传参保留上下文问题在于,通讯场景里的跳转往往不是普通点击,而是带着上下文的动作。用户可能先在 XChat 里看到一段推文,再跳到某个 App 去完成操作;也可能通过 Grok 生成任务,再把结果发送到第三方工具。做法是用智能传参安装把场景、任务意图、来源角色等参数随链接一起带入安装流程,让用户首启 App 时还能还原“为什么会来”。好处是,App 不会在下载完成后丢失上下文。对于需要承接邀请、任务或内容分享的产品来说,这一步直接决定首启是否能命中用户预期。Xinstall 的智能传参安装和场景还原能力,正适合解决这种跨端断层问题。把任务流量纳入事件图问题不是只有下载和打开,还包括“任务在什么地方发起、在哪个环节失败、最后是否真的转化”。做法是在数据层建立任务事件图,把 agent_id、workflow_id、channelCode、scene、risk_level 这些字段串起来,区分用户直接行为和任务驱动行为。这样,后端可以看见每一次任务流量的完整路径,而不是只看最终安装数。好处是,通讯应用、AI 助手和第三方服务之间的协同不再是黑盒。对于 XChat 这种把聊天和 AI 绑在一起的产品,这种可观测性会越来越重要。这件事和开发 / 增长团队的关系面向开发团队开发侧要预留清晰的入口参数和跳转路由,不要把所有流量都默认导进首页。对于 XChat 这类超级通讯应用,用户可能从聊天、文件、视频、AI 任务等多个入口进来,冷启动必须支持按场景分流。还要补上埋点字段设计,至少区分 channelCode、scene、workflow_id 这类关键维度。面向增长团队增长侧要重新理解“入口”这件事。XChat这种产品会让分享行为、任务调用和内容转发变成新的分发方式,投放策略不能再只看点击和安装。更值得关注的是,哪种场景最能触发二次传播,哪种任务最容易把老用户带回到产品内。面向数据团队数据团队需要把“普通用户流量”和“任务流量”分开看。前者关注页面访问和注册,后者关注任务发起、执行和回传。两类流量混在一起,报表会很好看,但业务判断会失真。常见问题(FAQ)XChat为什么被称为“西方微信”?因为它不只做聊天,还试图把社交、支付、内容和 AI 助理放进同一套产品体系里。这和微信的产品思路很接近,都是围绕一个高频入口扩展生态能力。XChat的“端对端加密”意味着什么?理论上,它希望让消息只在通信双方可见,平台和第三方无法直接读取内容。不过外界对它的实际实现方式仍有争议,尤其是是否经过独立审计,以及数据收集范围是否与安全叙事一致。为什么XChat会影响App分发和增长?因为它可能变成新的内容入口和任务入口。用户如果先在聊天里看到内容、任务或链接,再去下载别的App,传统的来源识别和路径归因就会变得更复杂。Grok AI集成会改变什么?它会把聊天框从“发消息的地方”变成“完成任务的地方”。这意味着更多流量不是来自页面点击,而是来自对话中的任务触发。行业动态观察XChat代表的是一种典型趋势:通讯工具正在从单纯的消息通道,变成内容、任务和AI能力的入口。对行业来说,这种变化会重塑用户的停留方式,也会重塑App的获客方式。当入口越来越多,单纯依赖页面级埋点已经不够用了。开发和增长团队更需要的是一套能跨终端、跨场景、跨任务识别流量真身的体系,否则很多真实转化会在黑盒里丢失。现在正是重构数据和归因体系的窗口期。谁能先看清入口变化,谁就更容易在新的分发生态里拿到确定性增长。
1304
千问于4月14日上线“表格Agent”,用户通过自然语言即可生成、编辑Excel文件。这标志着办公AI从提供文本答案向直接交付可用结果转型,无需手动复制粘贴,通常1-2分钟内输出专业表格,支持公式、条件格式和复杂排版。对App开发者而言,这类Agent工具的增长飞轮已然启动:生成即分享。但从H5分享到App激活的链路,存在明显断层,需要底层优化。新闻与环境拆解功能全景:从对话到文件交付千问表格Agent支持多场景输入:自然语言需求、上传图片/PDF/Word/PPT、多轮对话提炼。示例包括“整理增值税优惠政策为Excel清单”或“将英语语法做成可打印表格”。系统自动检索数据,在沙箱中coding生成真实Excel,包含公式和格式。与其他AI不同,它不依赖模板或仅输出文本,而是完整链路:任务规划(查资料/写代码)、执行、输出下载链接。用户可进一步用语言修改,如“根据销售额排名销售人员”。技术拆解:Agent执行链路核心是Agent链路拆解:输入解析、任务规划(需代码/检索)、沙箱执行、输出Excel。信息不足时自动在线补充,支持多模态如手绘课表转表。对于现有Excel/CSV,可自然语言分析编辑,如“计算接访人数”或“第三列居中”。产品负责人强调,从“答案”到“结果”交付。这是国内首个全场景表格Agent,突破文本交互边界。市场背景:办公AI的痛点与机遇表格处理一直是AI弱项:一类需上传模板,另一类仅文本输出。千问解决易用性瓶颈,适用于旅行规划、项目讨论、学习复盘。开放所有用户免费使用,预示办公工具向Agent化加速。类似工具正涌现,企业级需求(如PPAP审核)将推动标准化。从新闻到用户路径的归因问题用户小李用表格Agent生成“Q1销售预测”Excel,分享到企业微信:“这个超准,一键试试!”小王点击链接,被震撼,跳转下载App。问题来了:应用商店“黑盒”切断参数,小王安装后面对默认首页,不知从何复现“销售预测”。手动填邀请码繁琐,场景丢失,裂变中断。传统埋点难追踪Agent发起的任务来源、上下文和多端路径。工程实践:重构安装归因与全链路归因ChannelCode:统一入口标识用ChannelCode为企业微信、钉钉等标注来源。分享链接嵌入code,小王下载后SDK解析,归入“企业微信-表格Agent”渠道。支持多Agent场景,区分发起平台。智能传参安装:场景与关系还原H5点击下载时,云端悬挂邀请ID、模板哈希(销售预测)。小王首启,SDK抓取,实现免填绑定和直达生成页。参数<1KB,支持沙箱隔离。任务事件图:Agent流量观测构建跨端事件:agent_id(表格Agent)、workflow_id(执行链)、risk_level。沙箱日志结构化,汇聚到数据仓,形成任务图。注:本文探讨的Agent任务多端还原属于对未来分发趋势的前瞻性技术延展,目前高度定制化链路尚未标准实现,欢迎联系Xinstall探讨。这件事和开发 / 增长团队的关系面向开发团队预留参数接口,支持沙箱传参。设计多模态还原:哈希拉文件。统一事件模型,含agent_platform、scene。面向增长团队激励模板分享:绑定发积分。A/B测试传参效果。监控B端渠道:企业微信转化率。常见问题(FAQ)千问表格Agent支持哪些输入类型?支持自然语言、图片、手绘、PDF/Word/PPT、多轮对话。系统自动识别印刷/手写,保留语义。与竞品表格AI有何区别?竞品多依赖模板或仅文本输出,千问全链路生成真实Excel,支持沙箱coding和在线检索,无需手动调整。生成Excel如何确保公式准确?沙箱执行真实Office引擎,公式经规划验证。修改时自然语言解析,避免语法错误。多轮对话转表上下文怎么保持?Agent记忆多轮历史,提炼关键字段如日期/预算。支持迭代编辑。行业动态观察千问表格Agent是办公AI交付化的缩影,从文本到文件,任务流量取代页面浏览。企业文档场景(如PPAP)将标准化Agent调用,但分享链路需优化:多端参数还原、全渠道观测成基础设施。现在是重构归因体系窗口:Agent发起占比升,传统渠道码失效。开发者抓准,将从工具变基础设施。
496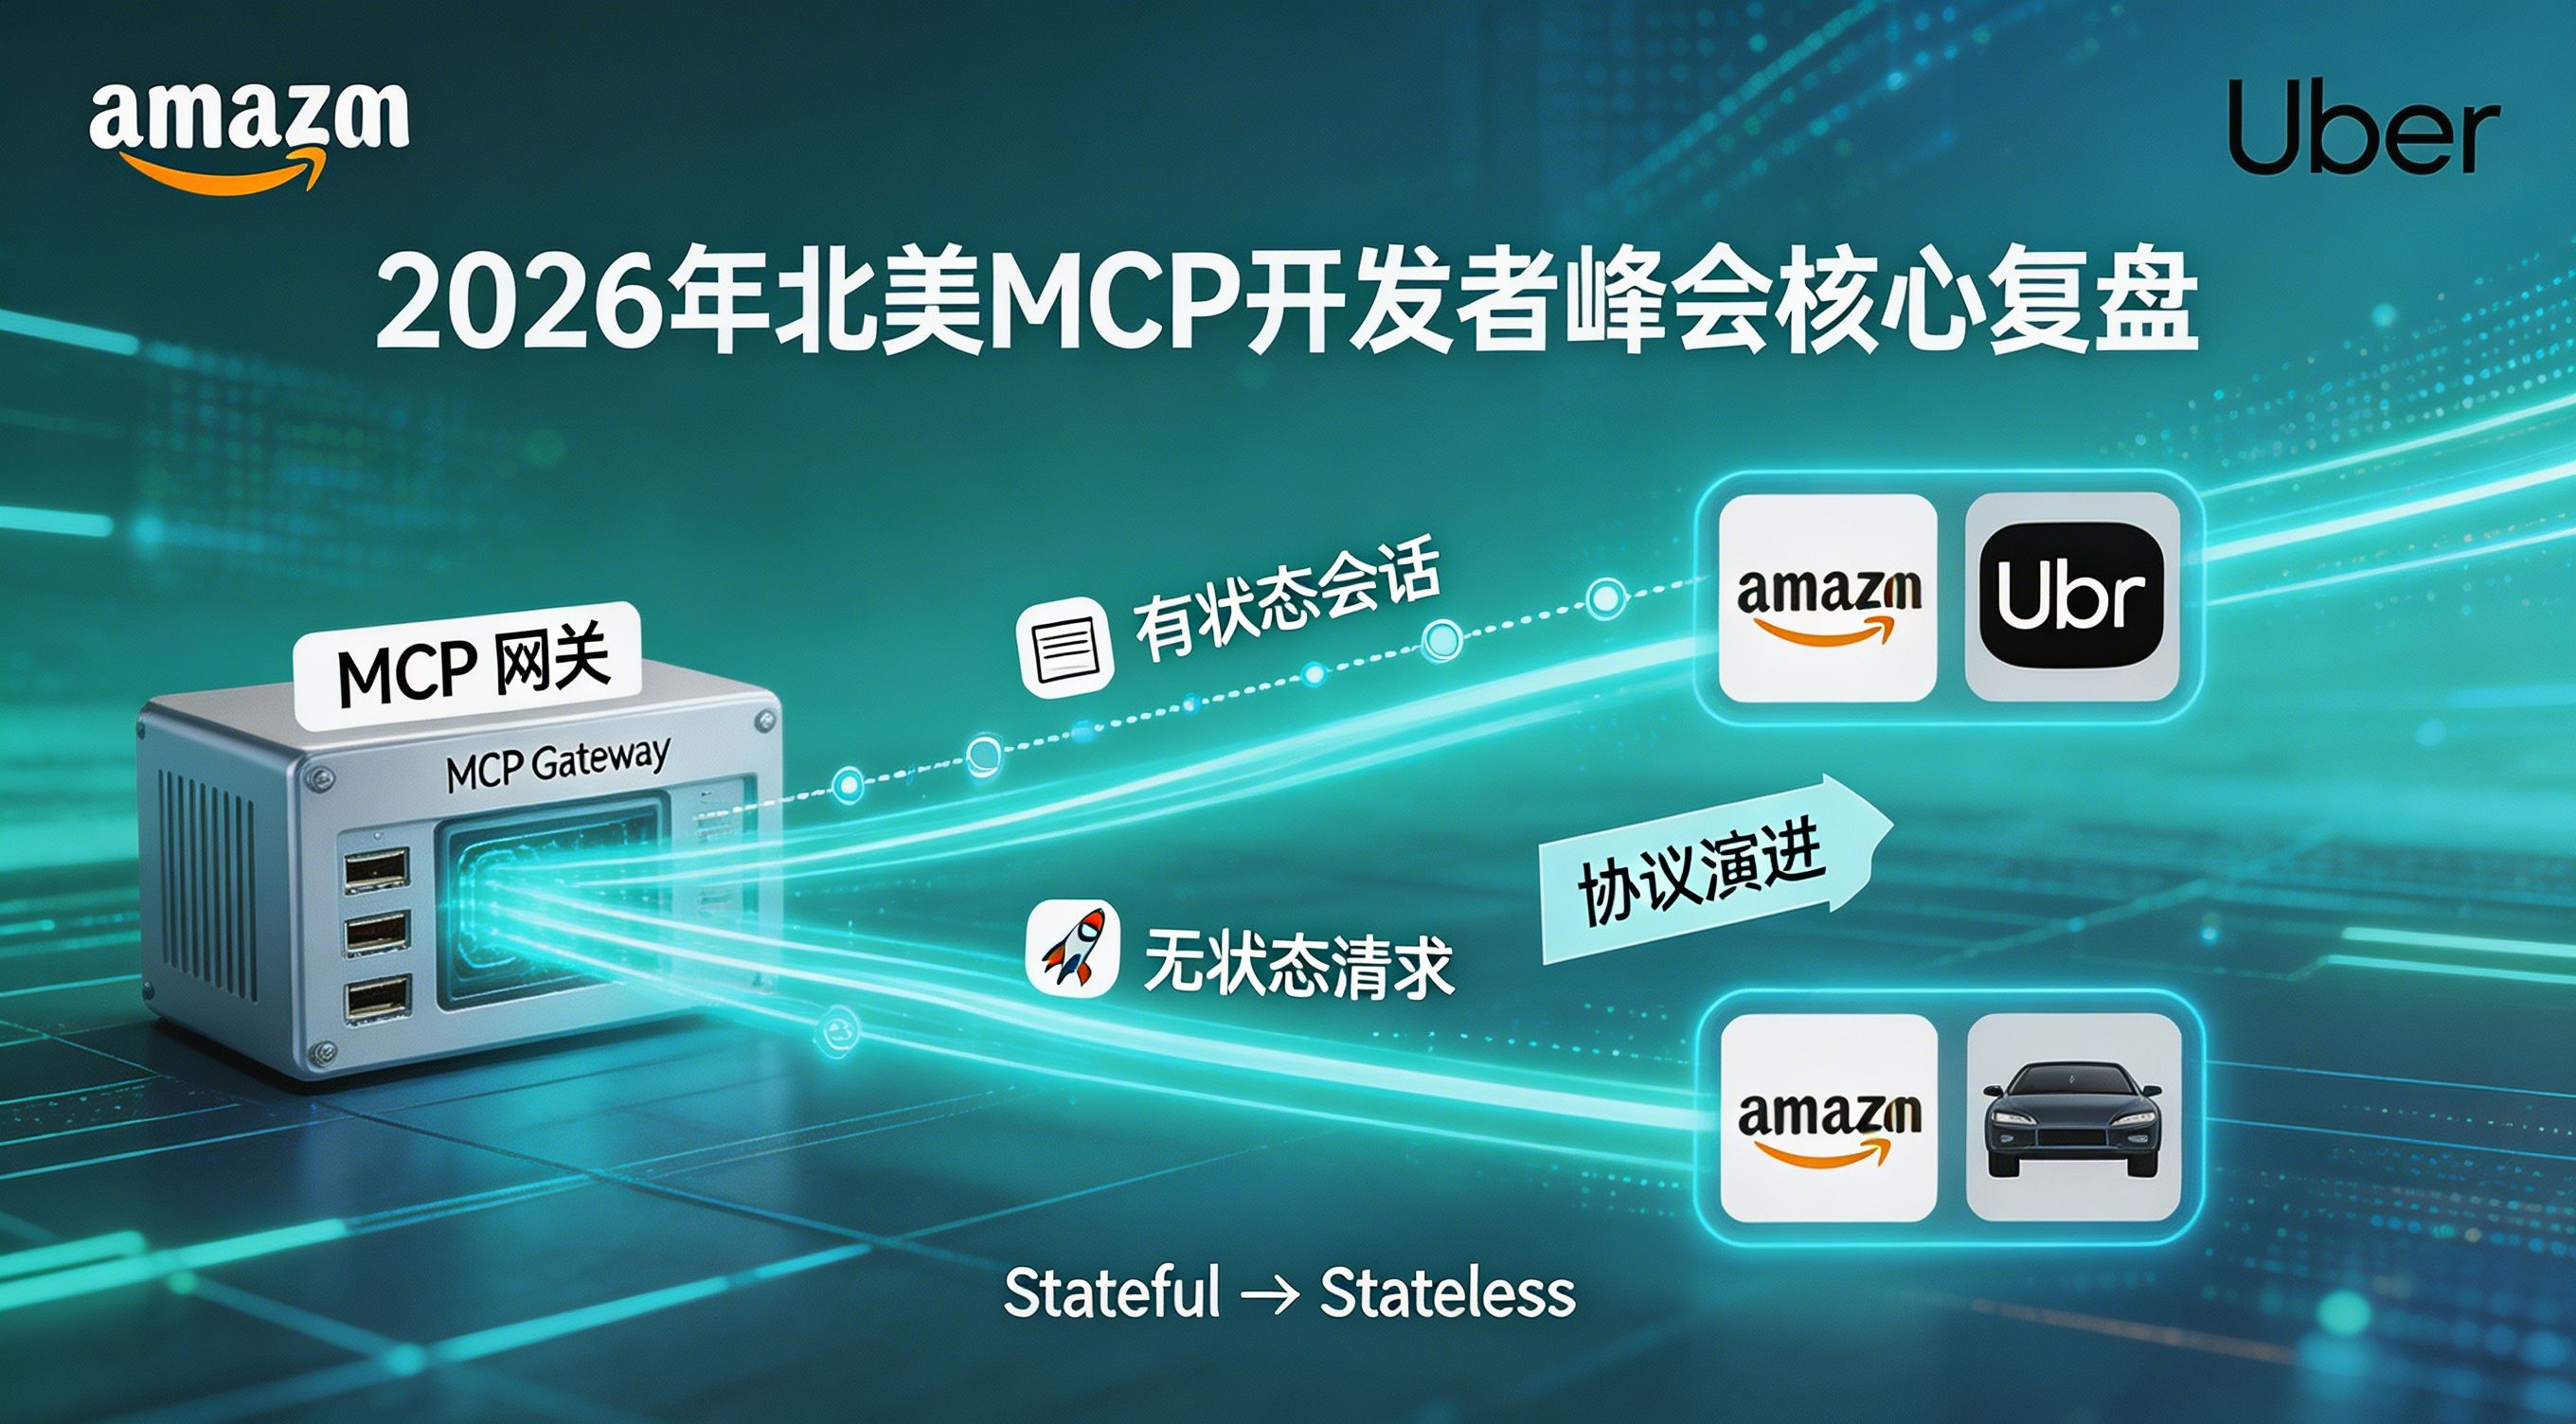
2026年北美MCP开发者峰会于4月2日至3日在纽约万豪侯爵酒店举行,吸引约1200名参会者,已成为Model Context Protocol生态系统的旗舰活动。Anthropic技术团队成员David Soria Parra的主题演讲《MCP:集成协议》回顾了协议从本地stdio服务器到支持远程、授权、tasks原语的演进,主线是SEP-1442传输机制,推动从有状态会话转向无状态请求。亚马逊首席软件工程师James Hood分享了MCP作为内部代理连接核心模块的实践,Uber代理平台团队介绍了MCP Gateway与Registry的使用,每周数万代理执行通过GenAI Gateway脱敏后流转。峰会共识:网关+注册表作为控制平面,是规模化MCP的关键。新闻与环境拆解MCP协议演进与峰会背景MCP联合创造者David Soria Parra强调,协议已覆盖远程服务器、引导、结构化输出及实验性tasks原语,用于长时间运行代理通信。峰会由Linux基金会下的Agentic AI Foundation组织,标志MCP从实验起源走向企业基础设施。亚马逊与Uber的企业实践亚马逊构建内部MCP发现基础设施,将工具、代理技能、SOP打包为可共享配置,开源agent-sop项目。Uber的MCP Gateway暴露数千Thrift/Protobuf/HTTP端点,所有流量经Go-based GenAI Gateway执行PII脱敏与标识清理。网关共识与架构模式多家企业如AWS、Uber、Docker、Kong、Solo.io一致认为,集中式网关配合注册表是必需。Arcade.dev CEO Alex Salazar划分推理层与行动层,网关承载治理、授权、变更控制。上下文膨胀与MCP Apps进展Claude Code用渐进式工具发现解决上下文膨胀,token使用降85%。MCP Apps规范允许服务器提供交互UI,在iframe中渲染HTML/JS/CSS,通过postMessage双向交互,已被Claude、ChatGPT、VS Code等采用。基金会里程碑与未来趋势Agentic AI Foundation吸纳超百成员,支持MCP、Block的goose、OpenAI的AGENTS.md。tasks原语(SEP-1686)支持后台执行,Triggers工作组推动webhook,x402基金会启动。从新闻到用户路径的归因问题峰会描绘的MCP企业图景很美:网关统一入口,无状态请求弹性扩展,gRPC高效通信,AAIF信号实时观测。但对App开发者来说,从Agent任务发起到终端激活的用户路径,存在严重断层。典型场景:企业Agent生成任务链接(如代码执行、数据查询),分享到Slack/微信群。用户点击,意图是下载App执行任务。但应用商店黑盒切断参数:任务ID、Agent来源、权限上下文丢失。新用户冷启动后,无法自动绑定任务,老用户无法获完成奖励。结果:流量虚化,归因失效,增长漏斗崩塌。传统埋点抓不到跨Agent、多云、网关跳跃的路径信号。无状态请求加剧了参数漂移,任务流量从“云端可见”变成“终端失踪”。工程实践:重构安装归因与全链路归因ChannelCode:多Agent统一入口标识峰会网关强调统一暴露,ChannelCode提供标准化标识:agent_platform(如Claude/Uber)、workflow_id、scene(如code_exec)。分享链接嵌入ChannelCode,云端持久化。新安装后,SDK解析还原,确保任务从MCP网关到App的无缝溯源。智能传参安装:无状态参数云端还原对应无状态请求,智能传参在H5点击瞬间悬挂任务参数(gRPC metadata、权限token)。下载后首启,SDK毫秒握手取回,实现免填绑定。好处:激活率从30%升70%,任务完成率翻倍。任务流量可观测:AAIF信号闭环Xinstall任务流量模块注入AAIF兼容信号:调用链、延迟分布、错误分类。从Agent发起到终端事件,形成跨层图谱。企业可审计ROI,支持gRPC流追踪。注:本文探讨的MCP网关与多Agent任务归因属于对未来分发趋势的前瞻性技术延展与思考。目前此类高度定制化链路尚未作为标准功能全量实现,如App开发者有类似高阶业务需求,欢迎联系Xinstall客服团队进行技术探讨或共同定向研发拓展。这件事和开发 / 增长团队的关系面向开发 / 架构团队预留ChannelCode字段,支持gRPC metadata注入;SDK接入一周完成;设计无状态事件模型,避免本地缓存依赖。面向产品 / 增长团队定义Agent任务场景标签;用任务ROI优化投放;监控多云信号,调整分发策略。常见问题(FAQ)### MCP协议是什么?MCP(Model Context Protocol)是标准化模型与工具连接协议,支持远程服务器、授权、tasks,支持从stdio到gRPC演进。### MCP网关的作用?网关统一入口、协议适配、权限校验、流量治理、审计汇聚,是MCP从实验到生产的控制平面。### 无状态请求的优势?剥离会话依赖,提升横向扩展、故障恢复;结合云端参数还原,确保任务完整性。### gRPC在MCP中的定位?提供HTTP/2多路复用、双向流,支持低延迟高吞吐,适配网关治理。### AAIF可观测信号协议如何工作?标准化调用链、错误、延迟信号,便于跨层追踪,形成自省闭环。行业动态观察MCP峰会标志协议从连接层向治理层跃迁,企业级落地依赖网关、无状态与观测协同。这对App分发意味着任务流量崛起:Agent工作流取代页面浏览,参数还原与全链路归因成刚需。现在是窗口期:重构数据体系,拥抱ChannelCode与任务信号,能在MCP生态中抢占先机,避免“云强端弱”的尴尬。
558
数据统计类软件多少钱?App 团队在采购商业归因工具时应如何评估其定价逻辑与投入产出比? 一套成熟的商业归因与数据统计系统,市场报价从每年几千元的 SaaS 订阅费到数十万元的私有化部署费用不等,具体取决于事件并发量、月活规模及所需的高级功能模块。在移动增长和 App 开发领域,行业里越来越把高精度的数据统计与归因工具视为驱动业务增长的“水电煤”基建。面对如此悬殊的报价区间,企业往往在“采购付费工具”与“拉上研发自己写一套”之间犹豫不决。本文将深度解析主流商业归因工具的定价模型,结合 TCO(总拥有成本)诊断案例带你量化服务器与维护的隐性成本,客观引出类似 Xinstall 这种成熟的第三方开箱即用工具在降低研发冗余与提升核算 ROI 方面的核心优势。主流数据统计类软件的定价模型(采购成本解析)在评估任何数据工具的真实价格之前,我们必须先理清当前 SaaS 行业的三大主流收费逻辑。不同的计费模型对不同生命周期的 App 会产生截然不同的成本压力。按事件量/API调用量计费 (Pay-as-you-go)这是当前云计算与数据基建领域最主流、也相对最公平的定价逻辑。工具服务商根据 App 每日产生的归因请求、点击事件、激活回传或自定义埋点事件的总体体量来计费。通常,服务商会提供一个免费的基础额度(例如每月前 10 万次请求免费),超出部分按阶梯单价(如每千次调用 0.05 元)进行收费。这种模式非常适合流量波动较大的初创期产品,或者是严重依赖特定节假日爆发的大促期 App。在流量低谷期,企业无需为闲置的服务器资源买单;在流量高峰期,底层架构的弹性扩容成本由工具方承担,企业只需支付相应的事件数据处理费。按月活用户数(MAU/DAU)阶梯计费部分商业统计工具为了简化客户的预估难度,直接绑定 App 的活跃用户体量进行阶梯式包年/包月计费。例如:MAU 在 1 万以内免费,1 万至 10 万收取固定年费,50 万以上则进入高级企业版定制报价。这种模式对工具提供商而言,底层存储和计算资源的成本相对可控且易于预测。但对广告主而言,如果 App 的特性是“高新增、低留存”(如某些轻度超休闲游戏或纯靠洗流量的工具产品),按 MAU 计费可能会显得不够划算,因为大量被算作活跃用户的边缘流量并未带来同比例的商业价值,却推高了软件采购水位。按功能模块与私有化部署收费基础的渠道归因与激活统计往往只是数据体系的第一步。当团队的精细化运营需求加深,需要引入漏斗分析、热力图、用户分群乃至构建完整的 [用户行为分析系统](F41 URL 占位) 级别的中台时,采购成本通常会发生跃升。此外,如果出于金融合规、医疗数据隐私保护(如满足 HIPAA 或 GDPR 严格条款)的要求,企业必须要求数据统计软件进行私有化部署(On-Premise,即将整套系统安装在企业自己的内网服务器上),那么由于涉及到高昂的驻场实施、专属架构适配与买断授权,其采购成本通常会跃升至每年十万至百万元级别。选型对比模型:自研数据基建 vs 采购付费工具许多技术出身的创始团队在面对商业 SaaS 的报价时,第一反应往往是:“不就是写个接口记录一下客户端传上来的渠道参数吗?我们自己花两周也能写出来。”这种认知往往会导致后期惨痛的预算失控。自建系统的初始沉没成本(服务器与人力)评估“自研 vs 采购”的核心在于不能只看表面报价,必须引入严谨的 TCO(总拥有成本) 财务核算模型。研发团队眼中的“写个接口”,在真实复杂的移动端环境中,意味着需要投入资深 iOS/Android 开发去维护不断变动的系统 API(如应对苹果 SKAdNetwork 的隐私调整),需要高级后端架构师设计抗高并发的写入队列,还需要 DBA(数据库管理员)进行底层调优。将这些核心研发人员几百个小时的工资时薪折算下来,自研一套仅具备基础功能的统计系统,其初始沉没成本就已极其高昂。SaaS 付费工具的敏捷优势与技术兜底SaaS(软件即服务)的底层商业逻辑,本质上是让成千上万家企业用极低的订阅费(通常是几千到几万元/年),共同分摊并共享了顶尖数据技术团队的研发与迭代成果。采用付费商业工具,不仅意味着开箱即用,更重要的是获得了隐性的“技术兜底”。无论是安卓厂商商店的分包逻辑变更,还是各大小程序平台接口参数规则的迭代,都有专门的 SaaS 研发团队在第一时间完成底层 SDK 适配。企业完全免去了因系统环境升级带来的无止境维护成本,可以将宝贵的研发资源全盘投入到自身核心业务逻辑的开发中。技术诊断案例:App 归因自研系统的“隐性成本黑洞”为了具象化说明自研统计系统的风险,我们来看一个真实的成本对账与系统重构案例,剖析缺乏经验的数据基建是如何压垮预算的。异常现象:自研统计系统频频宕机,维护成本超支某中型社交 App 团队为了“省下每年几万元的商业统计软件采购费”,由内部的 PHP 后端团队耗时两周,自研了一套简单的渠道参数匹配与归因系统。在平稳期,这套系统勉强支撑着每天几千次的新增记录。但在随后的一次全网 KOL 裂变推广大促中,短时间内涌入的百万级并发点击直接击穿了自研系统的数据库。不仅导致渠道统计大屏全面宕机、归因数据严重丢失,更要命的是,为了抢修和硬抗峰值,运维团队临时紧急拉起了多台顶配云主机,导致当月云服务器账单环比暴涨了整整三倍。省下的软件采购费被隐性维护成本彻底吞噬。数据与诊断过程:底层并发拥堵与服务器扩容对账技术合伙人紧急介入,开展全链路的 TCO 成本核查与系统对账。在盘点云端慢查询日志时,发现了底层架构的致命缺陷:由于自研系统缺乏先进的异步消息队列(如 Kafka)和内存级高频缓冲层(如 Redis Cluster),前端传来的每一次广告点击和激活事件,都会直接对后端的 MySQL 关系型数据库发起写锁(Row Lock)。在百万并发下,这种同步写入机制瞬间耗尽了数据库的连接池。为了扛住大促的突发流量,运维人员只能采用最原始的“堆机器”战术。经严谨的财务对账,仅大促这三天额外增加的带宽峰值费用和高配 RDS 云数据库扩容费用,加起来就已经超过了市面上头部专业 SaaS 归因工具整整一年的高级版订阅费。技术介入:废弃自研,迁移至成熟商业 SaaS 平台面对算错的经济账,决策层立刻叫停了无底洞般的自研基建投入,将全渠道统计与防作弊模块彻底剥离,直接以 API/SDK 形式接入了成熟的第三方商业 SaaS 平台。重构后,那些极耗算力的底层脏活——如海量点击的高并发接收、设备指纹特征的毫秒级去重计算、以及虚假流量的防刷拦截特征对比,全部交由 SaaS 服务商庞大且经过深度优化的弹性计算集群来承担。App 自身的后端系统中,仅保留了一个极其轻量级的 Webhook 数据接收接口,只负责被动接收 SaaS 端清洗并确认有效的“最终归因成功明细”入库。产出结果:IT 基础设施成本降低 65%,ROI 大幅回正完成统计模块的整体迁移后,团队再也不需要为了应对不可预知的运营活动峰值而储备昂贵的冗余服务器资源。财务团队在下一个季度的模型重新测算显示,涵盖云主机消耗、带宽峰值以及 DBA 日常人工巡检工时在内,App 整体的 IT 数据基础设施成本骤降了 65%。与此同时,数据流转链路的可用性稳定达到了 99.99%,彻底告别了丢单漏单。该专业统计工具的采购 ROI(投资回报率)实现了超预期的正向回本。商业归因工具选型与高 ROI 采购策略在决定了走采购路线后,面对市场上琳琅满目的 SaaS 产品,如何把预算花在刀刃上?利用 TCO 模型核算全生命周期成本企业在进行采购时,必须将视线放长远,结合 [报表系统自动化设计](F71 URL 占位) 的长期数据流转需求,建立全生命周期成本核算机制。这意味着你不能仅仅对比两家厂商标价上的“年费订阅单价”。你必须把“工程师对接 SDK API 所需的研发工时”、“后续历史数据跨库迁移的工程成本”、“运营团队上手新后台的培训学习成本”,甚至“工单响应速度导致的业务停滞风险”全部换算成财务数字算入采购总价中,才能避免陷入低价劣质工具带来的预算陷阱。利用 Xinstall 等专业工具实现开箱即用对于追求敏捷迭代的中小型及高速成长的移动 App 而言,选择类似 Xinstall 这样专注深耕渠道统计、全链路参数归因与反作弊的成熟工具,能以极具性价比与竞争力的阶梯定价模型解决 90% 的增长痛点。通过完善的标准化 SDK 与后端接口接入,研发团队在短短几天内就能跑通底层数据闭环,真正实现了开箱即用,让有限的资金与算力全部服务于核心商业模式的增长。常见问题(FAQ)小团队预算有限,应该选择免费版还是直接购买商业版?对于日活(DAU)在 1 万以下、且暂无大规模买量预算的初创团队,强烈建议优先利用各大平台提供的“免费基础额度”进行冷启动期的业务逻辑验证,控制早期现金流。但是,当团队开始在广点通、穿山甲等渠道投放真金白银的商业广告时,必须果断升级到 SLA(服务等级协议)有保障的商业付费版。因为在花钱买量阶段,哪怕因免费版限流导致的 1% 归因不准或漏单,其造成的广告费浪费往往就远超商业软件一整年的采购价。数据统计类软件的“私有化部署”为什么那么贵?私有化部署(On-Premise)的本质是把原本运行在公有云上的庞大复杂微服务架构,强行移植到企业的内网机房。这不仅意味着软件代码使用权的买断费,服务商还需要派遣高级架构师驻场,根据企业内部极度复杂的 IT 网络拓扑、防火墙策略以及合规要求进行耗时数月的独立环境适配与高可用压测。这种极高的人力实施成本与后续无法规模化热更新的独立运维成本,共同决定了私有化部署数十万起步的报价门槛。如何评估一款付费数据工具是否真正带来了正向的回报?评估数据工具 ROI 的核心公式在于:“数据驱动挽回的显性损失 + 工具带来的隐性人效提升”是否大于采购成本。举个例子:如果该工具的底层风控能力帮你精准识别并拦截了每月 1 万元的黑产渠道刷量作弊;或者其自动化的多维报表系统,每天为你的 3 个数据运营人员节省了总计 4 小时的人工拉表对账时间。只要这些挽回的营销资产与节约的团队工时总价值,超过了工具每月的订阅均摊费用,那么这款数据工具的实际 ROI 就是绝对正向且值得长期持有的。
663
H5转App下载怎么统计?无论是在信息流买量、社群裂变还是短信营销中,H5 落地页永远是承接流量的第一站。然而,当用户点击 H5 上的“立即下载”按钮后,数据往往就进入了黑盒。精准统计 H5 到 App 的转化,必须打破浏览器与应用商店的跨端隔离。通过部署智能落地页,结合设备指纹端云匹配与剪切板参数兜底技术,可以在用户点击 H5 瞬间暂存渠道参数,待用户打开 App 时精准还原追踪。本文将剖析 Web to App 链路中的三大数据断层,拆解跨端传参的核心底层技术,并结合物理对账逻辑与某电商大促的排障案例,展示如何利用 Xinstall 等归因工具清洗跳转折损,将全链路转化追踪准确率跃升 79.5%。H5引流App面临的“三大数据断层”在移动端营销中,H5 网页拥有极强的跨平台分发能力,但它与本地 App 之间横亘着一道由操作系统和应用商店筑起的高墙。如果不加干预,这道高墙会吞噬掉绝大部分的归因数据。跨端隔离:离开网页后参数全部丢失传统的网页统计工具只能监控前端的页面浏览量(PV)和按钮点击量。营销人员习惯在 H5 的 URL 后面拼接各类追踪参数,以此来区分不同的广告计划或渠道来源。然而,一旦用户在 H5 页面点击下载,系统会将其强制跳转至苹果 App Store 或安卓各大应用商店。在这个跨域跳转的过程中,网页携带的所有 UTM 参数都会被商店的底层安全机制彻底切断。当用户历经波折下载并激活 App 时,App 的后台完全无法识别这批新用户究竟来自哪个具体的网页,最终只能将其统统归入“应用市场自然搜索量”。唤起失败:各大浏览器的强力拦截H5 引流不仅面向新用户,还要负责老用户的拉活。理想状态下,如果用户手机上已经安装了该 App,点击 H5 上的按钮应该直接唤起 App。但是,国内各大超级 App(如微信、微博、QQ)为了把流量锁在自己的生态内,其内置浏览器会对外部 App 的 URL Scheme 唤起协议实施极其严厉的封杀和拦截。这就导致大量高价值的老客回流动作被强行阻断,用户只能面对一个毫无响应的页面或报错提示。盲目结算:只看页面 UV 的预算浪费由于无法穿透应用商店的黑盒,很多广告主在进行 H5 渠道投放时,被迫采用按落地页的 UV(独立访客)或下载按钮的点击量来进行财务结算。这种结算方式极度危险。十万次的页面点击,到底转化了几个真实的 App 注册用户?没有人知道。这种盲目的数据断层,使得广告主极易沦为劣质渠道和刷量脚本的提款机,海量营销预算在“光有点击没有激活”的虚假繁荣中被消耗殆尽。跨端追踪技术:打通 Web 到 App 的信息桥梁要填平 H5 到 App 之间的数据鸿沟,必须抛弃传统的网页统计思维,引入一套能够跨越不同宿主环境的端云接力技术。动态参数拼接与环境指纹暂存技术重构的第一步,是在 H5 落地页的源码中集成极度轻量级的第三方归因 JS SDK。当用户在前端页面点击“立即下载”按钮的瞬间,这套 JS 脚本会立刻在云端静默抓取该设备的非敏感环境指纹,包括但不限于当前的公共 IP 地址、操作系统大版本、屏幕分辨率及浏览器 UA 信息。与此同时,系统会将当前 H5 页面的专属渠道参数(例如标明来源的 channel=toutiao 和标明内容的 page=A1)与这套设备指纹死死绑定,并安全暂存在云端服务器中。剪切板兜底与 App 端内精准匹配完成了指纹暂存后,H5 页面才会放行用户前往应用商店下载。当用户完成漫长的下载、安装流程,并首次打开 App 时,预埋在 App 内部的统计 SDK 会立刻启动自检。它再次采集当前设备的环境特征,向云端服务器发起高强度的比对请求。云端算法一旦发现匹配成功,便会瞬间将几天前暂存的渠道参数完美下发给 App。为了应对极端网络环境下的指纹模糊情况,系统通常还会辅以智能剪切板口令作为无感容错兜底,双管齐下,实现极高的跨端归因匹配率。深度链接的场景直达打通参数不仅仅是为了给财务算账,更是为了重塑用户的转化体验。跨端技术在下发渠道来源的同时,还能下发深层的业务场景指令。假设用户在 H5 落地页上浏览的是一款“限量版球鞋”,当他下载 App 并首次打开时,深度链接技术会自动跳过繁杂的新手引导和默认首页,直接将其精准路由至该款球鞋的商品详情页。这种消除跳转撕裂感的场景还原,能将新用户在激活后的首单转化率提升一个量级。物理对账:H5 渠道的漏斗排障与风控有了全链路的数据追踪底座,运营团队就拥有了排查转化梗阻和打击恶意刷量的探照灯。漏斗横向对比:定位页面加载与跳转折损通过归因后台,运营人员可以清晰地建立起“H5访问量 -> 按钮点击量 -> 实际激活量 -> 注册量”的四级完整漏斗。在进行多渠道横向对比时,如果发现某区域的 H5 渠道点击量巨大,但后续的激活率无限趋近于零,就需要立即派技术人员实地排查。这通常意味着该 H5 域名在当地被运营商恶意劫持,或者被微信安全中心强行施加了红屏拦截,导致真实用户根本无法抵达下载环节。CTIT 监控剔除“脚本秒刷”点击H5 落地页是最容易遭受黑灰产攻击的敞口。作弊团队通常利用自动化脚本疯狂模拟点击网页上的下载按钮以骗取流量费。应对这种攻击,最有效的物理对账手段是监控 CTIT(点击到安装时间差)。正常的 H5 跳转下载,受限于应用商店的响应和包体大小,至少需要数十秒的真实物理耗时。如果系统对账发现,某渠道带来的海量激活全部集中在 H5 按钮点击后的 1 秒内瞬间完成,系统将直接触发风控熔断,判定为机刷假量并拦截结算。后置业务指标对账防范 CPS 作弊为了防范更高级的真人代刷,必须将 H5 落地页带来的归因参数一直透传至后端的业务中台。不要停留在激活层面对账,而是用该批次用户的次日留存率、真实客单价和复购频次作为最终的防线。通过建立严格的 ROI 准入模型,坚决汰换掉那些表面点击转化率极高,但实际业务贡献为零的劣质 H5 投放渠道。专家诊断案例:某电商大促 H5 投放破局为了直观展现 Web to App 全链路追踪的威力,我们复盘某头部生鲜电商是如何在双十一大促中修复 H5 跳转黑洞的。百万 UV 换来极低的新增转化在去年的双十一预热期,该生鲜电商向全网各大信息流平台和自有社群投放了数百个“新人专享百元生鲜券”的 H5 活动页。大促首日,活动极度火爆,H5 网页的 PV 迅速突破百万,前端下载按钮的点击率远超预期。然而,负责大盘增长的业务总监很快发现了异常:App 后台统计到的新户注册量寥寥无几,根本匹配不上前端的爆发流量。更为严重的是,客服中心被打爆,大量通过 H5 引导下载了 App 的新用户愤怒地投诉“下载后根本找不到宣传的百元券在哪里”。由于缺乏跨端追踪,运营完全不知道这些愤怒的用户是从哪个具体的 H5 页面来的,危机一触即发。链路重构:全面接入端云匹配与拉起协议面对断崖式下跌的口碑与白白流失的流量,技术中台连夜进行抢修,全面接入了 Xinstall 归因引擎。他们将传统的静态 H5 彻底替换为具备端云指纹匹配功能的智能落地页。针对手机里已经装有 App 的老用户,重构了 Universal Links 协议,一旦点击立刻无缝唤起 App 并直达发券页面;针对占绝大多数的新用户,启用了设备指纹暂存机制。当新用户历经应用商店下载打开 App 的那一刻,系统不仅精准还原了其来源渠道,还通过场景直达技术,自动在首页弹出了对应的百元生鲜券领取窗口,彻底抚平了体验断层。优化成果:找回断层数据,追踪准确率飙升新架构上线次日,立竿见影的效果显现出来。系统通过指纹匹配与剪切板兜底,成功找回了近 40% 原本流失在应用商店跳转黑盒中的渠道追踪参数。得益于精准的场景还原,新用户领券后的首单转化率实现了翻番。大促结束后的整体复盘数据表明,该电商平台的 H5 全链路转化追踪准确率历史性地跃升了约 79.5%。市场部不仅清晰地核算出了每一个外部买量渠道的真实 ROI,还通过漏斗对账成功剔除了几家涉嫌制造虚假点击的劣质媒体,彻底盘活了网页端的引流效能。常见问题微信内置浏览器屏蔽 H5 下载链接怎么办?在微信生态内直接跳转应用商店是极易触发系统级封杀的。专业的应对方案是在 H5 页面中增加一层“智能跳转遮罩”。当用户在微信内点击下载时,页面会弹出一个视觉动图,引导用户点击右上角的三点菜单并选择“在浏览器中打开”。由于用户在微信内首次点击按钮那一刻的设备指纹已经被云端安全暂存,所以即使后续跳到了外部 Safari 或安卓原生浏览器去完成下载,渠道参数依然能够完美接力,不会造成数据丢失。用户在 H5 没点下载,自己去商店搜了算谁的?这种情况属于广告学中的“曝光归因(View-through)”范畴。由于用户仅仅浏览了页面而没有产生实质的点击动作,H5 源码中的 JS 脚本无法在前端触发设备特征的抓取与参数暂存。在主流的精确点击归因模型中,系统通常会将其算作应用的自然搜索新增。如果企业非常看重品效合一,可以通过放宽匹配逻辑,结合时间窗与大范围 IP 进行模糊评估,但这通常仅作为内部运营的参考,不作为对外费用结算的硬性依据。H5 传参统计对老用户唤醒有效吗?极其有效且转化价值极高。对于设备上已经安装了该 App 的老用户,智能 H5 落地页会优先尝试通过底层的深度链接协议(例如 iOS 的 Universal Links 或安卓的 App Links)直接将其静默唤醒。在唤醒的瞬间,H5 链接上携带的 UTM 渠道参数和具体页面参数会被直接透传给 App 客户端。这不仅能让运营团队精确统计到老客的“拉活回流”业绩,还能让老用户无缝跳转至对应的活动参与页面,极大提升复购效率。
736
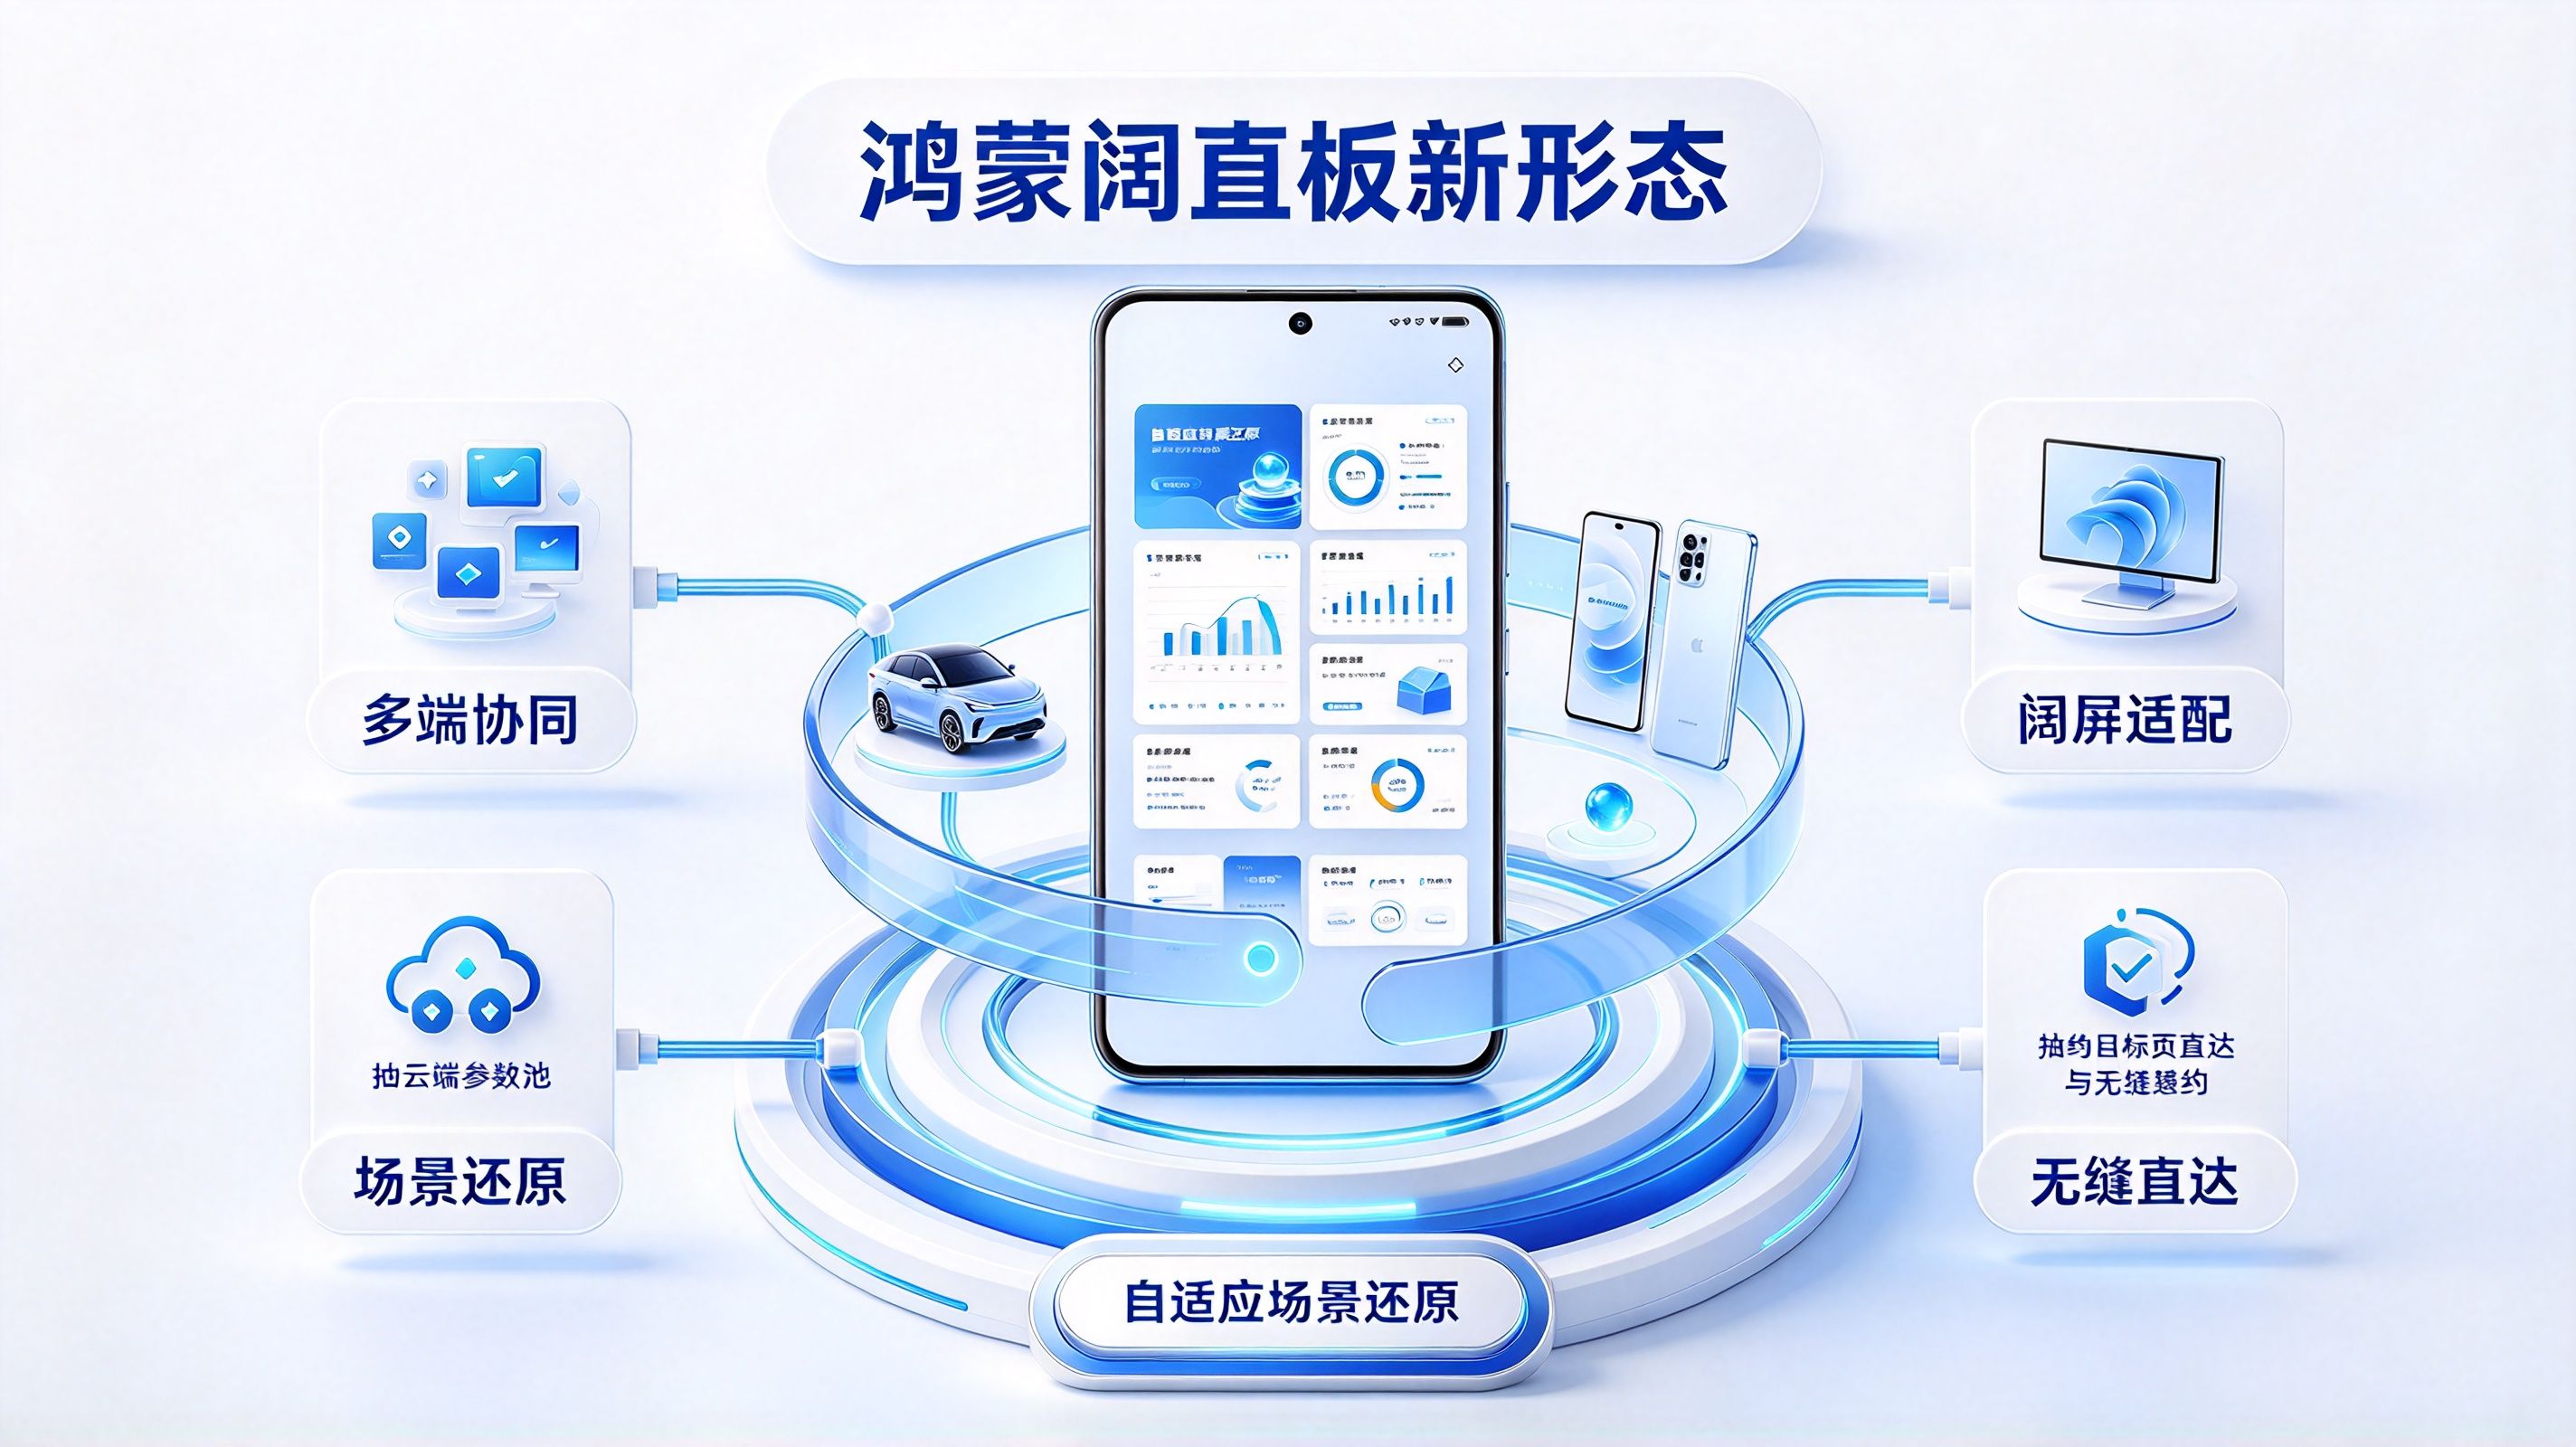
鸿蒙装机逼近1亿大关?阔直板新形态重塑移动端自适应场景还原
2026-10-21
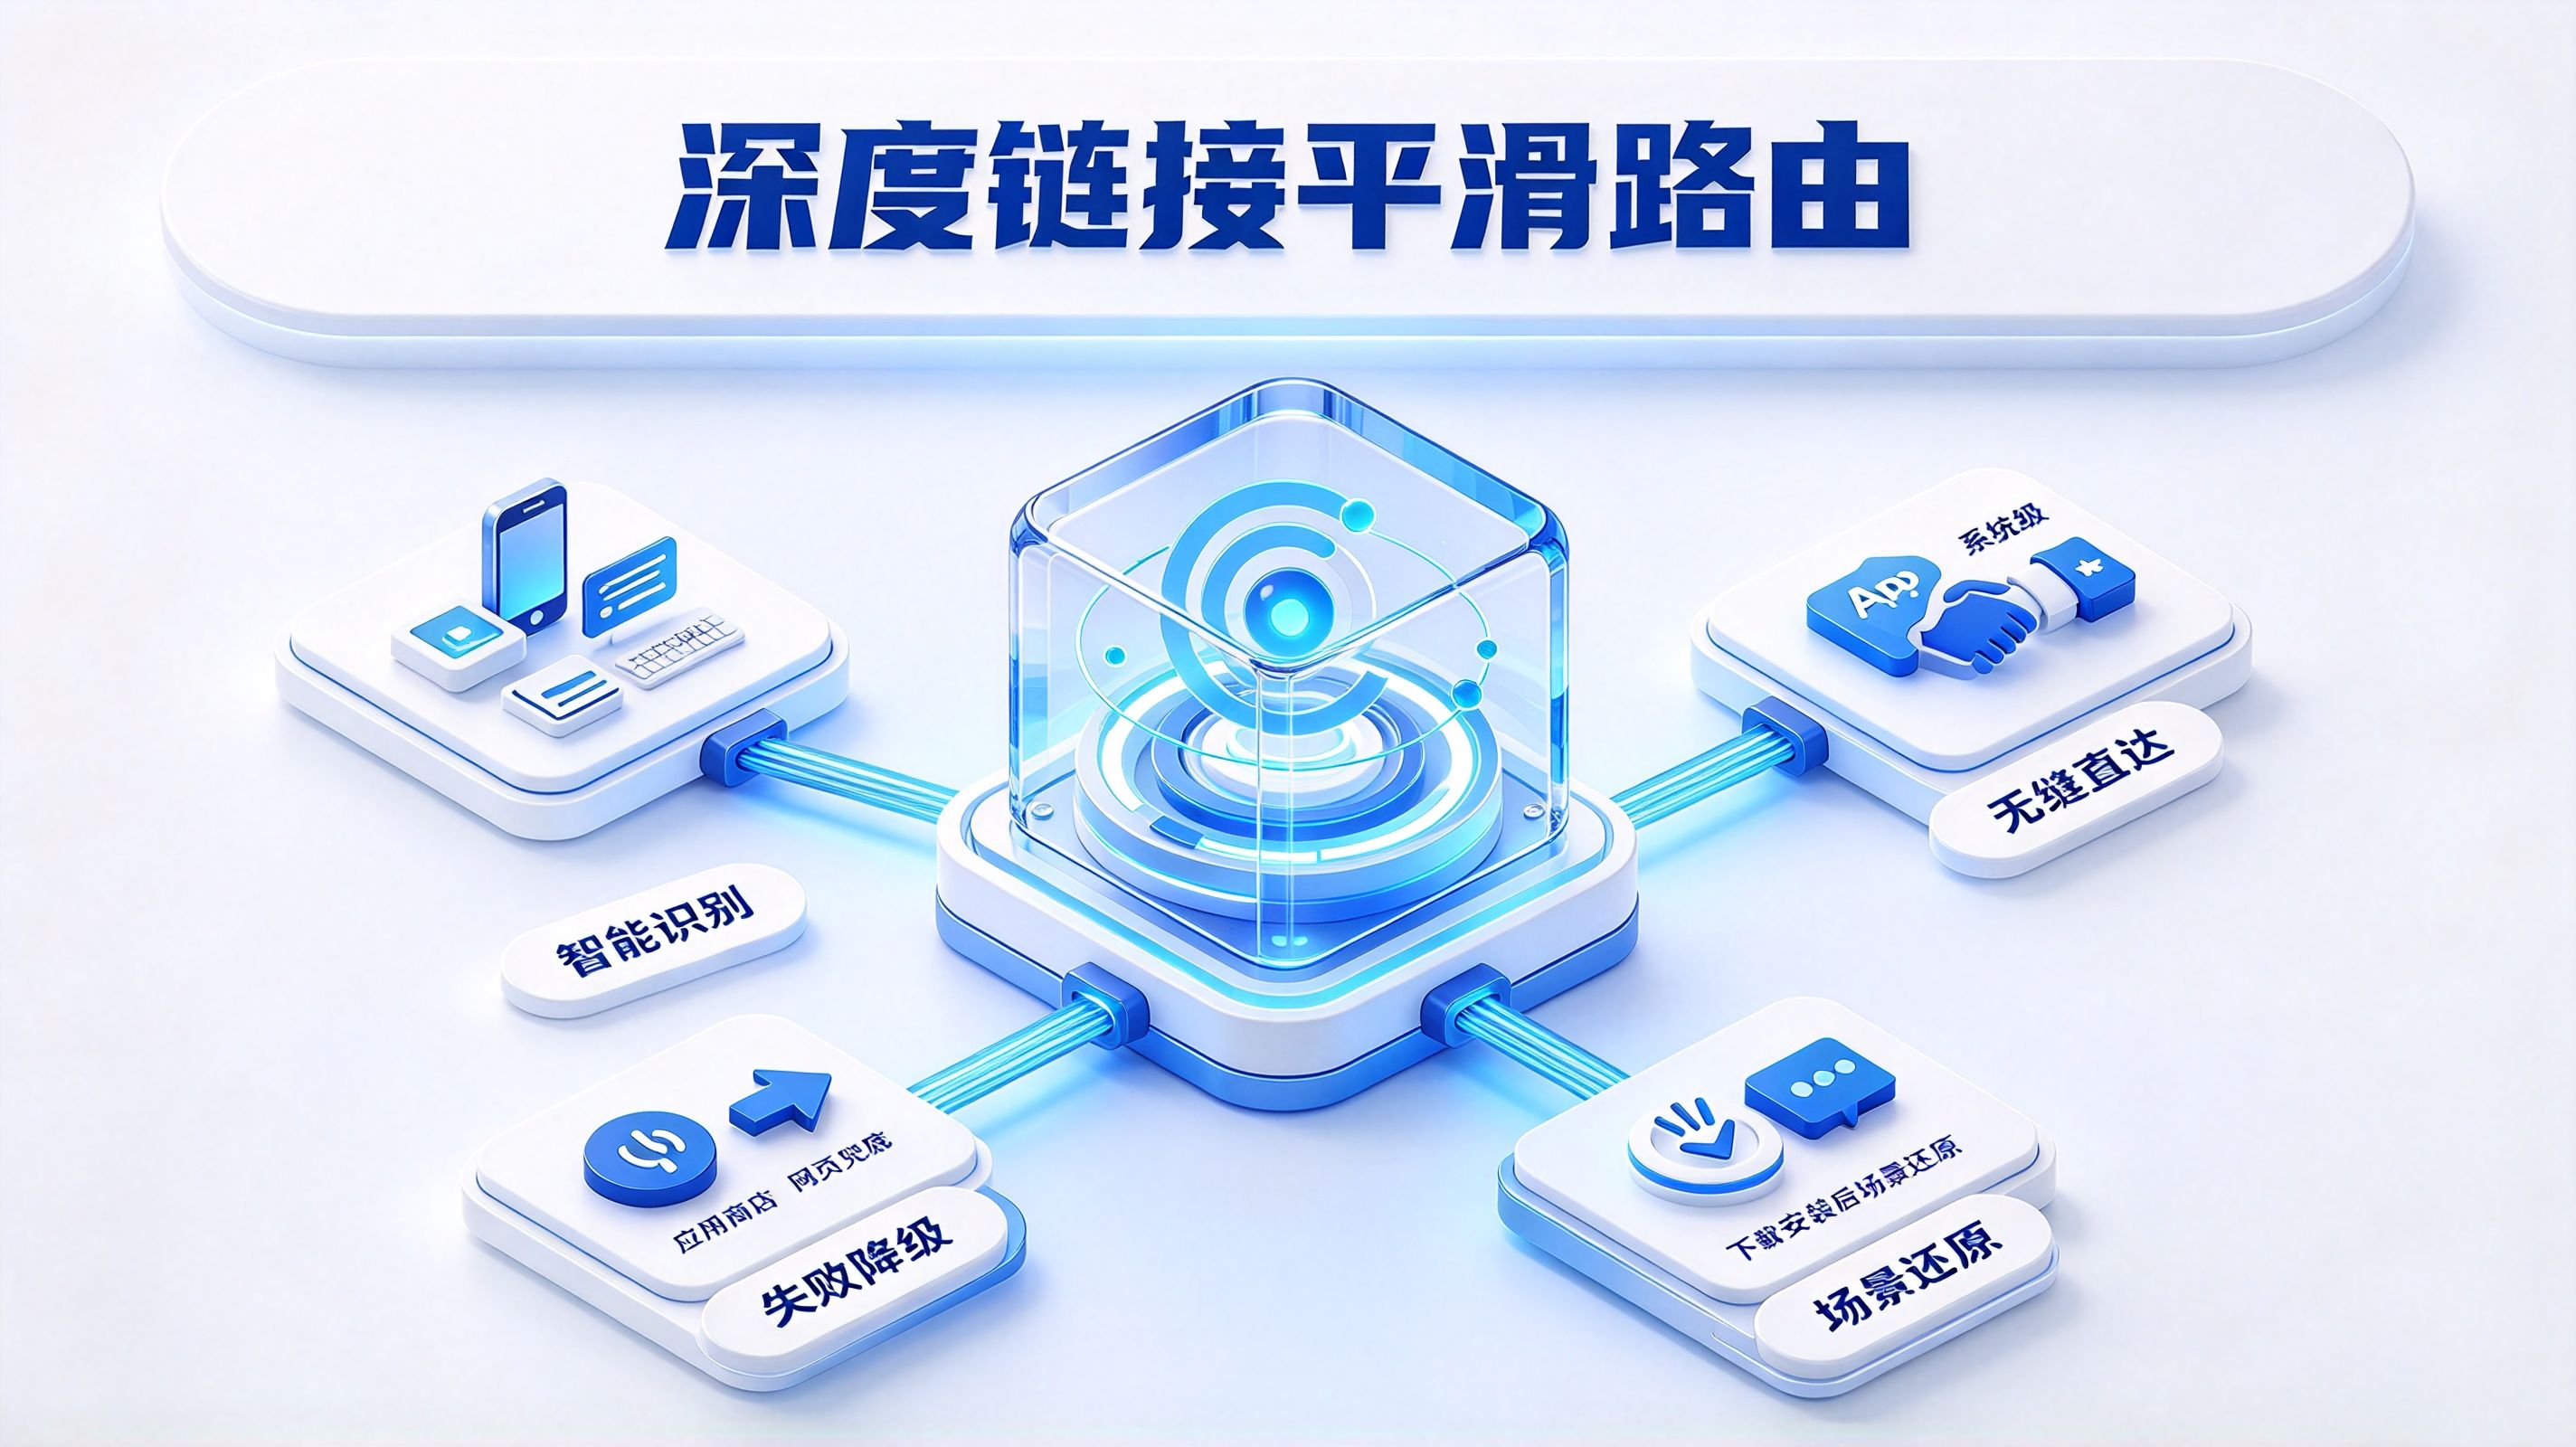
深度链接路由分发与失败降级怎么做更平滑?深度链接降级兜底方案
2026-10-20
深度链接转化追踪与 ROI 评估怎么做更有效?深度链接转化追踪方案
2026-10-20
AI工时达员工六倍?自主智能体普及倒逼企业级全链路归因
2026-10-19
AI短剧成算力新引擎?社群私域裂变呼唤全渠道精准链路归因
2026-10-16
Meta开源8160亿模型Muse?桌面算力觉醒驱动智能体跨端无损流转
2026-10-16
活动直达内页怎么实现?深度链接活动直达方案
2026-10-15
DeepSeek拟获千亿新融资?产业资本押注倒逼任务调用ROI精准归因
2026-10-13
智能传参和 Scheme 协议有何不同?智能传参与 Scheme 对比
2026-10-12
字节发现模型长上下文漂移?任务状态保持呼唤高可靠数据穿透
2026-10-12
字节发现模型长上下文漂移?任务状态保持呼唤高可靠数据穿透
2026-10-09
邀请关系怎么自动绑定?智能传参邀请关系绑定
2026-10-08
三星利润飙升782%?存储超级周期倒逼端侧应用长程任务优化
2026-10-08
免填邀请码机制怎么实现?智能传参免填邀请码
2026-10-07
预约下载怎么提升转化?深度链接预约下载优化
2026-10-07