手机微信扫一扫联系客服
联系电话:18046269997


 APP安装免填邀请码
 社交分享效果统计
 广告投放数据统计
 CPA/CPS推广效果统计
 App地推统计
 App拉起
 网页/应用内直接安装
 Android多渠道打包
 App安装后自动绑定
 App分享效果统计
 Deeplink深度链接
手机微信扫一扫联系客服
 Xinstall 分类:行业洞察 时间:2026-09-18 14:28:51
 5

智谱推出GLM-5.3-FlashX?推理速度提升5.0倍至最高200 tokens/s,依托10万张国产芯片底座优化工程算力。本文深度剖析高吞吐Infra重构、分级定价逻辑及Agent长任务执行链路,探讨开发者在模型提速背景下如何破解任务流量与跨端归因断层。
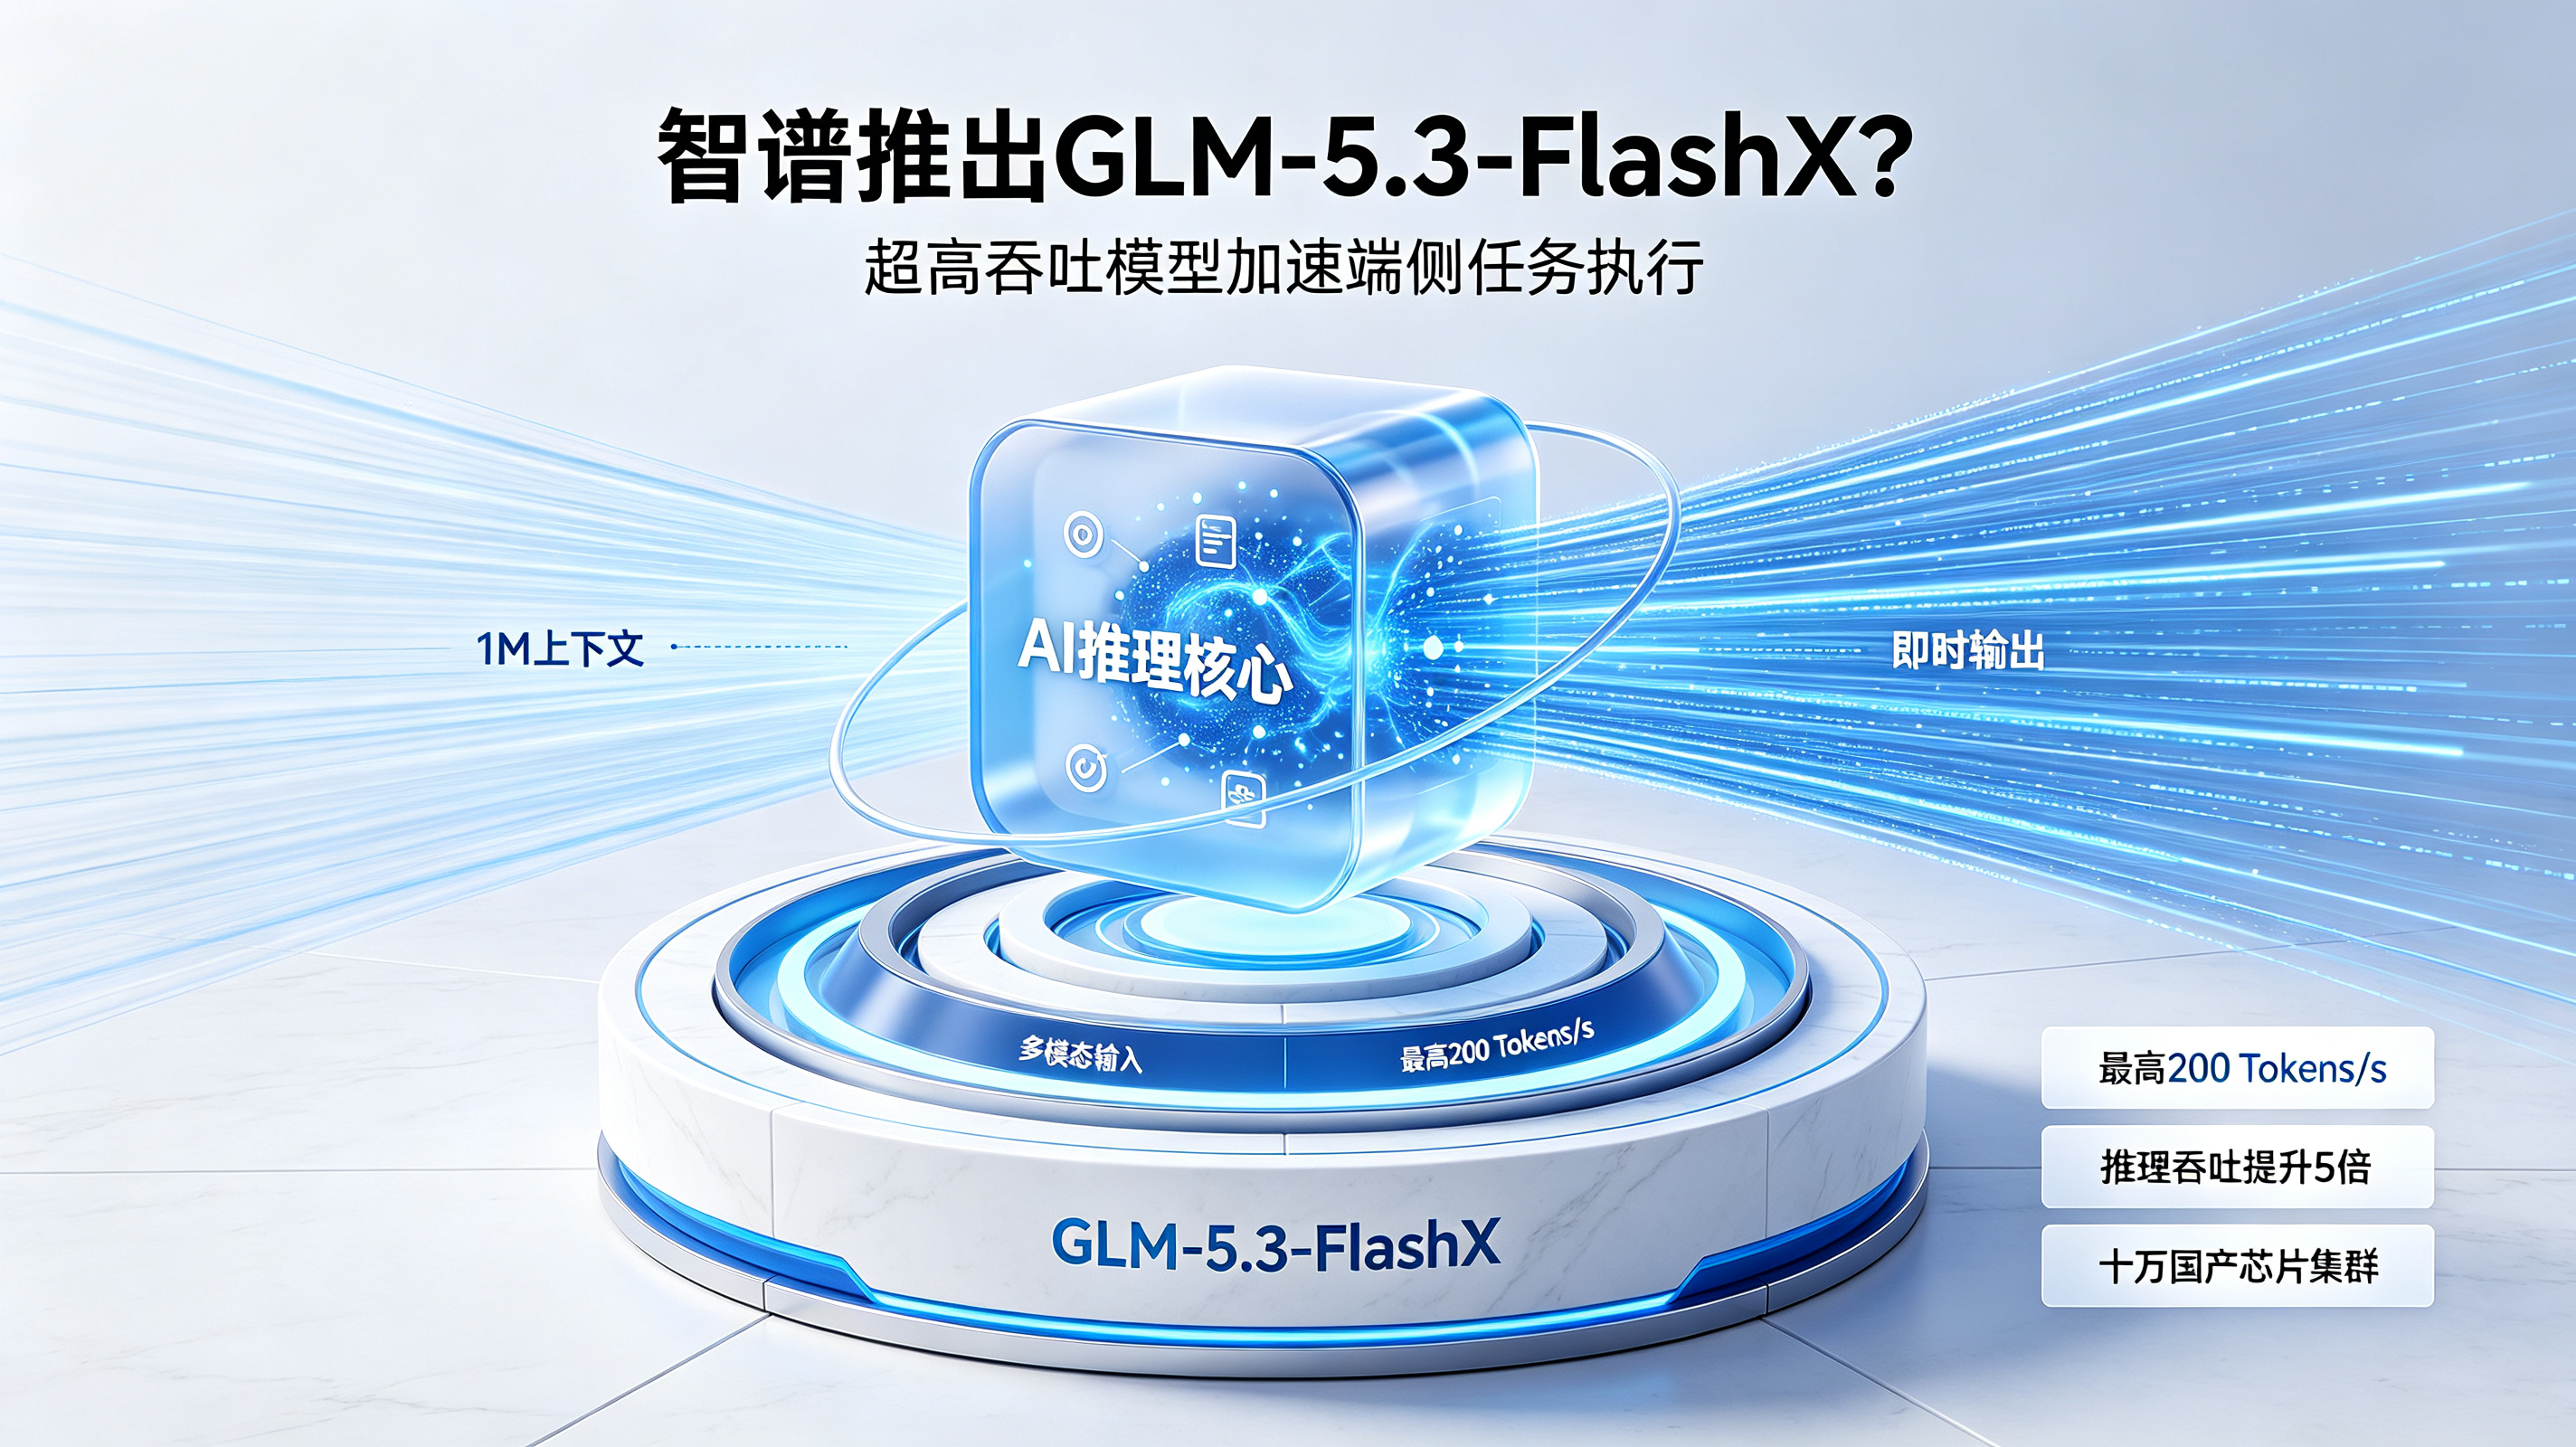
智谱推出GLM-5.3-FlashX?超高吞吐模型加速端侧任务执行?这一在大模型基础设施与产业落地端引发广泛讨论的性能跃迁,随着智谱于 9 月 18 日正式官宣新模型上线得到了全面证实。在大量开发者对轻量化、高实时性模型调用的迫切诉求下,智谱不仅面向全球开发者开放了该模型的 API,更亮出了最高 200 tokens/s 的极速推理吞吐,较此前版本的处理效率实现了整整 5.0 倍的跃进。伴随推理延迟的大幅压缩与高并发承载能力的释放,智谱推出GLM-5.3-FlashX在智能体长程规划与企业级高频交互中确立了更为严苛的执行效能标准,也让多端调用与跨场景任务流转中的链路接续痛点再次浮出水面。据IT之家关于智谱GLM-5.3-FlashX上线的客观报道披露,智谱此次在底层十万张国产芯片集群上实施了深度的工程化 Infra 优化,旨在让大模型从“单次文本生成”彻底迈向“复杂工作流实时交付”,这也预示着端侧与云端协同的智能体应用落地正在迈向深水区。
要理解 GLM-5.3-FlashX 所带来的技术冲击,不能仅盯着单纯的数字变动,而必须拆解其背后的算力底座与工程调度机制。在大模型产业逐步从学术刷榜转向工业级落地的阶段,模型推理的“端到端延迟”与“峰值吞吐速率”直接决定了一个应用能否在真实商业场景中站稳脚跟。
据官方披露,GLM-5.3-Flash 此前曾以“Ox Alpha”的代号在开发者群体中开启小规模测试,凭借轻量高效的特点积累了极高的调用密度。然而,随着海内外企业将越来越多的客服流转、文档批处理以及复杂 Agent 任务挂载至云端,传统的推理吞吐开始遭遇瓶颈。面对这一刚性需求,智谱并没有盲目堆砌通用算力,而是选择在已有 10 万张国产芯片构筑的庞大推理底座上,集中资源攻关工程 Infra 层。
在硬件异构集群环境下,实现最高 200 tokens/s 的稳定输出并非易事。这要求算力网络在计算、显存带宽与通信拓扑之间达成极致平衡。智谱工程团队通过对底层推理算子的深度定制、张量并行与流水线并行的自适应切分,以及针对注意力机制的高速缓存调度重构,最大化榨干了国产芯片的硬件利用率。这种跳过单纯的参数膨胀、转向追求单位时间内“高信息密度吐出”的工程路径,让国产算力在大规模商用服务中跑出了令人侧目的性能加速度。
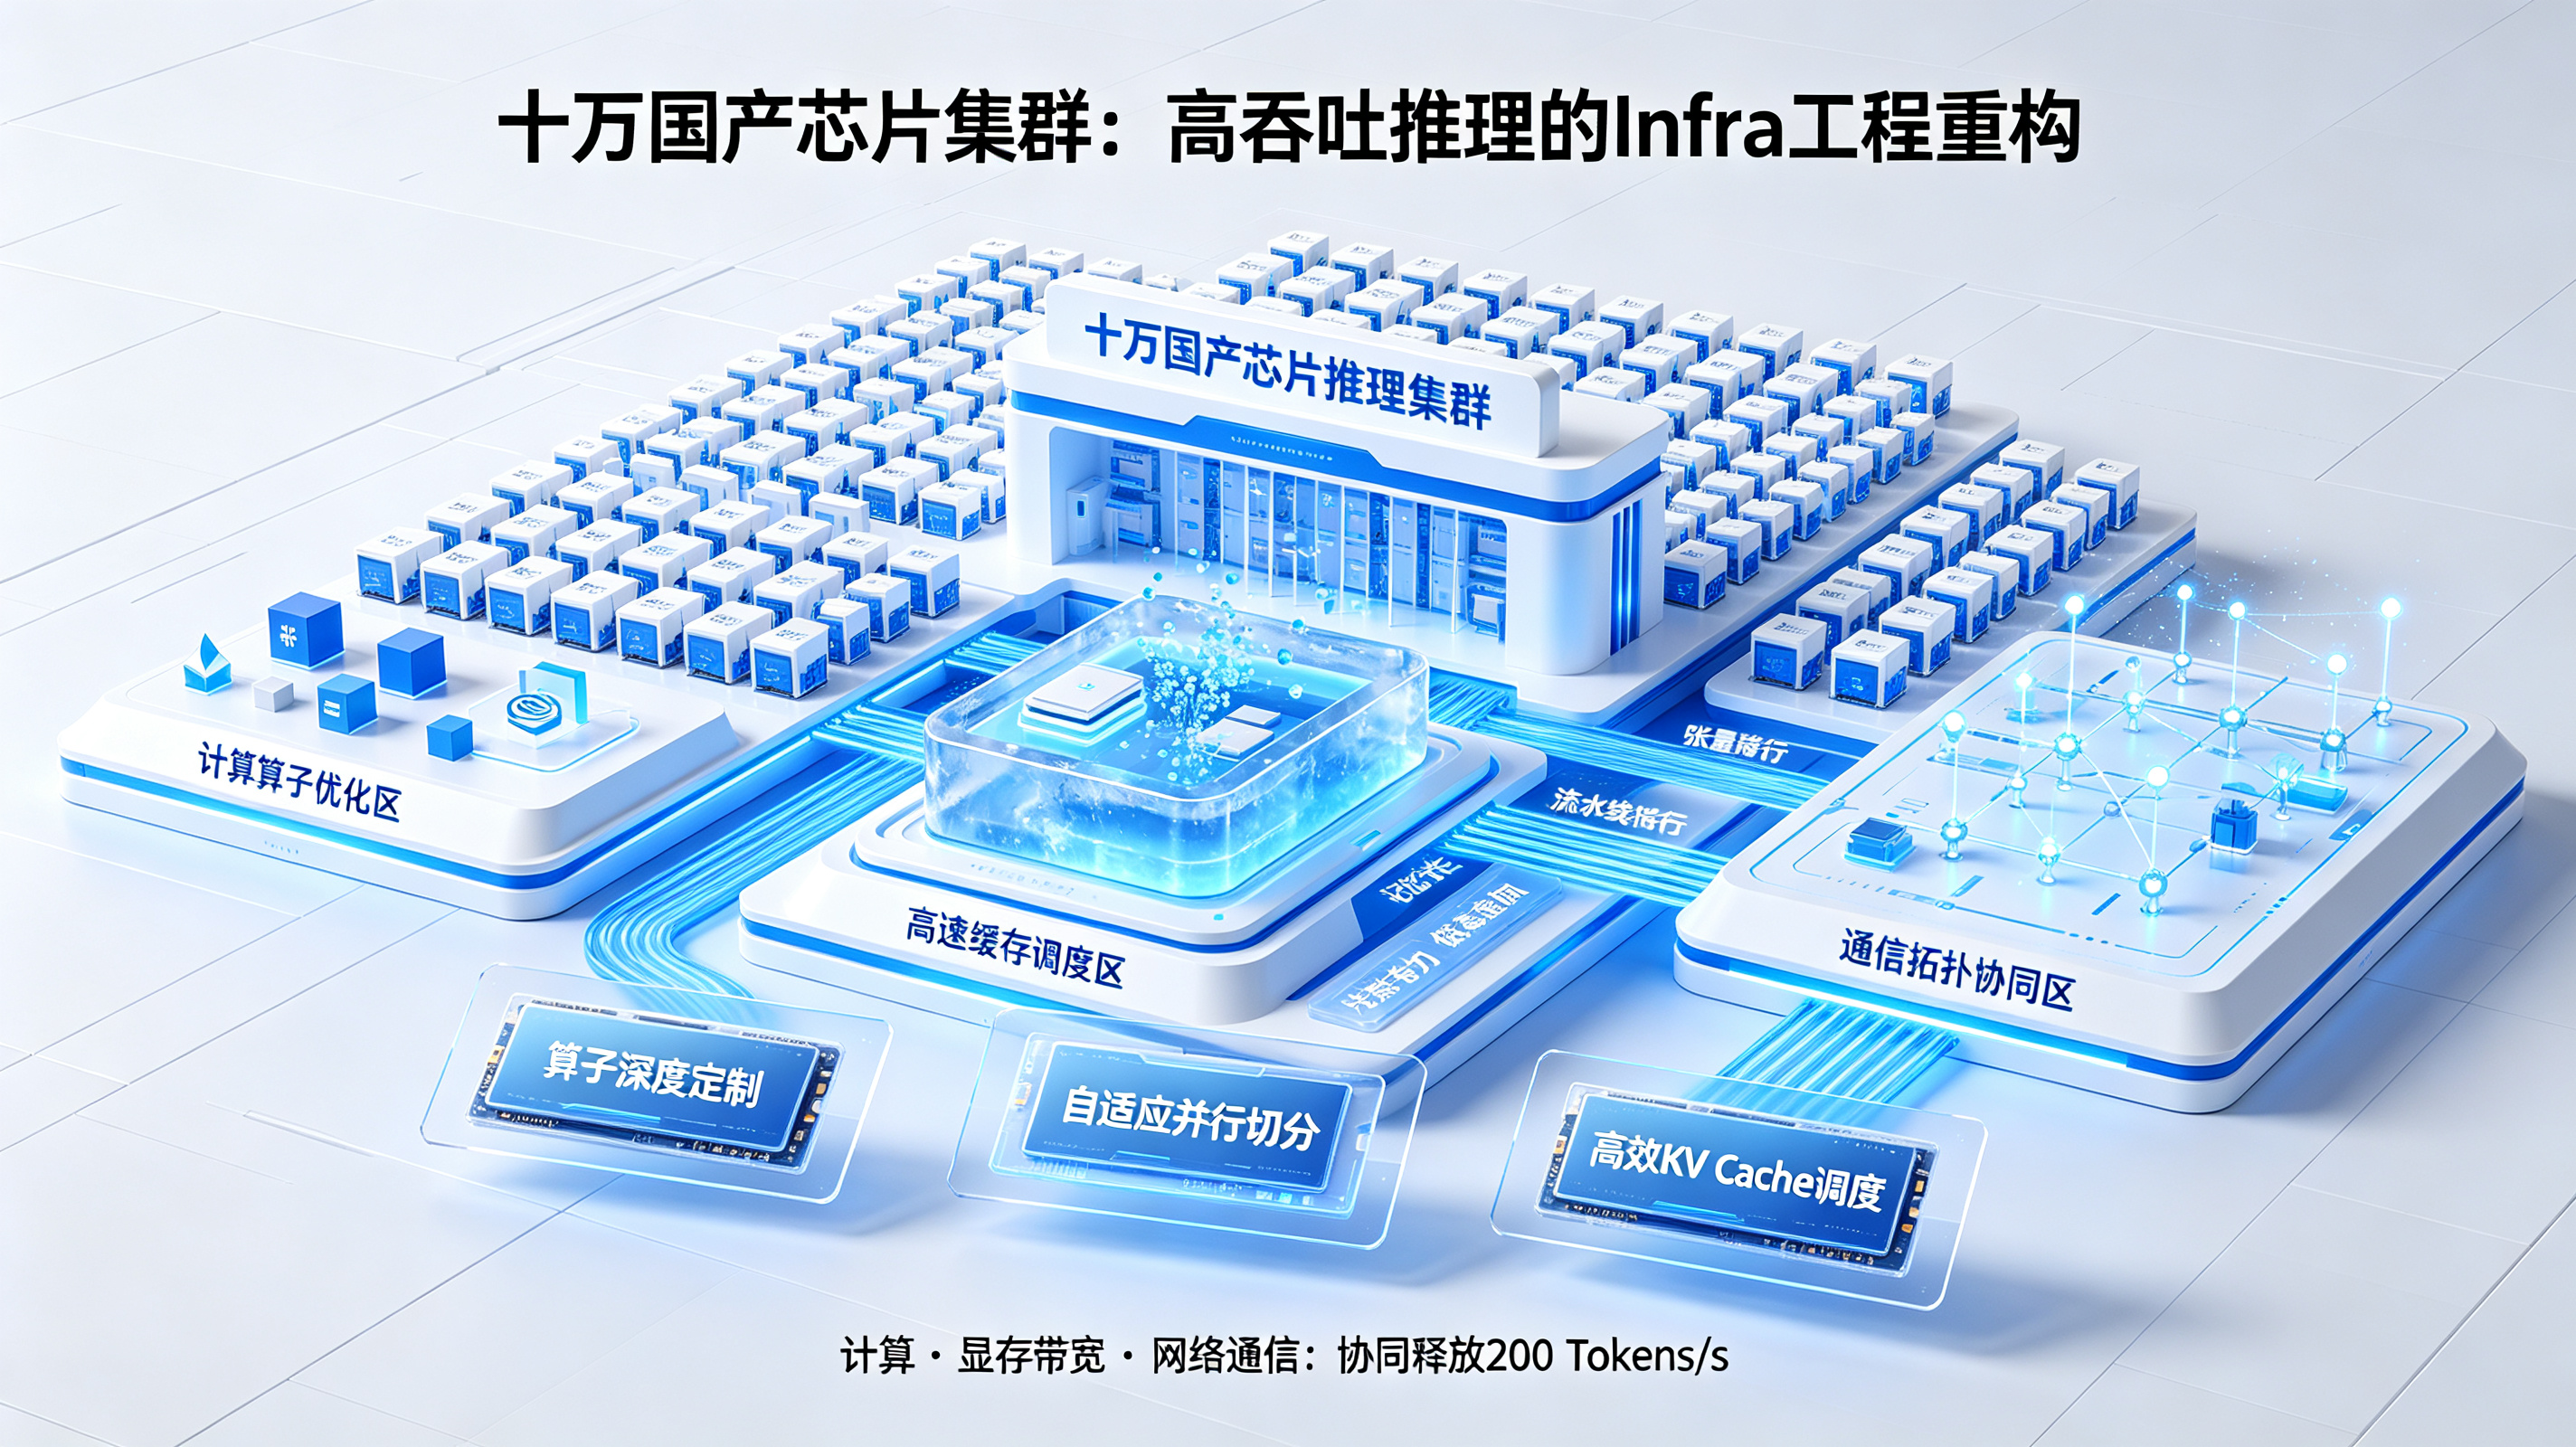
在参数规格与上下文承载力上,GLM-5.3-FlashX 保持了 1M tokens 的超大上下文窗口,同时原生支持图片、视频、文件与文本的多模态混合输入。这意味着它并非缩水版的特调模型,而是在保留了完整复杂语义理解能力的前提下,进行了激进的动态提速。
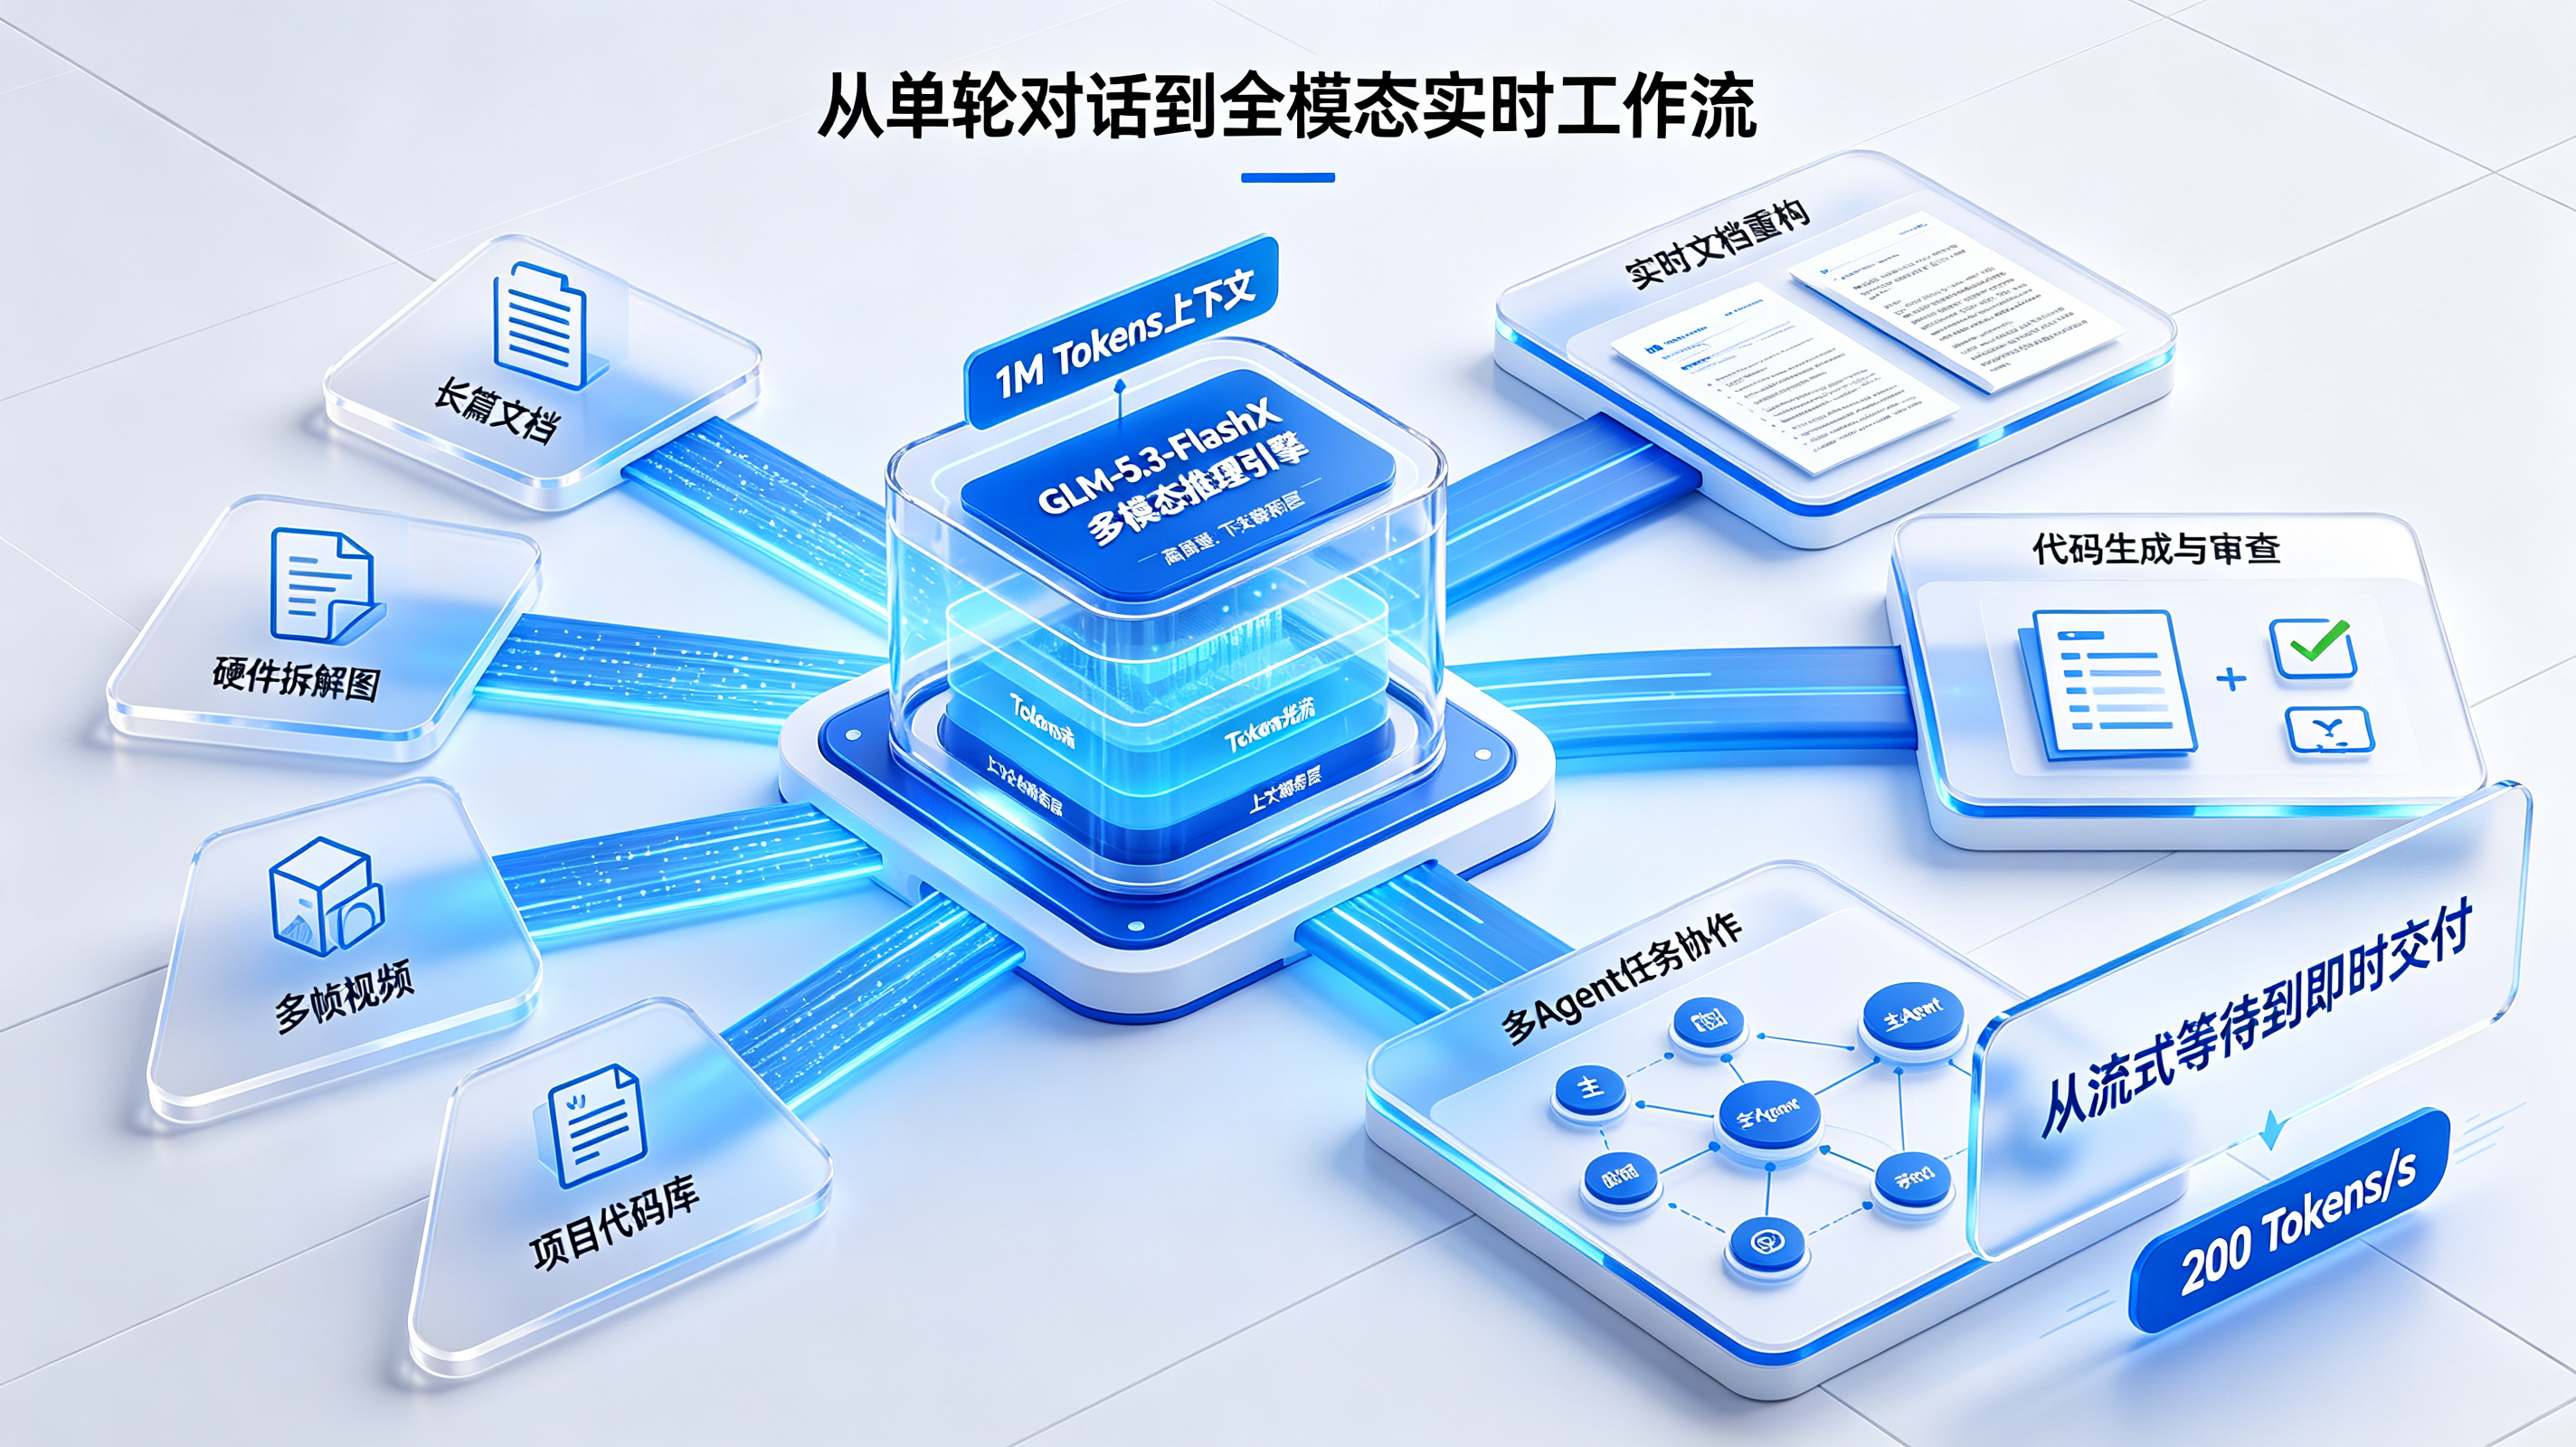
过去,当开发者让大模型阅读一份数十页的商业财报或解析一段技术讲解视频时,用户往往需要面对数秒乃至十数秒的“白屏等待期”。而在多智能体协作(Multi-Agent)场景下,这种延迟会被链式放大——一个负责拆解任务的主 Agent 如果耗时过长,下游负责检索、代码审查、格式排版的子 Agent 就会集体阻塞,导致整个任务的交付周期被拖长至无法忍受的程度。
当单实例推理速率飙升至 200 tokens/s 时,整个交互范式发生了根本性转变:
大段代码的生成、长篇文档的重构、多帧视频画面的时序关联分析,都从过去的“流式等待”演变为接近“瞬时倾泻”的交付体验。这种质变不仅降低了用户的跳出率,更让原本只能在离线批处理中运行的复杂任务,首次具备了嵌入即时交互界面的可行性。
伴随性能大幅飞跃的,还有智谱在商业化定价上的策略调整。官方公布的计费标准显示,GLM-5.3-FlashX 的输入单价为 2 元 / 百万 Tokens,输出单价为 7 元 / 百万 Tokens,缓存命中单价为 0.57 元 / 百万 Tokens(缓存存储目前限时免费)。相比于原版 GLM-5.3-Flash(输入 0.8 元、输出 2.8 元),新版本的整体定价上浮至原先的约 2.5 倍,但仍远低于旗舰级 GLM-5.3(输入 8 元、输出 28 元)。
这种精细化的阶梯定价折射出智谱对于开发者生态与自身算力成本的清醒平衡。在商业计算领域,性能、延迟与成本从来是一个不可兼得的不可能三角。对于普通的日常轻问答或后台数据异步打标,低成本的原版 Flash 模型已完全够用;而对于涉及金融风控、医疗问答、即时代码调试等对延迟极度敏感的高价值核心链路,开发者显然愿意为 5 倍的提速支付溢价。
通过将算力供给区分为“常规经济型”与“极速生产型”,智谱实际上为企业构建了一个从低门槛试用到高质量付费转化的完整商业台阶。这一闭环也向行业传递了一个明确信号:大模型 API 的内卷正在告别无脑的价格战,转向“以单位时间产出价值”来定价格局的新阶段。
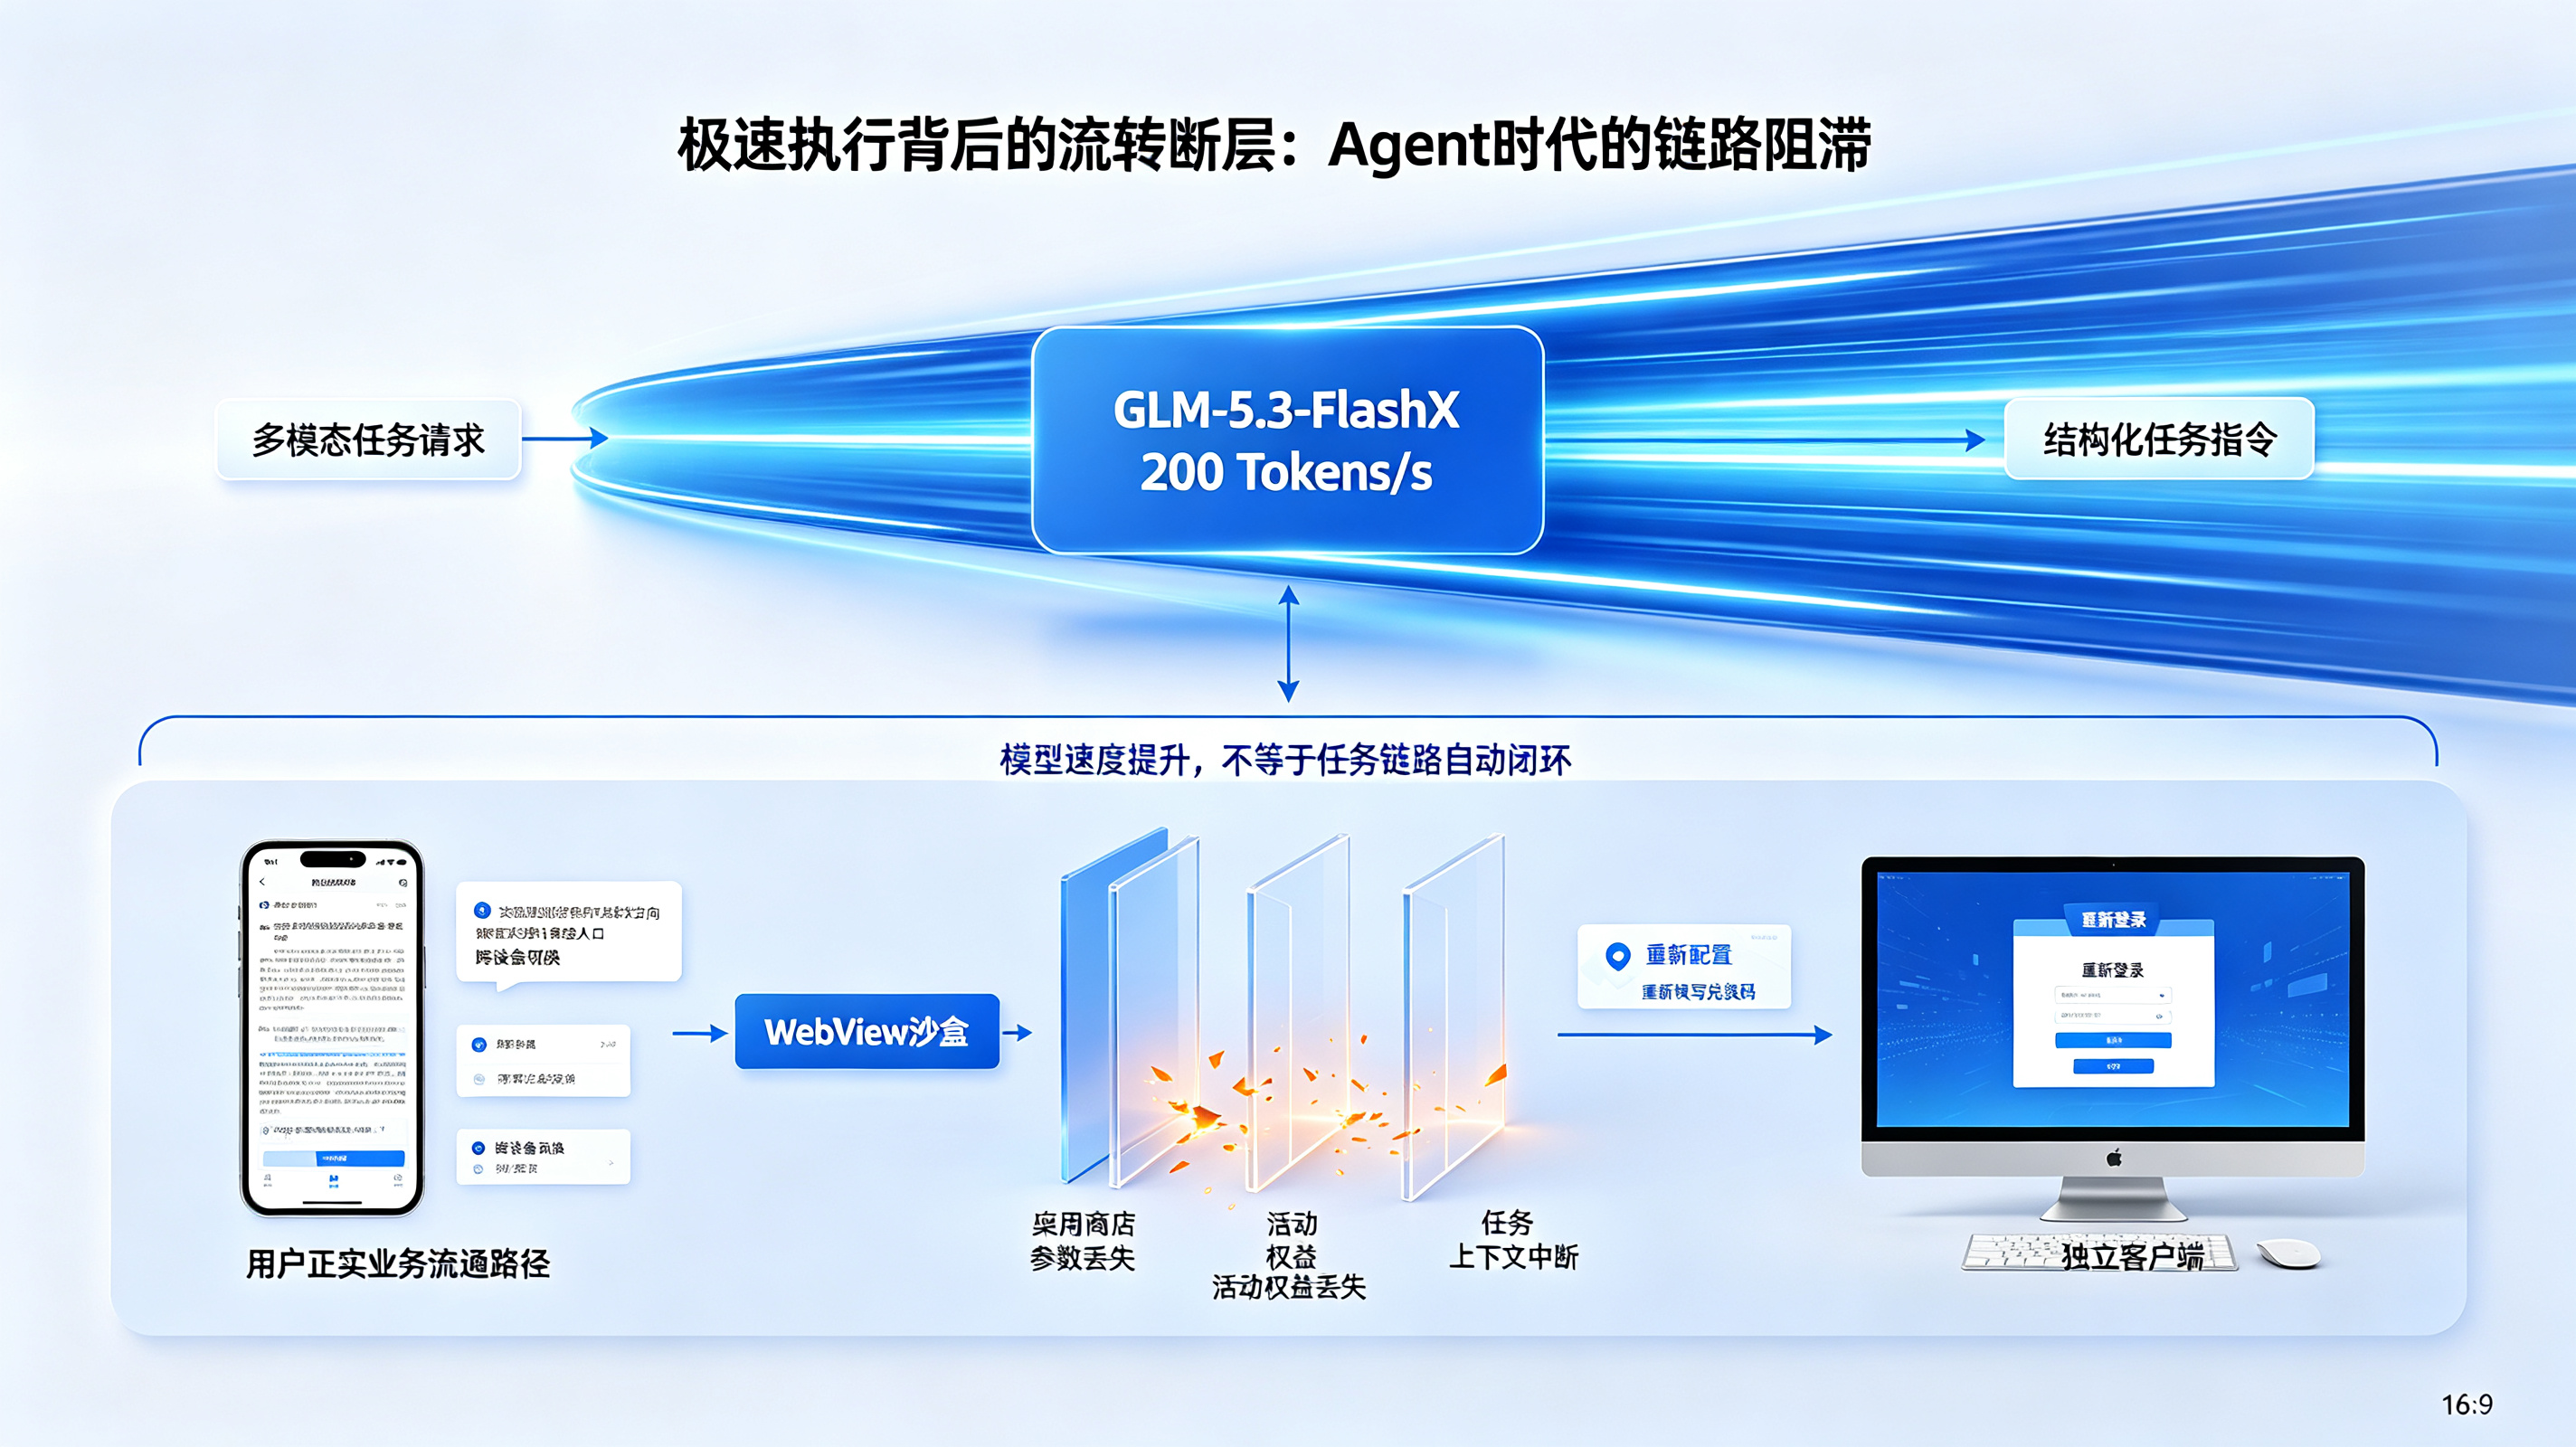
然而,当云端大模型的推理速度从 40 tokens/s 狂飙至 200 tokens/s,底层的算力瓶颈被大幅攻破后,应用层开发者却赫然发现:整个软件系统的整体交付效率,并没有如预期般水涨船高。相反,一个长期潜伏在多端交互与系统分发中的“流转黑洞”,在这个极速时代被无情放大。
让我们复盘一个在智能体加速普及背景下极其典型的端到端落地场景:某企业研发了一款面向泛科技爱好者的“AI 智能硬件评测协作体”。为了在激烈的流量争夺中获客,团队在各大数码科技资讯网站、专业极客论坛、海外视频社区投放了多篇详尽的模型实测评测,并在文末嵌入了带有特定激励标记的“新机专属试用体验包”推广短链。
一位正在通勤地铁上的工程师通过手机微信刷到了这篇评测,被其展示的秒级多模态分析能力深深打动,随即点击了体验链接。然而,在现有的移动互联网沙盒机制下,断层立刻接踵而至:用户首先被社交软件内置的 Webview 拦截,随后在跨应用跳转、系统应用商店重定向的层层阻隔下,最初推广链接中所绑定的“特定极客社群 ID”以及“前沿体验兑换码”在多次无状态跳转中被彻底洗去。
更具挫败感的体验发生在跨终端协同与任务接续环节。当这位工程师回到办公室,在配备了大屏幕的 PC 电脑前通过网页或独立客户端重新唤醒该应用,准备将手机上保存的高清硬件拆解视频喂给 GLM-5.3-FlashX 进行多模态分析时,PC 端由于无法感知其在移动端的任何历史行为与会话参数,冷冰冰地吐出了一个需要重新注册、重新绑定的初始界面。用户被迫停下工作流,翻开手机相册,重新在网页端寻找上传入口,甚至要手动寻找之前的活动兑换码进行繁琐填报。
在追求即刻反馈的技术人群中,这种机械而冗长的流转断点直接劝退了大量潜在核心用户。高达四成以上的潜在转化率,就在手机端与 PC 端、Web 容器与本地客户端的缝隙中被白白吞噬。对于开发团队而言,尽管后端采购了算力极其昂贵的极速模型,前台却依然陷入“砸钱推广不见响动、多端用户无法穿透、转化来源无从考证”的无解死局。
而在更深层的 Agent 任务执行流内部,危机同样隐蔽。当一个自动化流程需要跨越手机系统工具、移动端 App 与云端数据库时,如果缺乏任务级的参数连续性保障,极速模型在瞬间生成了结构化指令后,下游的 App 往往因为无法识别上下文或遭遇沙盒权限阻断而执行失败。模型算得再快,任务卡在端侧无法闭环,极速吞吐的优势瞬间荡然无存。
在 AI 基础设施全面提速、模型推理全面走向多模态与高并发的时代,应用开发者如果依然停留在“只管调用 API、不管端到端流转”的单机思维中,注定无法承接这一轮模型升级带来的生产力红利。面对跨设备、跨应用、跨进程的割裂生态,企业必须在操作系统沙盒与云端大模型之外,引入最专业的底层数据流动引擎,用极度锋利的工程手段打通应用分发与任务接续的高速公路。
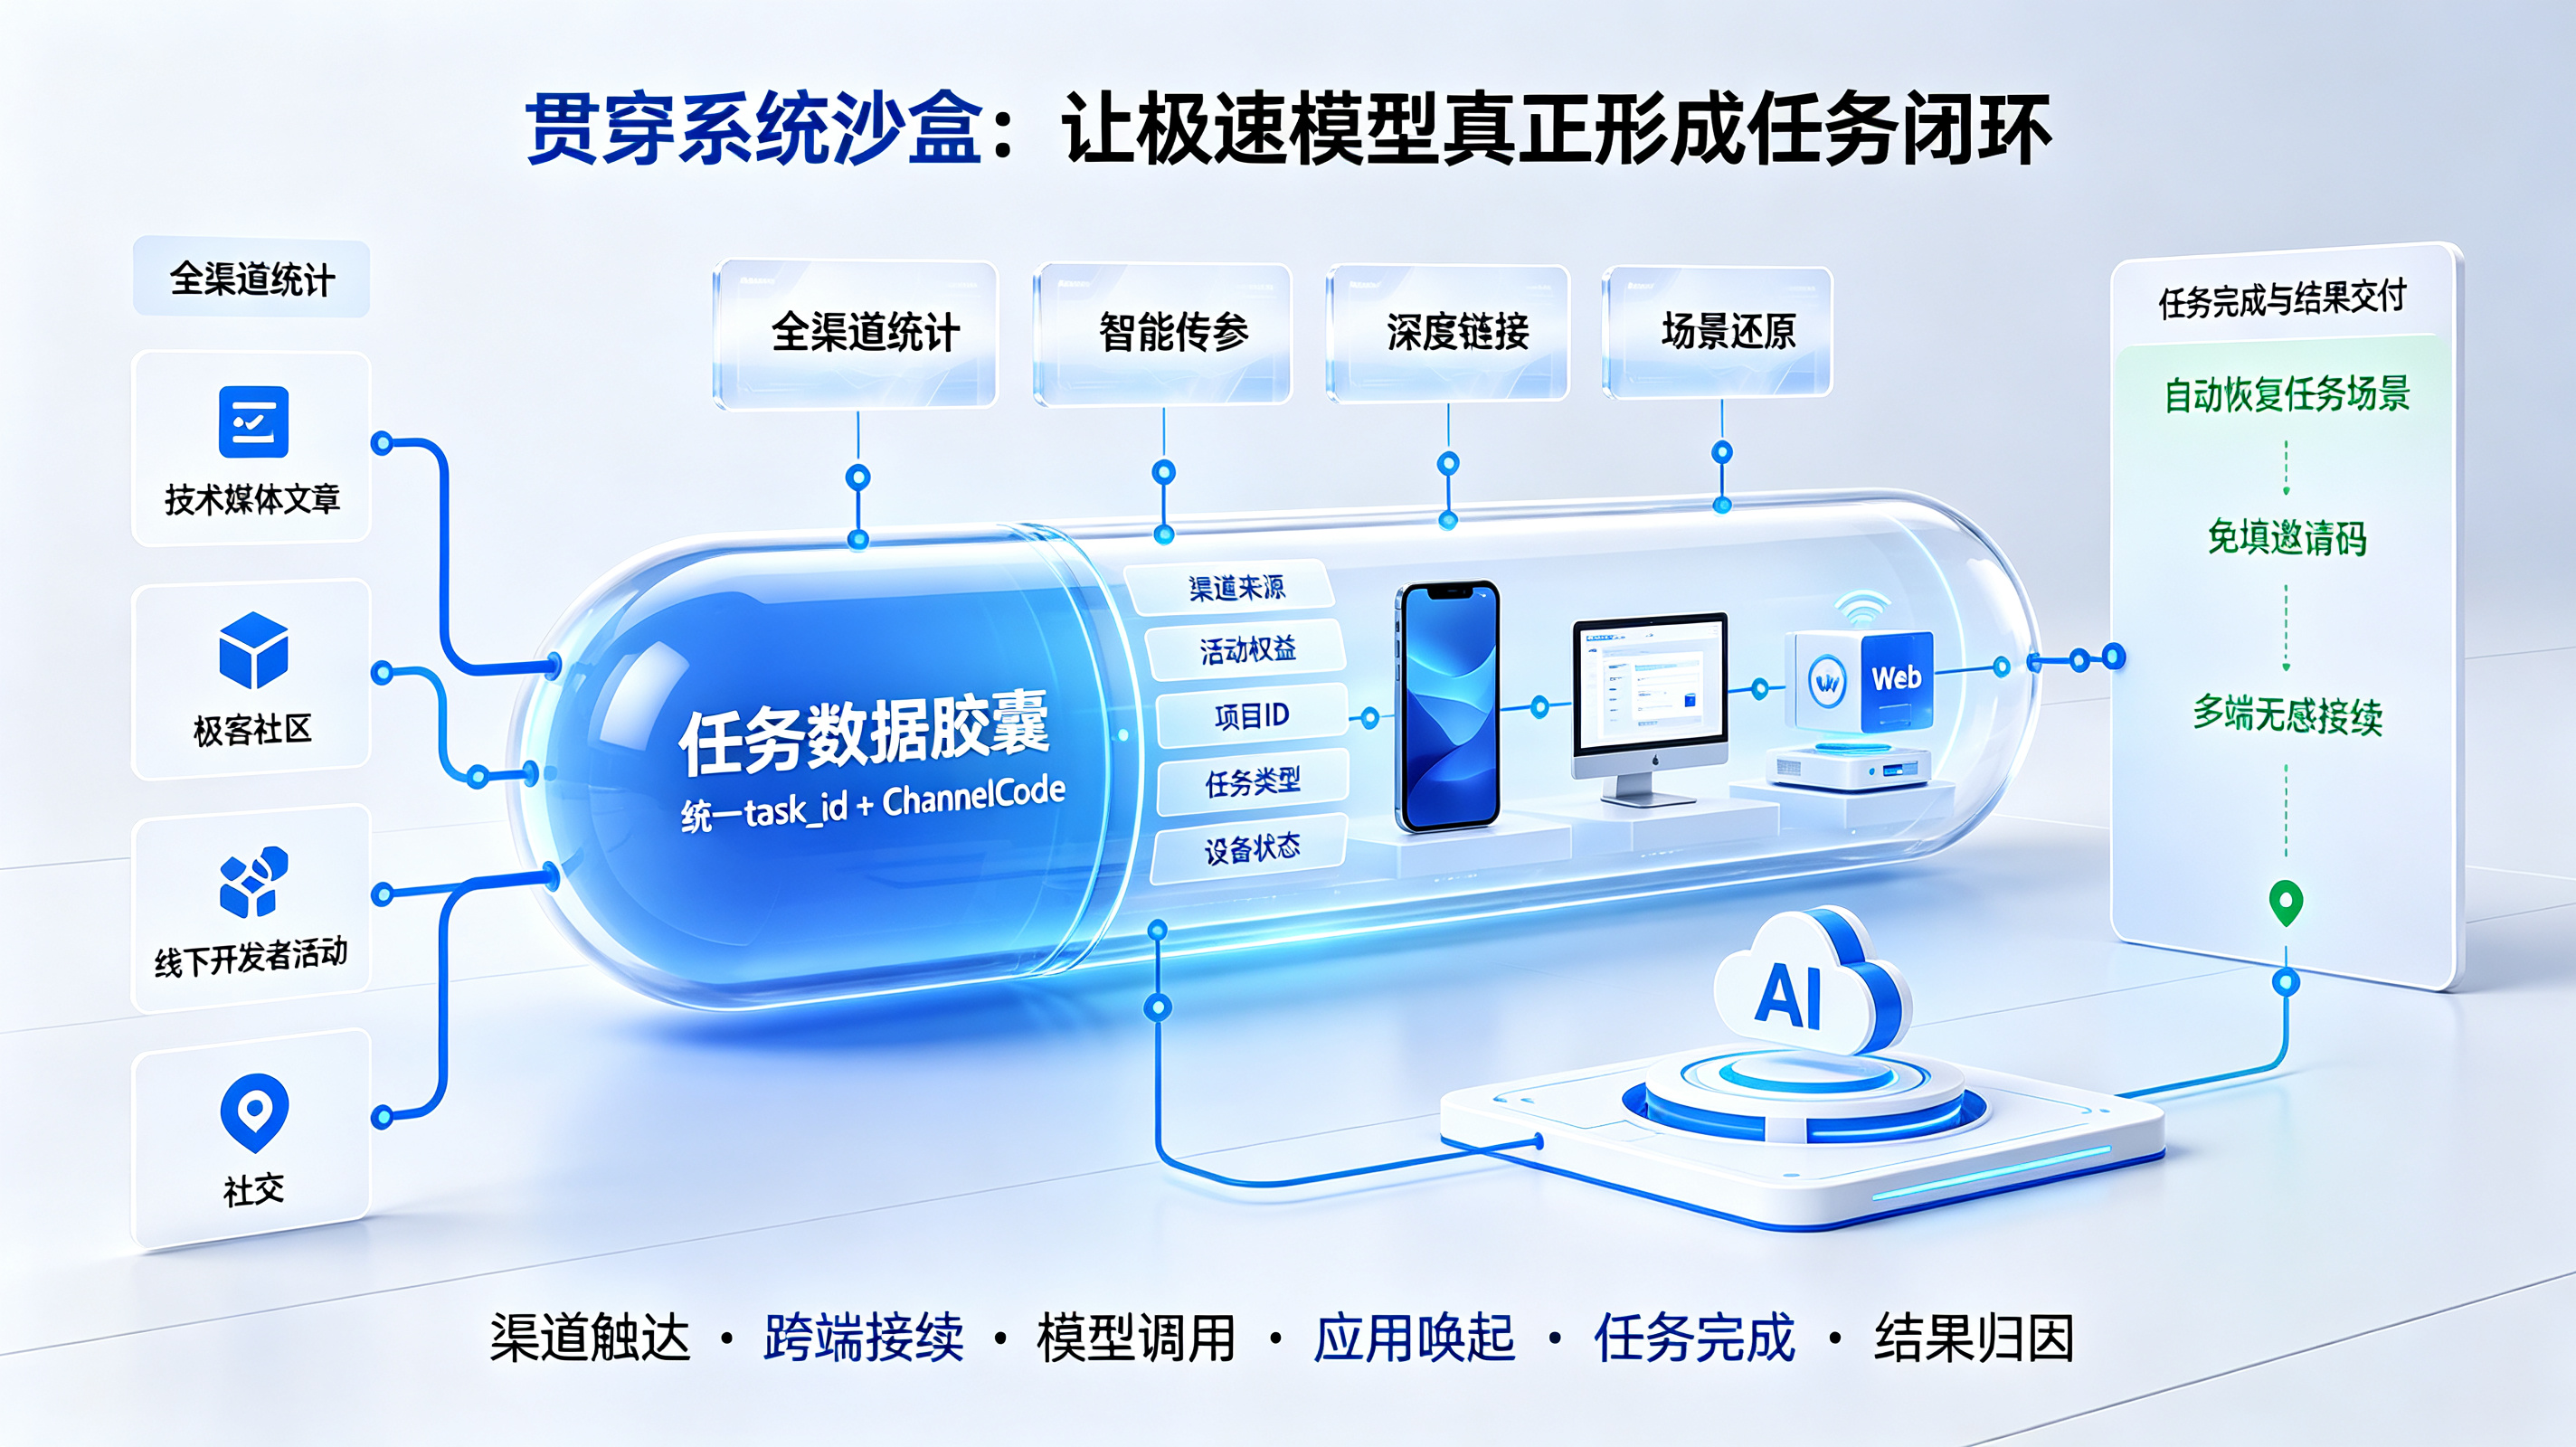
为了彻底摸清全渠道推广与模型调用的真实转化脉络,部署系统级的全渠道统计基建是开发者建立数据主权的核心前提。通过统一的 ChannelCode 编码逻辑,运营团队可以为每一篇专业媒体评测、每一个技术社区推广帖、乃至线下开发者沙龙的每一个签到二维码,生成完全独立且自带动态业务参数的专属短链。无需在错综复杂的异构系统中进行繁琐易碎的代码埋点,开发者就能在集成的监控看板上,以毫秒级的颗粒度俯瞰从移动端首次点击、扫码跳转,到客户端下载激活、高频 API 调用的全生命周期流转,赋予每一次营销投入以极度清晰的数据坐标。
而针对用户在移动端与桌面端跨屏流转时必然遭遇的体验断崖,系统级的智能传参引擎提供了如同无缝咬合般的接续方案。当潜在用户在移动端点击体验链接的瞬间,云端参数池便会安全暂存当前场景下的所有关键业务参数(如特定的任务类型、项目模板、活动渠道标识)。待用户移步至 PC 端或平板端首次启动该应用时,内置的轻量化 SDK 能够自动与云端完成握手并精准寻回这些参数。
此时,业务层可立刻触发极其丝滑的免填邀请码与权限自动兑付机制。系统在静默状态下自动识别该用户的来源归属,直接为其解锁对应的专属体验额度,并瞬间将界面定向至其此前在手机上选定的特定分析模式。这种彻底消灭了手动填码与二次搜索摩擦的体验,将新一代生产力软件的实际转化率推向全新高度。
不仅如此,面对未来 Agent 频繁跨应用派发任务的复杂协同,无缝的渠道代理与链接流转与底层场景还原技术更是击穿硬件孤岛的利刃。无论指令最初是在微信内置浏览器的一篇技术文档中被触发,还是在后方的自动化任务队列中被调度,该机制都能穿透系统沙盒的层层设防,毫秒级唤醒目标客户端,并精准定位至特定的任务处理窗口或多模态配置面板。对相关底层集成机制感兴趣的架构师,也可以参考 Xinstall 开发者服务平台或访问 Xinstall 官方平台深入了解其如何通过统一的数据总线,让原本孤立的数据碎片重新串联成高价值的转化长链。
面对智谱推出 GLM-5.3-FlashX 所掀起的推理提速浪潮,身处一线的技术研发与业务增长团队必须协同动作,打破过去的职责边界,共同迎接任务流主导的新周期。
task_id,并与客户端底层的 channel_code、设备上下文及用户鉴权信息紧密绑定。确保不论任务在云端经历多少层 Agent 递归拆解,其来源归属与最终交付目标始终清晰可溯。最核心的差异在于推理速度与工程吞吐。GLM-5.3-FlashX 在保持 1M 上下文与图片、视频、文本全模态理解能力不缩水的前提下,通过底层算力集群的工程重构,将推理速度最高提升至 200 tokens/s,较原版提速 5 倍。它专门针对长任务流水线、多 Agent 协同和即时人机交互等对时延要求极高的生产场景而设计。
因为大模型的提速只解决了“大脑思考并输出结果”的效率,而真实用户的数字生活是切割在不同操作系统、不同设备以及各类封闭 App 沙盒之中的。当用户在不同终端之间切换、或者从外部推广链接跳转至原生应用时,原始的渠道参数、身份信息与任务上下文极易在重定向中丢失,繁琐的二次登录和参数重填破坏了体验连贯性,从而导致转化断崖。
专业的智能传参技术通过云端动态匹配与轻量级客户端 SDK 协同,在用户点击外部链接或发起跨端调度的毫秒级瞬间,将当前场景携带的业务参数安全保存在云端。当目标应用在另一终端或从后台被重新拉起时,SDK 会静默检索并对齐这些参数,驱动应用直接跳转并恢复至特定的任务窗口,彻底省去手动配置过程,与大模型的高速响应形成合力。
回顾整个大语言模型的技术进化图谱,如果说过去两年行业的竞争重心在于参数规模的盲目狂飙与通用基准的单项争夺,那么如今的市场已经无可逆转地步入了“以工业效能与商业落地为尺”的新纪元。智谱推出GLM-5.3-FlashX,不仅展示了国产算力集群在精细化工程重构下的巨大潜力,更宣告了大模型基础设施正在从昂贵、迟缓的探索性工具,全面蜕变为主力级的即时计算引擎。
在这场由高吞吐算力驱动的生产力革命中,应用层团队必须清醒地意识到:底座模型的速度飞跃,绝不等于终端体验的自然闭环。当用户的交互习惯从被动点击界面转向主动交代复杂任务,当海量的数据流转在碎片化的跨屏终端之间高频穿梭,谁能以最低的损耗缝合系统沙盒之间的数据断层,谁能以最高的精度还原用户在每一个场景下的真实诉求,谁才能真正将底层的计算红利沉淀为难以撼动的商业壁垒。随着极速推理时代的到来,属于深度场景还原与全链路任务追踪的新战役,已然吹响了冲锋的号角。
 上一篇

KOL 带货怎么追踪 CPS?渠道统计 KOL 带货归因
2026-09-18
阿里发布Qwen3.8-Omni-Flash?全模态大模型重构音视频分发入口
2026-09-18
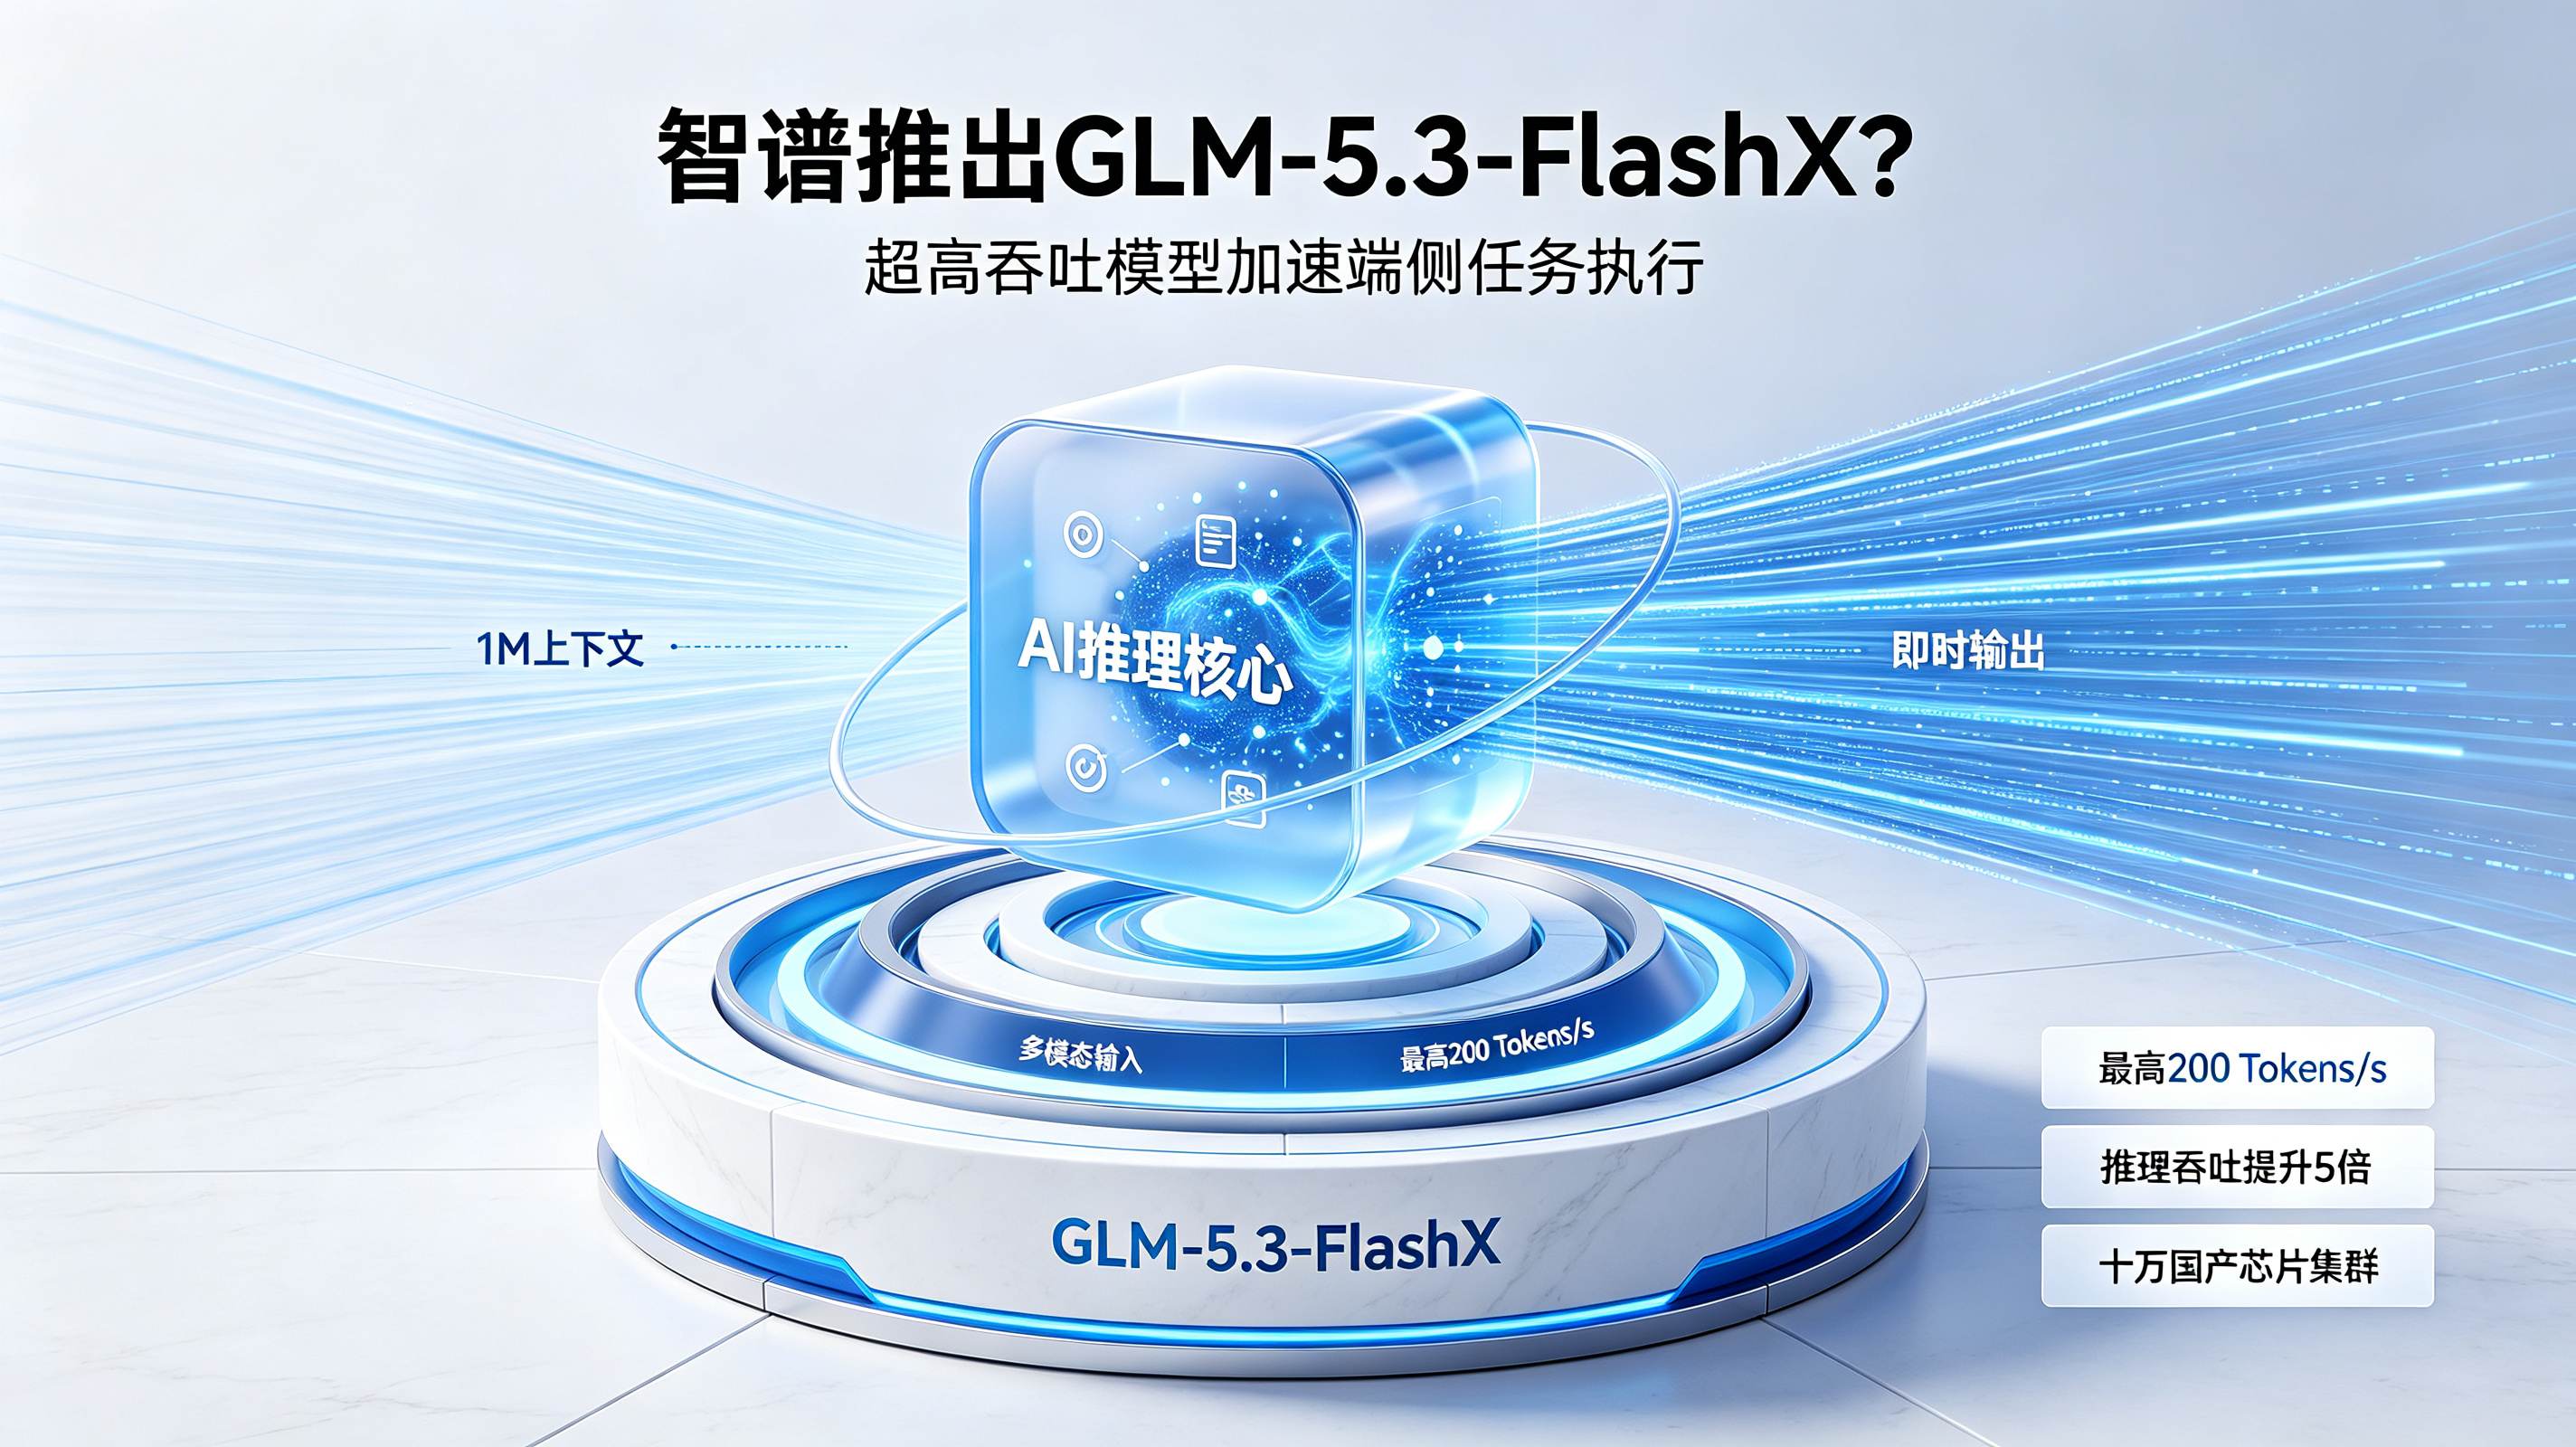
智谱推出GLM-5.3-FlashX?超高吞吐模型加速端侧任务执行
2026-09-18
代理分销怎么分佣结算?渠道统计代理分佣实战
2026-09-17
地推业绩怎么统计最准?渠道统计地推业绩方案
2026-09-17
豆包手机明日开卖?AI到底能不能替用户操作App
2026-09-17
OpenAI发布模型失调框架?AI Agent开始接受系统化安全审查
2026-09-17
异常渠道怎么快速识别?渠道统计异常识别策略
2026-09-16
渠道分组管理有什么技巧?渠道统计分组管理指南
2026-09-16
渠道链接怎么一键生成?渠道统计链接生成实战
2026-09-16
vivo发布BlueCode?手机编程智能体走向端侧生产力
2026-09-16
问界合作模式调整?赛力斯主导全链条、华为继续赋能
2026-09-16
营销术语 CPA、CPS、CPL 有什么区别?归因场景对比
2026-09-15
AI脑机接口标准发布?脑电数据进入全流程质量管理
2026-09-15
云知声发布U2-Flash?高密度模型加速Agent应用落地
2026-09-15