手机微信扫一扫联系客服
联系电话:18046269997


 APP安装免填邀请码
 社交分享效果统计
 广告投放数据统计
 CPA/CPS推广效果统计
 App地推统计
 App拉起
 网页/应用内直接安装
 Android多渠道打包
 App安装后自动绑定
 App分享效果统计
 Deeplink深度链接
手机微信扫一扫联系客服
 Xinstall 分类:增长攻略 时间:2026-08-19 11:20:49
 354

针对渠道转化数据怎么看的痛点,本文深度拆解渠道统计底层的流式事件日志采集机制与跨域对账逻辑。详解如何基于归因平台搭建 AARRR 漏斗模型与 ROI 评估看板,提供硬核的数据排障指南。
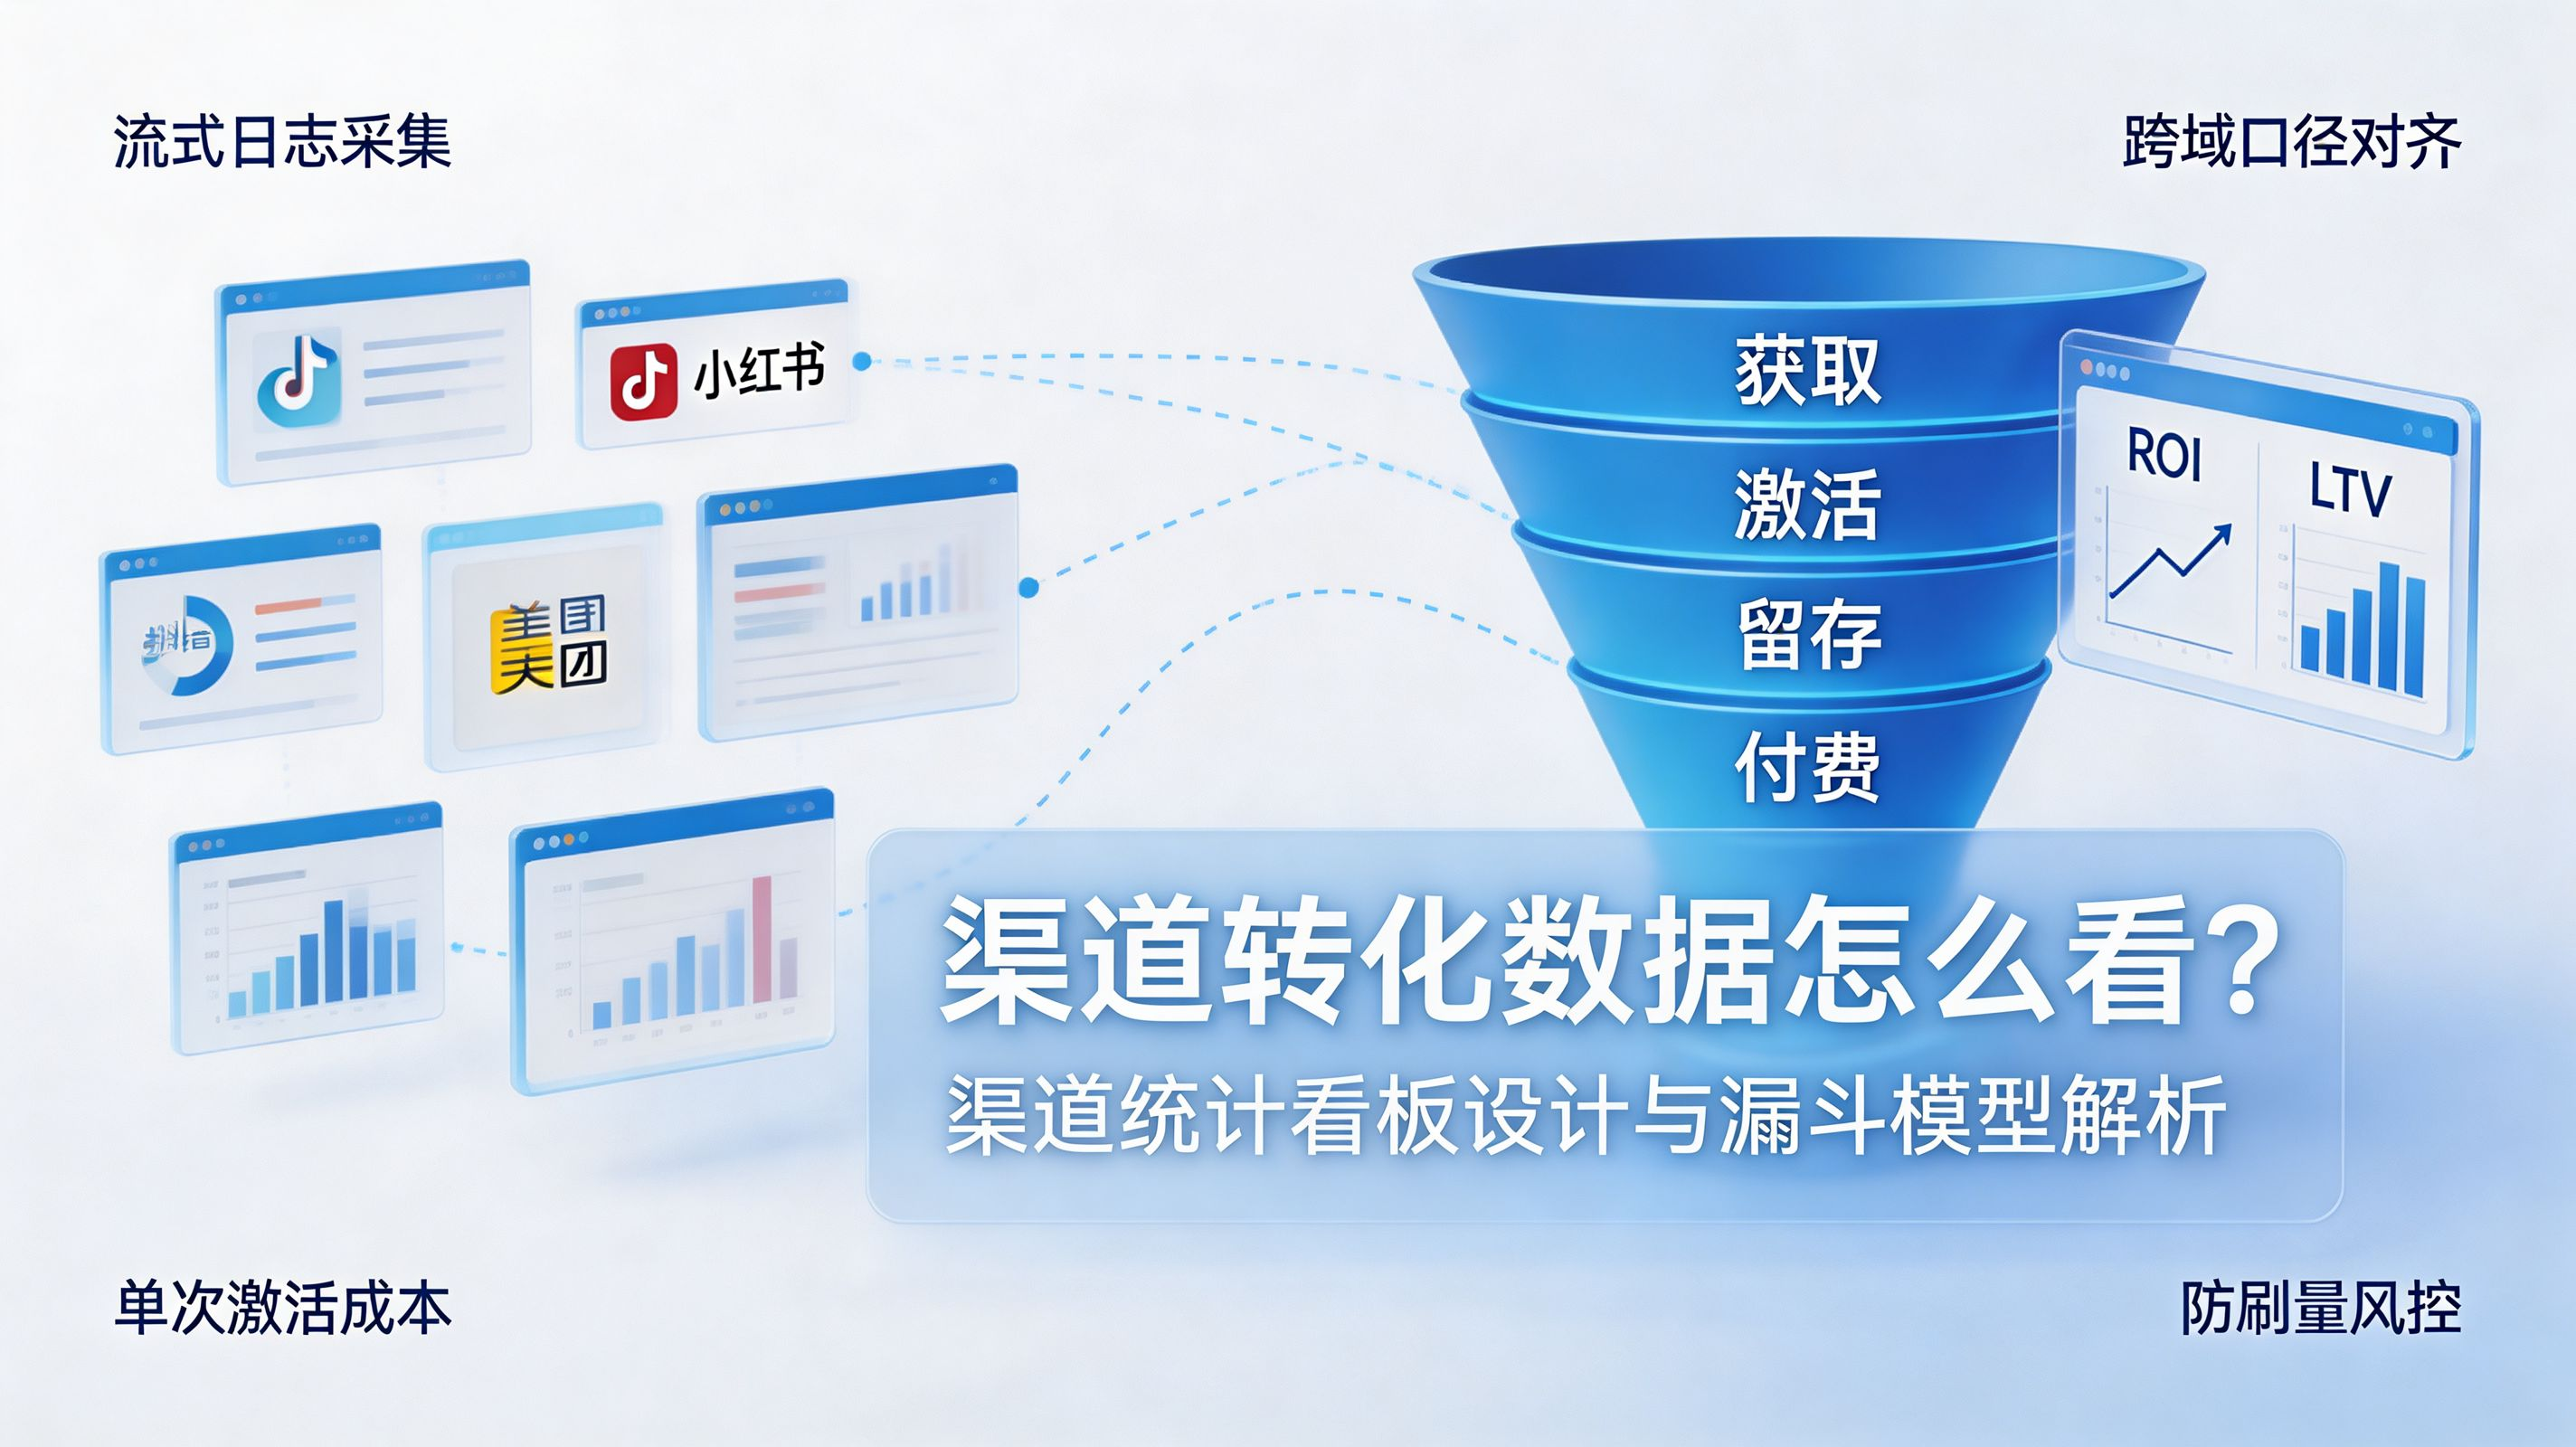
渠道转化数据怎么看?在移动增长和 App 开发领域,行业里越来越把一套能够实时下钻的渠道统计看板视为鉴别获客质量、粉碎虚假流量与量化 ROI(投资回报率)的终极“照妖镜”。当一款 App 在抖音、快手、广点通、应用商店甚至是线下地推同步开启铺天盖地的买量狂欢时,运营与数据团队面对的往往是各渠道后台割裂且自相矛盾的数据孤岛。A 渠道的报表宣称点击量突破百万,B 渠道自诩激活转化率高达 80%,然而一旦拉通后端的内部真实交易数据库进行财务对账,真实的日活增量与营收数据往往一塌糊涂。这种表象繁荣与底层坍塌的矛盾,源于缺乏一套标准化的漏斗评估体系。本文将以资深数据架构师的视角,彻底扒开漏斗模型的口径对齐逻辑,详解跨域对账中的技术架构难点,为您搭建一套基于科学渠道统计的转化评估体系与硬核排障指南。
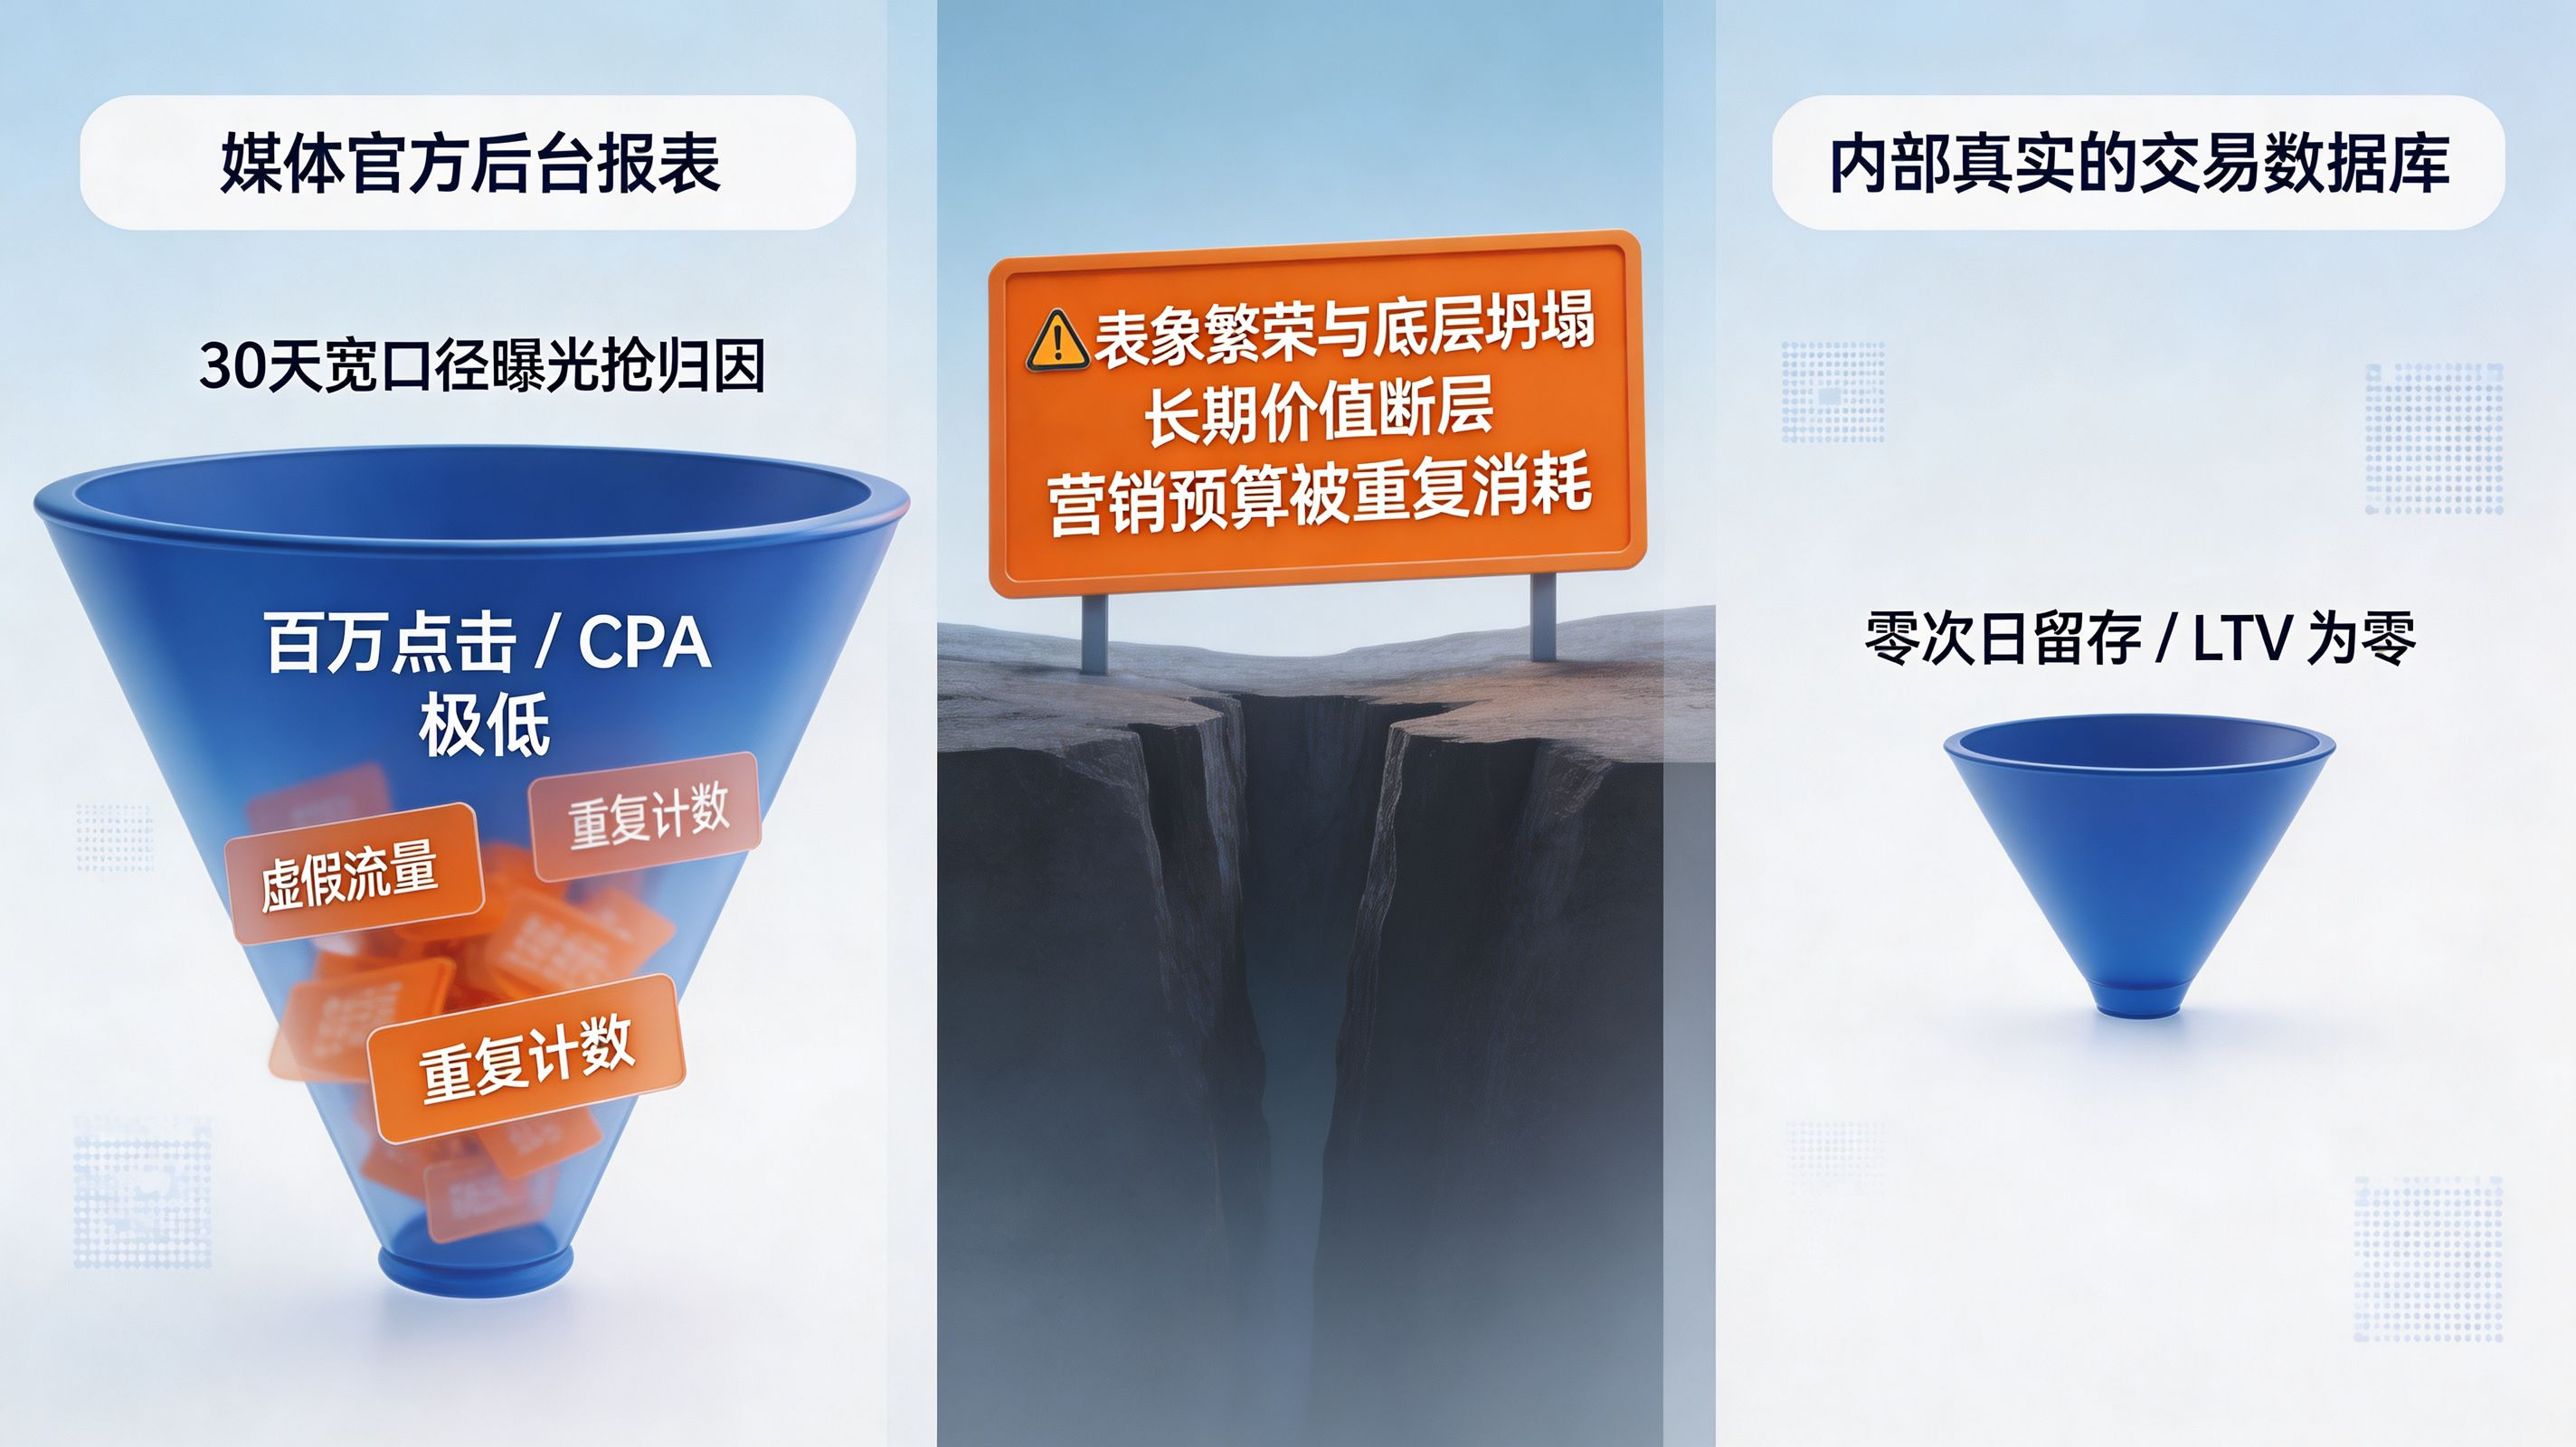
在商业化投放的深水区,首当其冲的致命痛点是数据孤岛与“自说自话”的媒体报表机制。几乎所有的超级媒体平台,为了证明自身流量的优越性从而获取更多广告预算,在其自带的统计后台中往往会采用一种极度“宽容且贪婪”的归因时间窗逻辑。例如,只要用户在过去 30 天内仅仅是因为手滑瞥过一眼该平台的广告素材,无论最终他是通过哪个具体的应用商店自主搜索下载的,该媒体都会强行把这次激活的功劳霸占在自己的报表中。如果企业仅仅依赖这些各立山头、相互重复计数的媒体报表来做决策,就会陷入营销预算被严重重复消耗却浑然不知的盲区。
其次,长决策周期的转化断层是摧毁传统浅层数据看板的核心元凶。用户的转化旅程绝非一个瞬时的动作,从在信息流中“点击广告”,到连接 Wi-Fi “下载完 1GB 的超大游戏包体”,再到历经数天的深度体验后完成“首次充值”,这其中存在着长达数天甚至数周的物理时间差。传统的统计报表大多是静态切片的,缺乏基于设备级动态回溯的流式更新能力。这就导致那些在安装后第三天才发生的高净值转化行为,无法被精准挂载回其最初下载那天的渠道花费上,致使那些虽然获客单价较高但长效转化极佳的优质渠道,因为短期数据的“难看”而被优化师误杀关停。
最后,盲目追求虚荣指标而与 LTV(用户生命周期总价值)脱节,是绝大多数增长团队走向覆灭的缩影。很多初级运营人员盯着看板上极其低廉的“单次激活成本(CPA)”沾沾自喜,却完全忽视了“次日留存率”、“核心功能完成深度”以及“付费转化漏斗”等深层行为指标的断层。这种认知漏洞极易被潜伏在暗处的黑产或机刷羊毛党利用。他们通过廉价设备农场伪造海量激活,吃空了企业的拉新预算,留下的却是一个次留率为零、永远不会产生任何后续商业价值的数据废墟。
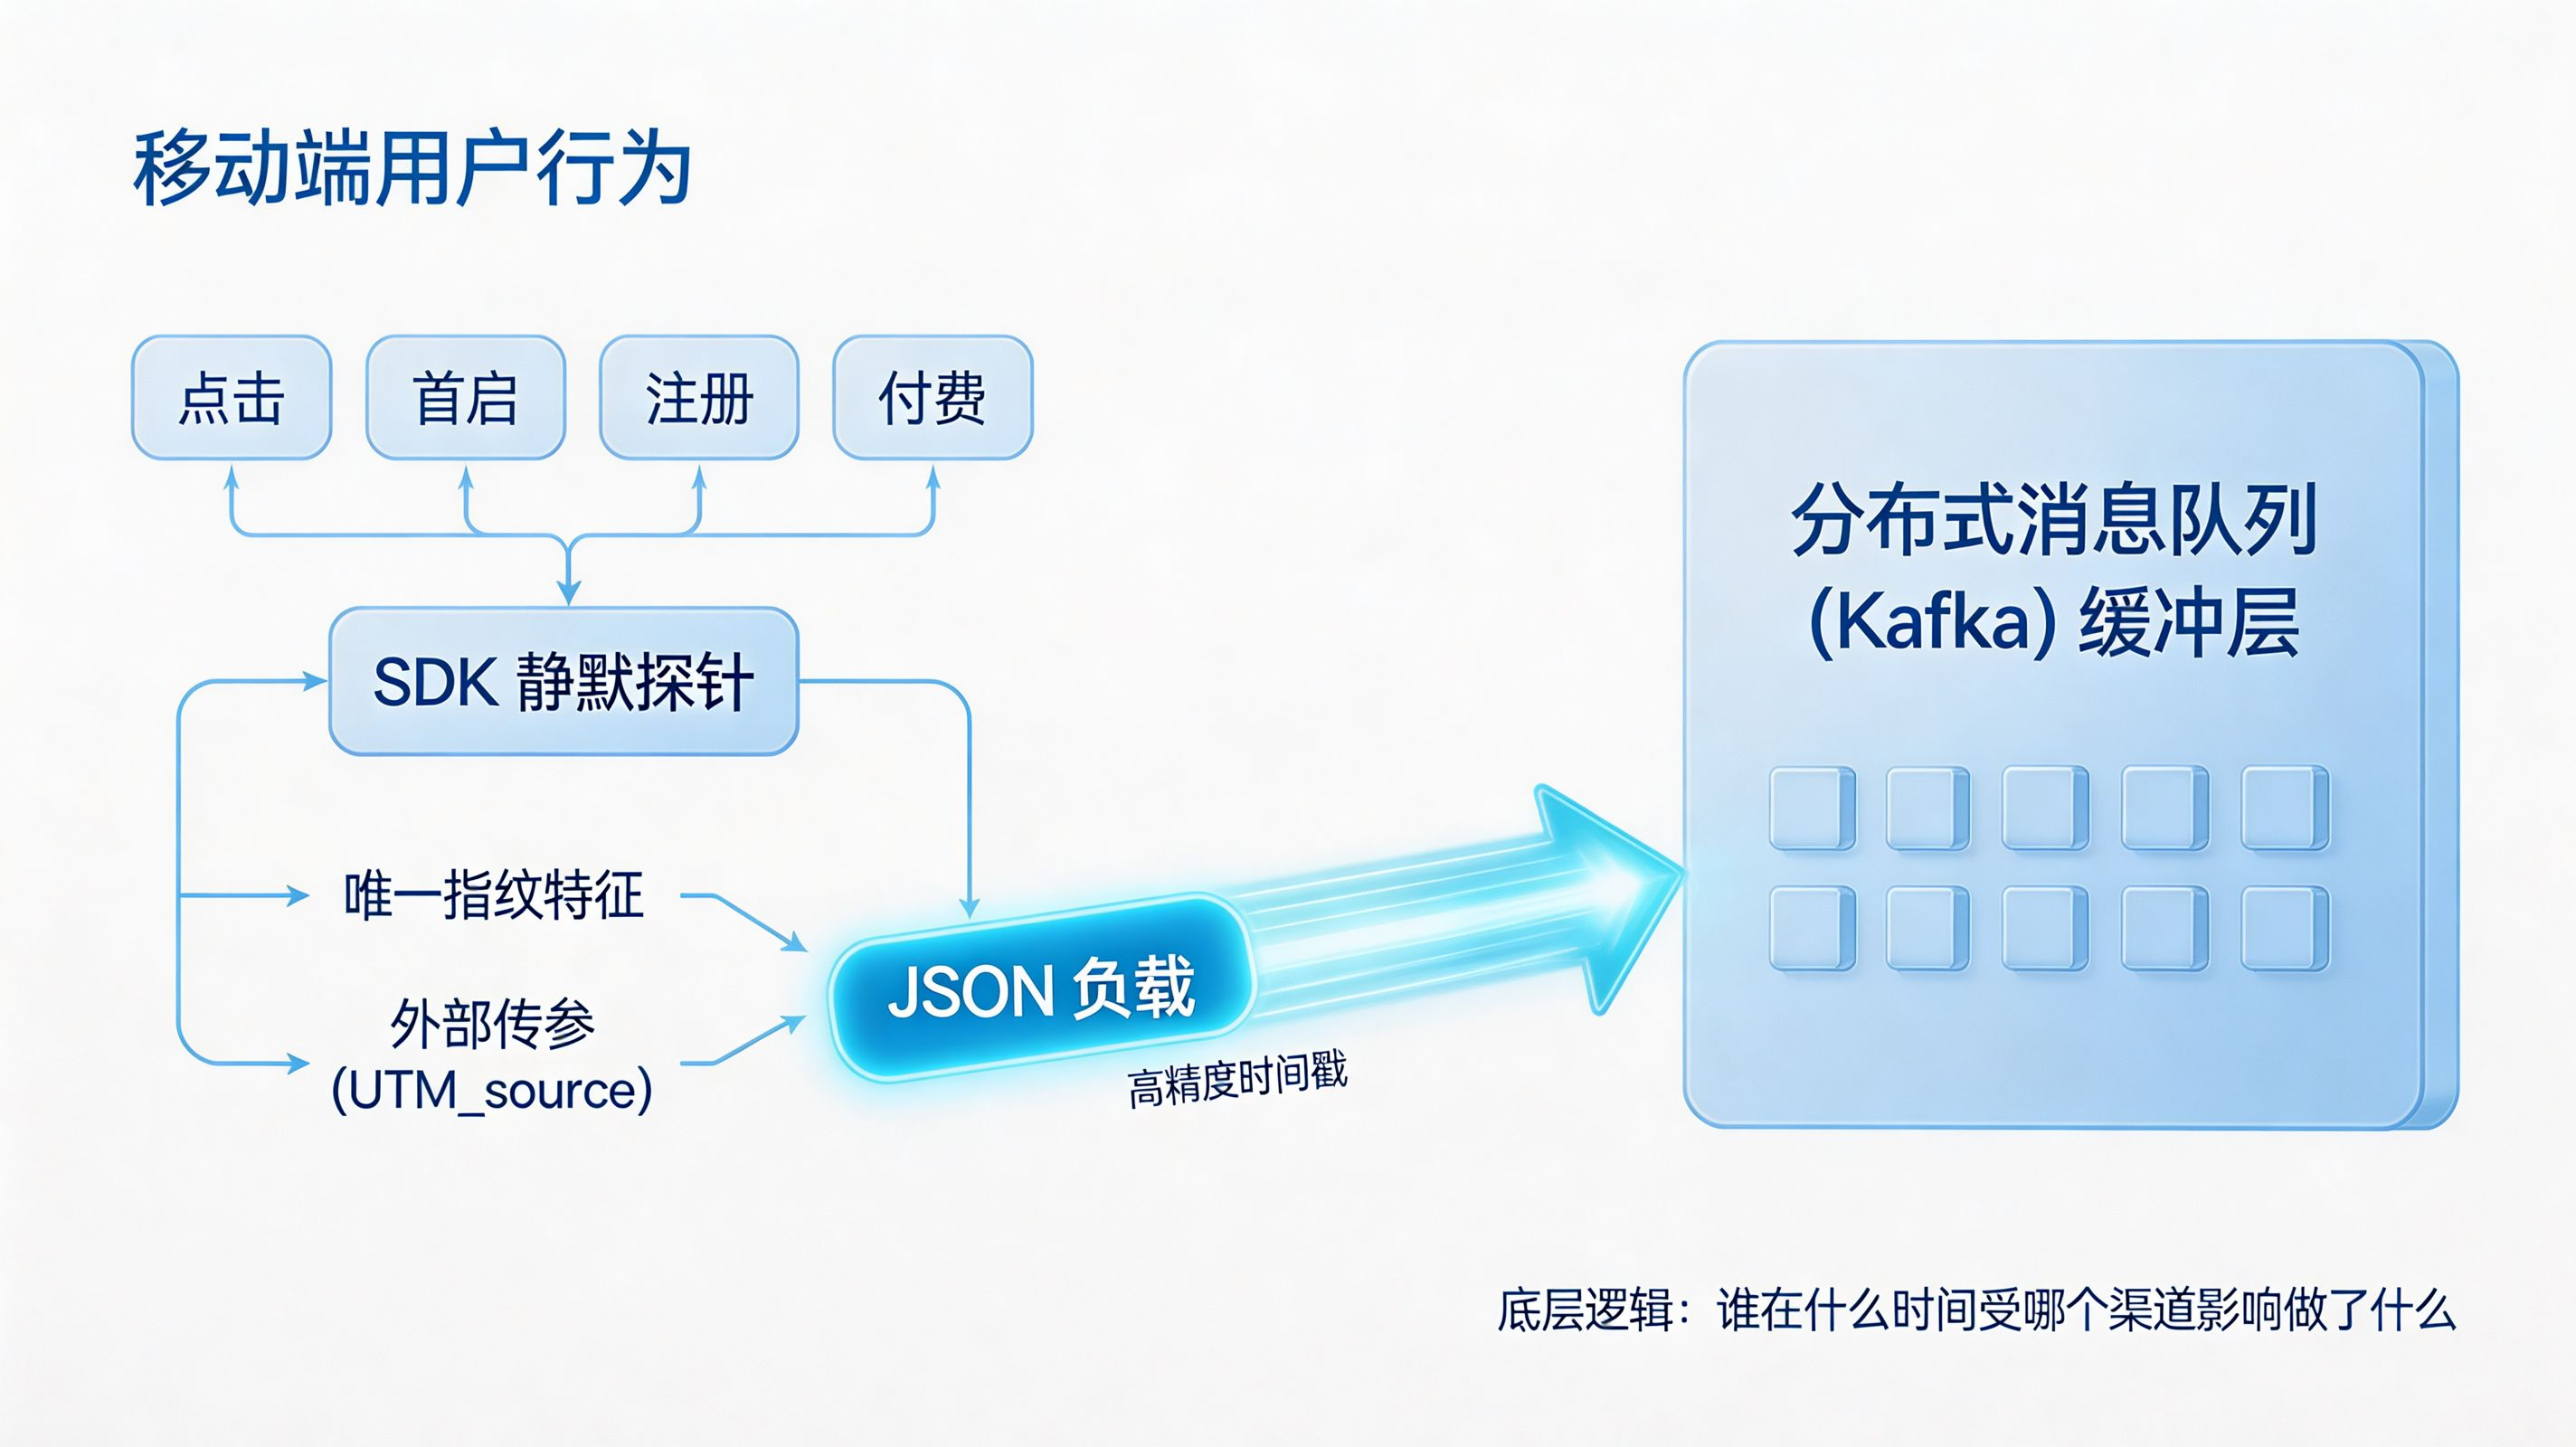
要构建一座坚不可摧的数据看板,其背后的物理骨架必须是基于客户端埋点 SDK 与 Server-to-Server (S2S) 严密结合的流式采集管线。当用户在设备端触发任何一个关键行为(如:落地页点击、首次冷启动激活、填写手机号注册、加入购物车)时,底层架构会立即启动拦截机制。SDK 会在毫秒级内静默提取当前设备的唯一指纹特征组合,并将其与内存中解析到的外部传参(如 UTM_source、Campaign_ID 等追踪标签)紧密捆绑,封装成一个带有高精度系统时间戳的 JSON 负载。随后,这个结构化的日志包会被迅速打入后端的 Kafka 高吞吐分布式消息队列中缓冲,等待流计算引擎的消费。这一过程是确保所有后续多维分析能够溯源至“谁在什么时间受哪个渠道影响做了什么”的绝对基石。(具体代码实现逻辑见文末部分 B)
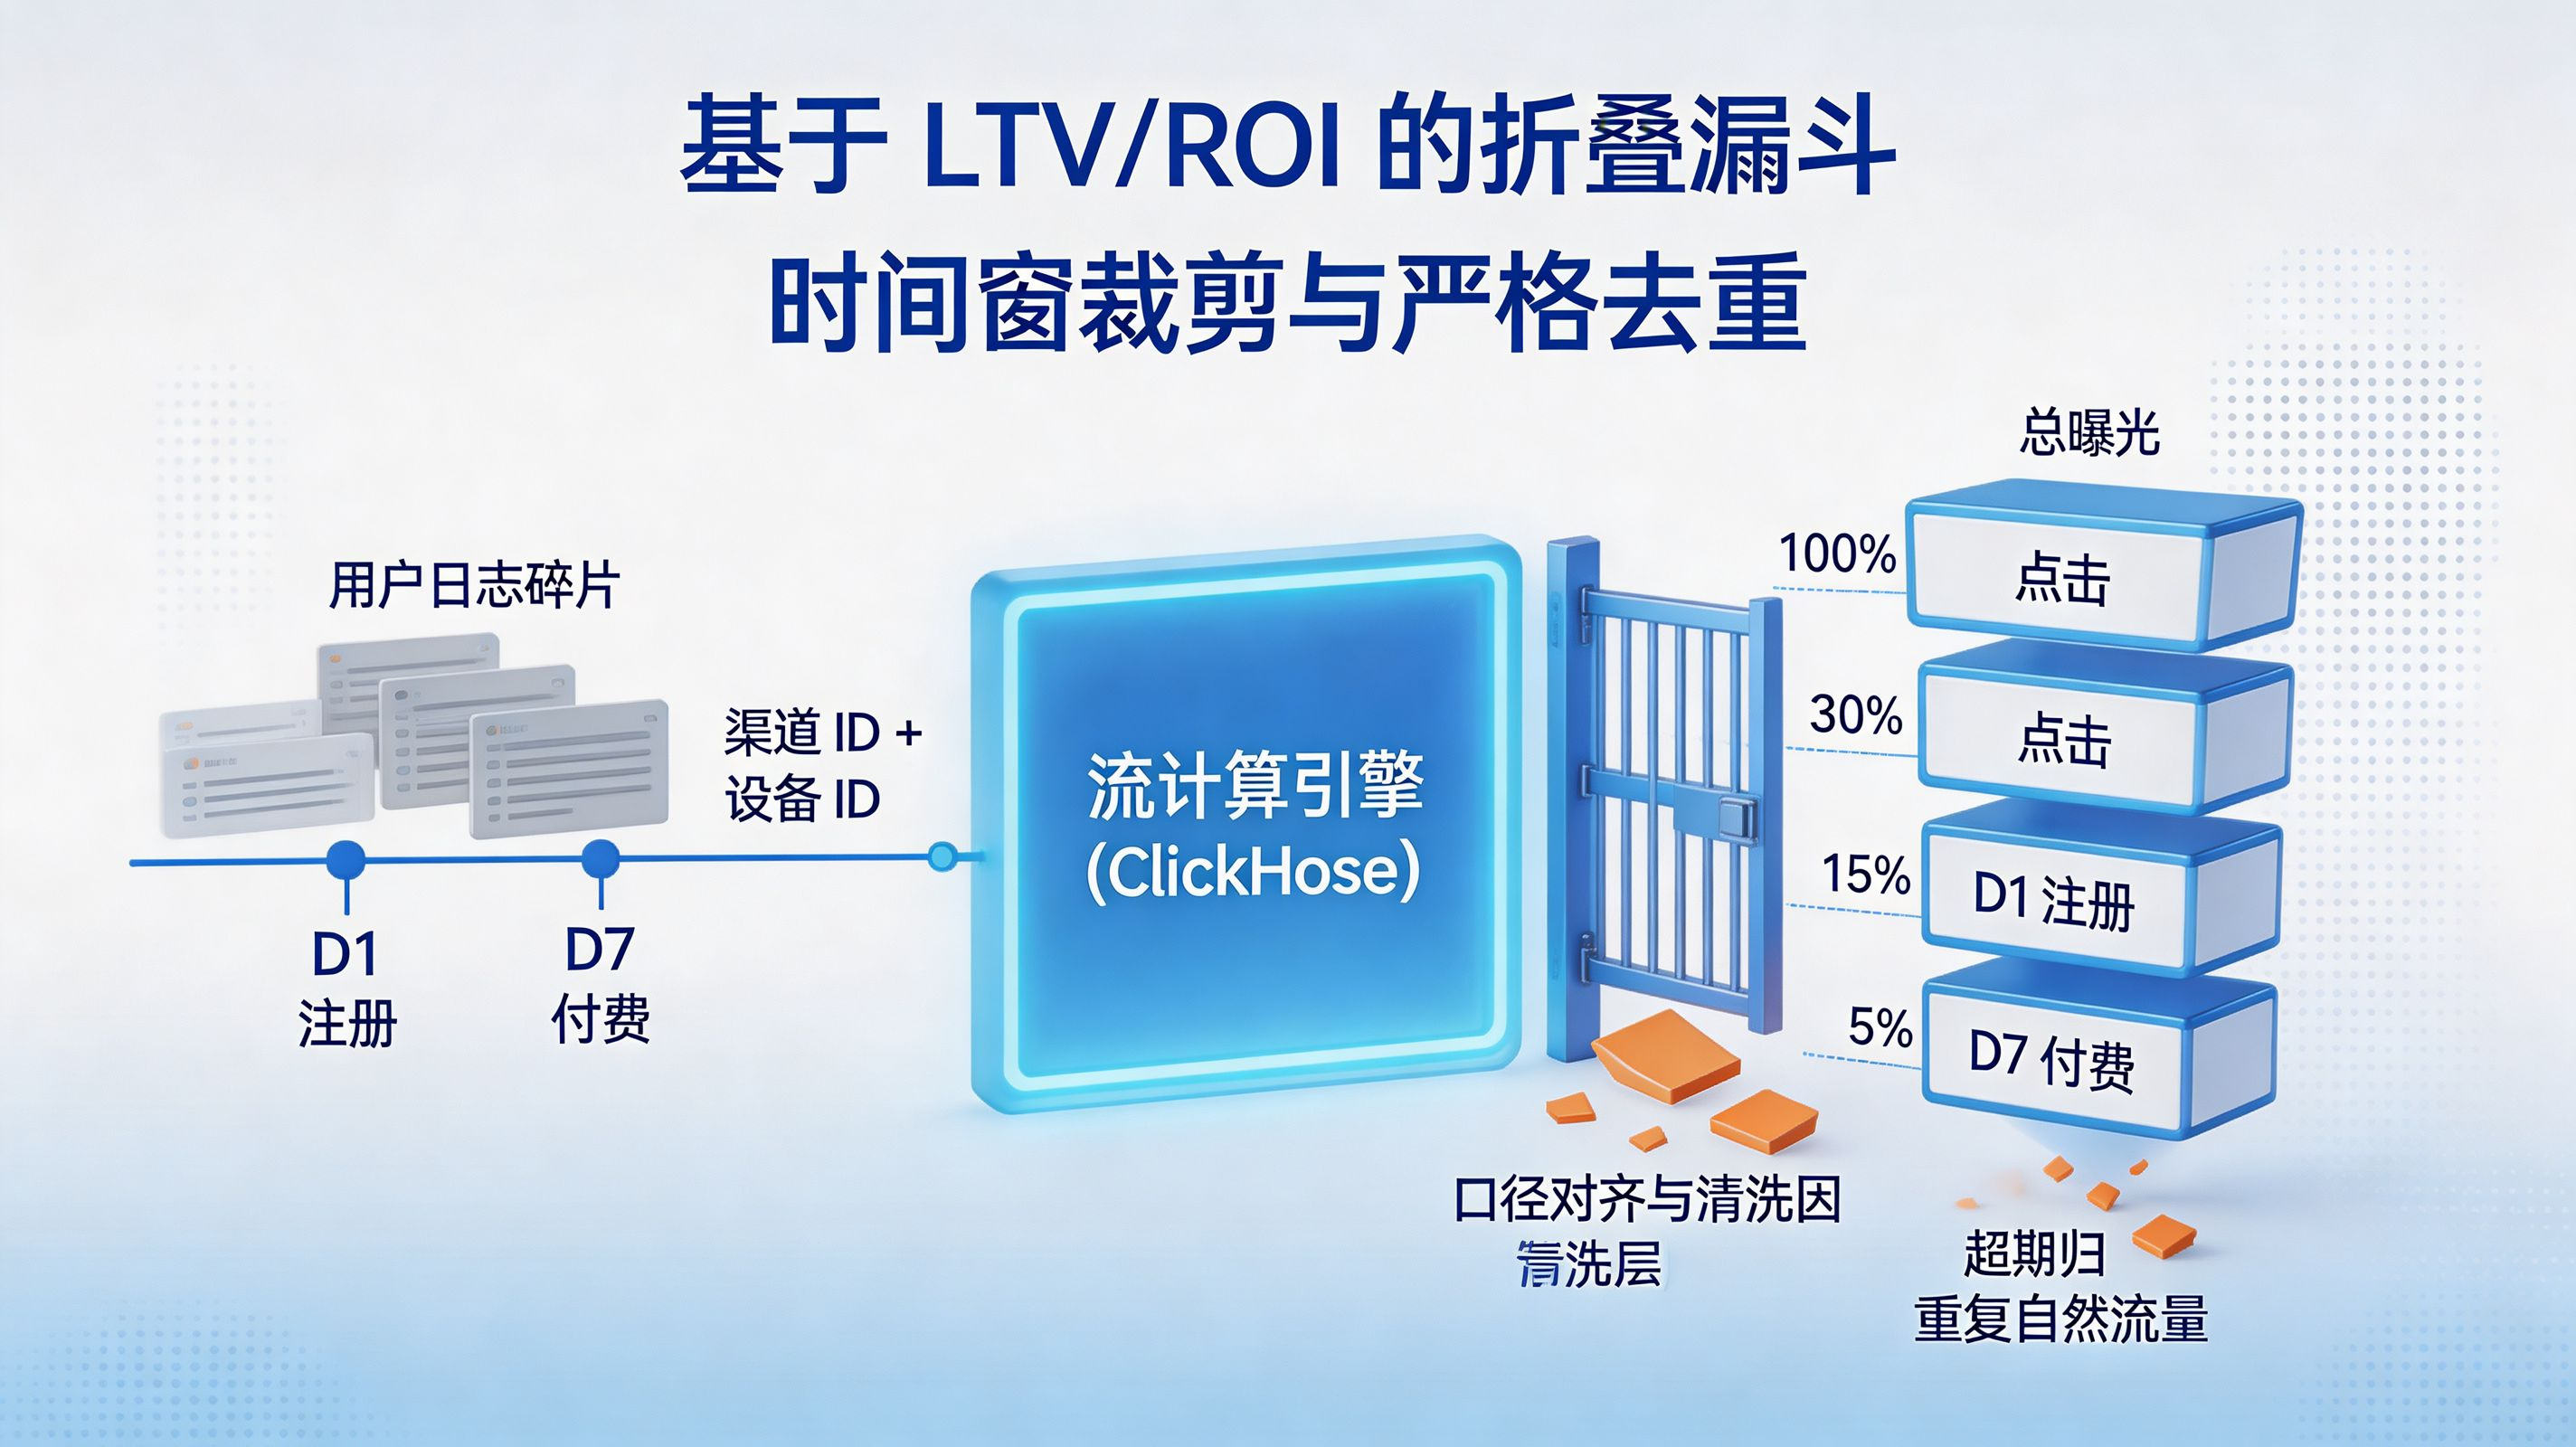
采集上来的海量无序日志只是数据原石,将其转化为看板上直观漏斗的核心算力在于 AARRR(海盗模型:获取、激活、留存、变现、传播)的多维折叠算法。在底层的大数据计算集群(如 ClickHouse 或 Flink)中,系统会以“确定的渠道 ID + 脱敏的唯一设备 ID”作为联合复合主键,对时间轴上碎片化的事件流进行聚合回溯。例如,计算引擎会搜寻所有在 D1 发生了“注册”行为的用户集合,再从这些集合中向后扫描在 D7 发生了“付费”事件的数据交集。通过这种基于状态机的多维关联与空间折叠,原本跨越多天、极其分散的单点动作,被精准剥离出分子与分母的关系,最终在看板上渲染出“100 个某渠道点击 -> 30 个激活 -> 10 个注册 -> 1 个付费”的严密转化率瀑布流。
当渠道数据准备汇入内部 BI 财务大盘时,数据清洗层(ETL)必须执行极其残酷的口径对齐与裁切逻辑,这是解决跨域对账矛盾的核心机密。由于第三方媒体、外部归因链路与内部核心交易数据库的采样规则永远存在物理时差,系统必须强制实施“时间窗裁剪(Time Window Clipping)”与“严格事件去重(De-duplication)”双重过滤协议。架构侧会依据最高优先级的内部业务系统产生的交易主键流水为唯一的 SSOT(Single Source of Truth,唯一事实来源)。如果某渠道宣称带来了 50 笔订单,但内部订单库基于时间窗比对后发现其中 5 笔超出了 7 天的归因追溯期,另有 3 笔是被其他自然流量抢占的重复记录,对账算法就会毫不留情地将其剃除,确保在最终交付给老板的渠道 ROI 报表上,每一分钱的产出都有无可辩驳的物理凭证支撑。
为了在极度混乱的报表大盘中抽丝剥茧,数据团队必须建立一套基于严格 SQL 口径映射的指标体系矩阵。这不仅仅是告诉运营应该看什么数字,更是要在底层代码逻辑上明确这些数字的来源基准与防刷量风控阈值。以下矩阵详细拆解了渠道转化漏斗核心指标的技术定义与业务预警逻辑,它是企业构建防弹级统计看板的重要评估标尺:
| 指标维度 / 漏斗节点 | 计算公式与底层口径 (SQL 逻辑侧) | 核心业务价值判断 | 异常数据排障特征 (作弊预警) |
|---|---|---|---|
| 点击到激活率 (CVR1) | 归因成功的首次冷启动设备数 / 唯一排重点击数 | 评估广告素材诱惑力、落地页连通性与跨端链路的唤醒损耗 | 激活率惊人地 > 90% 且毫秒级内完成(疑似接口重放或参数劫持) |
| 激活注册率 (CVR2) | (激活当天内完成 Registration 核心事件的 ID 数) / 激活数 | 严苛量化 App 新手引导流程(Onboarding)及权限索取环节的顺畅度 | 注册率不足 2% 且设备特征库高度重合单一(极大概率为设备农场死粉) |
| 次日留存率 (D1-Ret) | (激活次日产生至少一次 App Session 的排重设备数) / 激活数 | 检验各渠道获客质量的最快风向标,第一时间粉碎低质羊毛党的假象 | 次留率呈直线断崖式暴跌至趋近于零(渠道流量画像完全偏离业务预期) |
| ROI / ROAS | (特定渠道标签用户在其生命周期内产生的总营收) / 该渠道消耗总预算 | 决定企业生命线、后续买量预算倾斜方向与 CPA 智能调价的终极北极星指标 | 充值行为诡异地高度聚集在客单价最低档位的商品(疑似代充黑产团伙套利) |
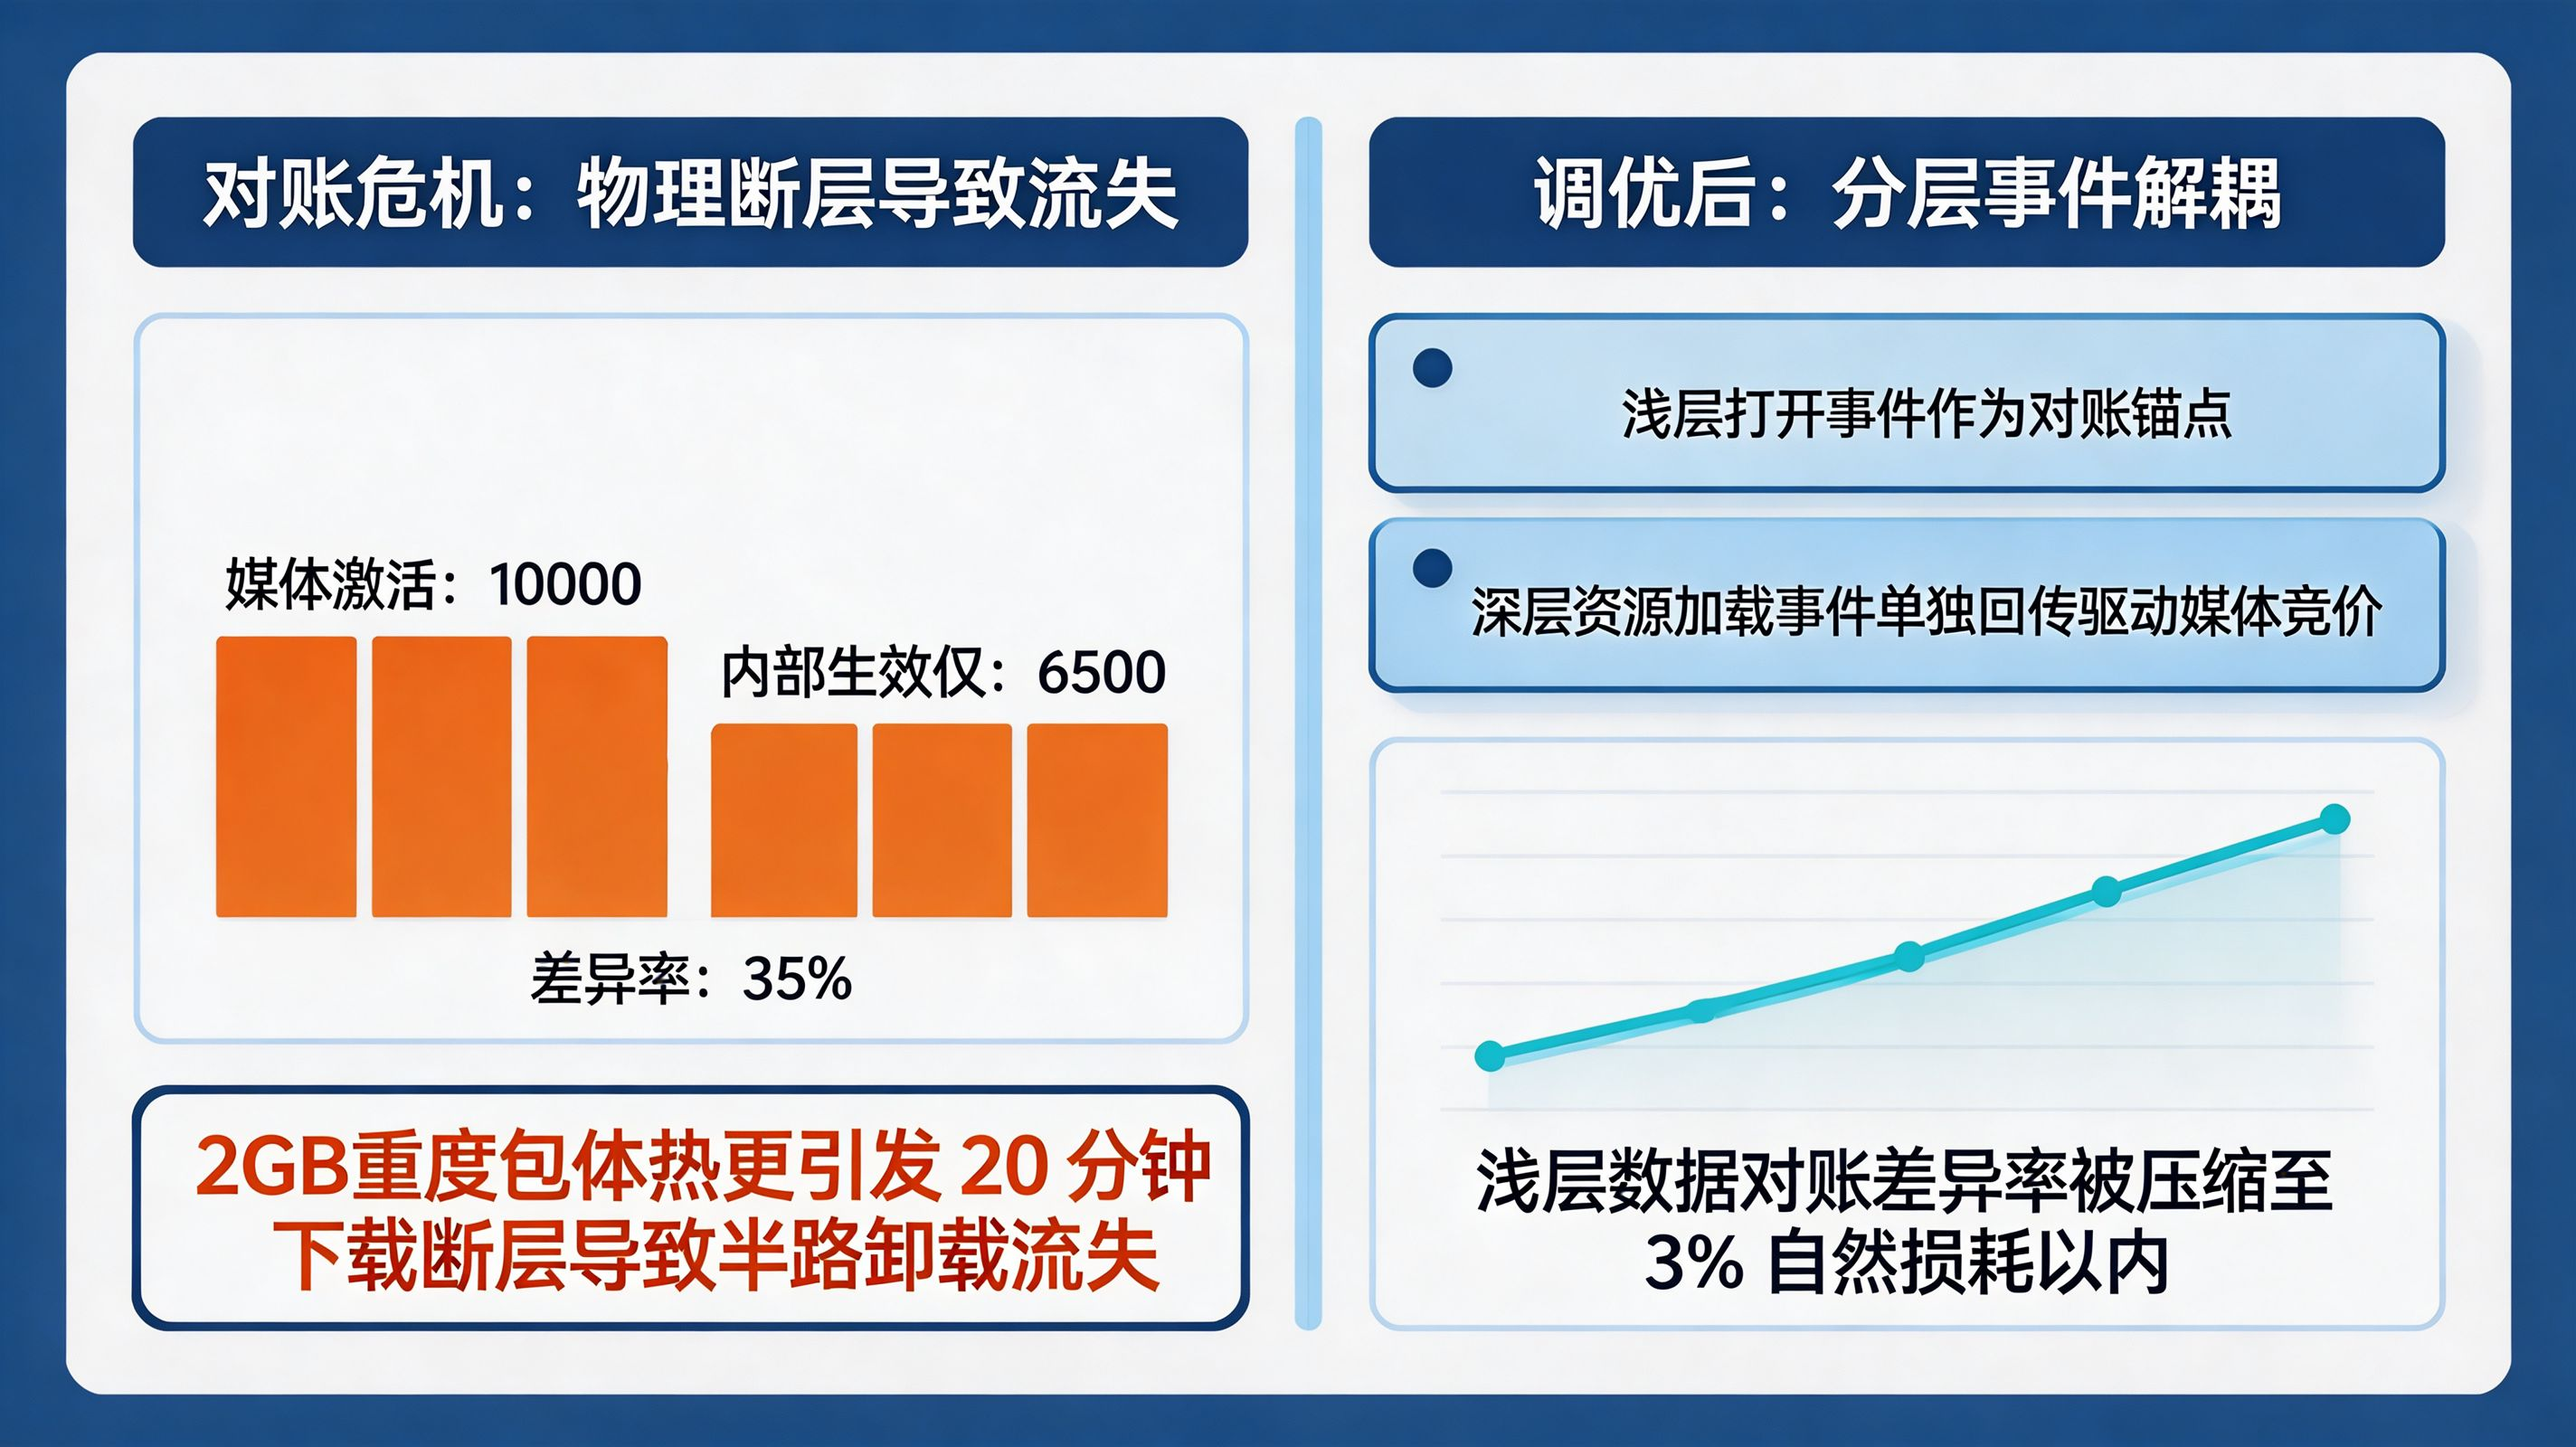
在日常的数据维护实战中,跨域对账引发的“悬案”往往能牵扯出惊人的底层物理断层。去年,某现象级重度手游的发行团队在复盘一次 S 级买量战役时遭遇了灾难性的对账危机。当他们观察“巨量引擎”某条消耗达百万元的高优计划看板时,惊悚地发现:昨天媒体平台的官方后台报表赫然显示带来了 10000 个激活用户,但是内部的 BI 核心看板(经由底层防作弊网关过滤后)仅仅统计到了 6500 个有效的渠道激活。高达 35% 的数据差异率瞬间引爆了投放代理商与内部技术团队的激烈对峙。
为了彻底查清这 3500 个“幽灵用户”的去向,数据架构小组火速切入了底层的物理对账流水。团队首先排除了最基础的误差陷阱:检查了服务器日志集群的 Nginx 访问节点,确认双方的时间戳均采用了标准的 GMT+8 格式,不存在按日切割的时区错位。紧接着,进行了时间轴归因窗口对账:比对了双方的归因时钟参数,尽管媒体平台采取了极度宽泛的 30 天回溯期,而内部看板锁定了更严格的 7 天 Last-Click(最后点击)倒退逻辑,但经过模拟演算,这一窗口期差异最多只能解释 5% 的偏移,剩下的 30% 依然是一个巨大的黑洞。
直到技术团队对“激活”这一业务概念进行抓包拆解时,核心的物理断层才终于浮出水面。原来,媒体平台为了尽快回传正向样本,将“用户在商店完成包体下载并触发首次安装系统广播”的瞬间,就粗暴地定义为了激活转化。然而,对于一款高达 2GB 的重度手游而言,内部统计 SDK 设定的真实激活触发点是埋在“用户冷启动进入游戏,完成漫长的 2GB 热更资源包拉取,最终成功加载出 Login 登录界面”的那一帧。这就意味着,在用户的手机终端上,从商店点击完成到真正进入游戏之间,横亘着一段可能长达 15 到 20 分钟的物理下载断层。在这漫长的网络等待期内,大量用户因为网络卡顿、内存不足或者失去耐心而直接杀死了后台进程并卸载,这批真实流失的流量被媒体算作了转化,却永远没有机会触发内部的 Login 埋点。(具体代码实现逻辑见文末部分 B)
针对确诊的架构级缺陷,团队引入了具备灵活多层事件解耦能力的 Xinstall 高级渠道统计中间件 进行强力调优。我们在客户端埋点架构中进行了巧妙的分流:新增了一个极度前置的 App_Cold_Opened(浅层打开)事件,专门上报给归因系统作为与媒体激活对账的基准锚点;同时,利用归因平台的 S2S 回传 API 接口,单独将极度深度的 Resource_Loaded(资源加载完成)高价值事件回传给媒体模型,专门用于驱动 OCPX 智能出价算法的精准收敛。这套“对账看浅层,出价看深层”的组合拳部署后,浅层数据的对账差异率被强力压缩至 3% 的自然损耗红线以内。这一架构升级彻底消除了财务审计与买量运营部门长久以来的跨域对账矛盾,让大盘看板上的每一行数据再次成为驱动千万级预算调拨的可信基石。
渠道统计看板上的数据为什么会有 1-2 小时的延迟?
这是一个经典的在数据精准度与算力成本之间博弈的技术命题。在底层的大数据流式计算架构中,一笔数据从客户端的埋点上报出发,需要经历网络通道抖动、打入 Kafka 缓冲队列进行削峰填谷,再交由 Flink 或 Spark 等流处理集群进行严苛的跨天状态关联、重复去重以及特征清洗,最后才能写入诸如 ClickHouse 这样的列式数据库供看板聚合查询。这种复杂管线的存在,是为了确保你看到的那个转化数字绝不包含虚假的重复请求。要想追求绝对的实时同步,其背后要求极其恐怖的内存计算开销;对于绝大多数追求财务级严谨的转化分析而言,接受合理的容错计算物理延迟是业界最优的工程平衡方案。
同一个用户点击了 A 渠道的广告,第二天又扫了 B 渠道的地推二维码安装,看板怎么算?
这就触及到了渠道分配体系中最核心的归因逻辑——Last-Click(最后一次有效点击)模型。在标准的归因状态机中,系统会根据用户时间轴上发生的所有触点,严格依据最近一次产生的有效交互参数进行业绩分配。因此,在此场景下,系统判定 B 渠道截断了转化旅程的终点,B 渠道会毫无争议地获得这次激活的 100% 独占归因。然而,为了不错杀任何一个优质的曝光源,顶级的统计看板通常会内置一个多维度的“辅助归因(Assisted Attribution)”视图。在这个下钻视图中,A 渠道虽然没有拿到最终的人头,但会被清晰地记录下一笔极具价值的“曝光助攻”得分,为全局投放策略提供全景依据。
如果企业的数据与开发团队期望彻底终结报表混乱的噩梦,建立起固若金汤的全渠道监测阵地,强烈推荐系统性地研读 Xinstall开发者全渠道集成文档 中关于数据回传校验与去重策略的章节。此外,对于期望深化数据模型认知的产品架构师,掘金技术社区里这篇剖析数据转化流失原理的长文 漏斗模型与行为设计提升转化率,同样是一份极具参考价值的学术资源。只有将最底层的埋点逻辑打磨到极致,企业才能在变幻莫测的买量市场中洞悉每一滴流量的真实去向。
 上一篇

DeepSeek 官宣 flash 系列降价?大模型加速端侧分发重构
2026-09-09
京东云拟建十万卡国产智算集群?国产 GPU 加速 AI 云分发重构
2026-09-09
英特尔 CPU 再涨 10%?Arm 阵营加速 IPC 与 IoT 芯片分发重构
2026-09-08
华为 Pura X View 上市?阔直板重构多端交互入口
2026-09-08
线下地推扫码如何归因?地推二维码追踪业绩统计与 ROI 评估
2026-09-07
华为麒麟 9050 Pro 回归?高性能芯片重构端侧 AI 分发生态
2026-09-07
KOL 达人营销如何归因?KOL 效果追踪分佣结算与 ROI 评估
2026-09-04
短信营销链接如何追踪?短信归因深度链接与转化统计
2026-09-04
全球首款 AI 智能体手机?努比亚 NaviX Ultra 加速端侧自主执行分发重构
2026-09-04
GPT-6 Astra 震撼发布?AGI 时代加速智能体自主执行重构分发链路
2026-09-04
社交分享裂变如何统计?分享统计关系链归因与效果评估
2026-09-03
Claude 支持后台操控 Mac?端侧自动接管桌面重构交互入口
2026-09-03
李飞飞发布首个世界模型?空间智能突破将颠覆多端 3D 分发
2026-09-03
广告点击到激活有延迟怎么办?广告监测数据排障与同步
2026-09-02
阿里云企业级 Agent 协作平台公测?万有无界加速智能体任务编排与分发
2026-09-02